系列 《深度学习基础:从反向传播到残差》 第 9 / 11 篇 入门
系列总览 — 为什么这样组织、读它需要什么、读完能做什么 · 幻灯片 — 整个系列的精华,一份可分享的 deck
学习地图 — AI 算法工程师学习地图 第 4 / 12 个系列
上一篇:CNN——从 LeNet 到 ResNet,再到 ViT下一篇:RNN——从 LSTM 到 attention 的诞生
词、token、用户 ID 都是离散编号;神经网络接收的却是向量。中间这一步查表,把一个编号变成什么?1
一、总览:从离散编号到可学习的表示
Embedding 把每个离散符号映射成一个可训练的稠密向量。模型再通过预测、重建或对比等目标,调整这些向量,让它们携带任务需要的信息。
Embedding 能嵌入的不只是词。句子、图像、位置、图里的节点、推荐系统里的用户 ID,都可以走同一条路:先有东西被嵌入,再有某种训练信号把向量摆到位。这篇覆盖这条路的全貌:
| 嵌入什么 | 代表方法 | 怎么得到向量 | 去处 |
|---|---|---|---|
| 词 | LSA、PPMI + SVD、GloVe、Word2Vec |
|
第四章、第五章 |
| 子词 / 词片 | fastText、BPE | 预测(随主任务训练) | 第六章 |
| 句子与文本 | Sentence-BERT、SimCSE、E5 / BGE |
|
第八章 |
| 图像 | ViT、CLIP |
|
第九章、《多模态(01):VLM 的结构(上):视觉编码器——CLIP、SigLIP 与自监督 ViT》 |
| 位置 | 正弦编码、RoPE |
|
第九章、《现代 LLM 结构(03):位置编码与外推》 |
| 图节点与实体 | DeepWalk、node2vec、TransE |
|
第九章 |
| ID 与类别特征 | 矩阵分解、双塔 |
|
第九章 |
同一张图画出来。读法:左列是嵌入的对象,中列是得到向量的七种信号,箭头表示「这种对象用过这种信号」:
这篇先从 one-hot 与查表出发,第二、三章立住 embedding 表和分布式假设;第四到八章以词为主线往下走——计数式分解(第四章)、预测式词向量(第五章)、子词方法(第六章)、随上下文变化的表示(第七章)、句子级表示(第八章);第九章换一条轴,把对象铺开;第十章再换一个角度,把前面所有方法按训练信号归类。实验还是用完整 text8 训练 skip-gram 模型收尾。
还有一件容易和「信号」混着看的事:同一个词在所有上下文里只有一个向量(静态),还是随句子变(上下文相关),是架构属性,不是信号——ELMo 与 Word2Vec 用的是同一种预测信号,只是架构从查表换成了 LSTM。第七章专门讲这条线。
1. 本文的章节安排
| 章 | 主题 | 要回答的问题 |
|---|---|---|
| 二 | one-hot 与 embedding 表 | 编号怎样查成向量,梯度更新哪一行? |
| 三 | 分布式假设 | 为什么共享上下文的词会靠近? |
| 四 | 计数式:LSA、PPMI + SVD 与 GloVe | 不训练网络,能不能直接算出词向量? |
| 五 | Word2Vec | skip-gram、CBOW 与负采样如何训练词向量? |
| 六 | 子词与开放词表 | 词表外的词怎么办? |
| 七 | 从静态到上下文 | 同一个词为什么能有不同表示? |
| 八 | 句子与文本 embedding | 一整句话怎么变成一个向量? |
| 九 | 词以外的对象 | 位置、图像、图节点、ID 怎么嵌入? |
| 十 | 表示学习的监督信号 | 五种目标分别在学什么? |
| 十一 | 工程取舍 | 词表大小、稀疏梯度与相似度检索有什么代价? |
| 十二 | text8 案例 | CPU 训练后的近邻和类比会怎样变化? |
| 十三–十四 | 小结与自测 | 把整条链路收起来,再检查理解 |
2. 来龙去脉
| 年 | 谁 | 当时的问题 | 怎么解决 | 效果 | 引入或遗留问题 |
|---|---|---|---|---|---|
| 1954–1957 |
|
词的意义怎么形式化 | 分布假设:词的使用环境能提供关于词的信息 | 成为后来一切分布式表示的思想源头 | 只是语言学观点,没有给出可计算的向量 |
| 1990 | Deerwester 等 | 词-文档共现矩阵太大太稀疏 | LSA:对共现矩阵做 SVD,取前几维当词的表示 | 词与文档第一次有了低维语义坐标 | 计数稀疏、窗口全局混合,向量仍粗糙 |
| 2003 | Bengio 等 | 词表是离散编号,词与词之间没有几何 | 神经概率语言模型:把词的分布式向量与语言模型一起学习 | 词向量第一次作为模型参数被学出来 | 全词表 softmax 太贵,静态词向量还没普及 |
| 2013 | Mikolov 等 | 联合训练太慢,词向量训不起 | Word2Vec:skip-gram、CBOW 加负采样,把训练成本降下来 | 静态词向量在 CPU 上也能训出来,成为标配工具 | 向量不随上下文变化,多义词只有一行 |
| 2013 | Bordes 等 | 知识图谱里的实体和关系也要进向量空间 | TransE:让 \(h + r \approx t\),用间距损失学 | 结构化知识第一次能用向量做链路预测 | 一对一关系好建,一对多、多对多关系失真 |
| 2014 | Pennington 等 | Word2Vec 只看局部上下文窗口 | GloVe:把全局词共现统计纳入向量学习 | 词向量的几何结构里出现了可解释的线性关系 | 仍是静态向量,上下文无关 |
| 2014 / 2016 |
|
图节点没有文本,怎么嵌入 |
|
图结构直接被翻译成词向量问题 | 只能给训练时见过的节点向量,新节点要重训 |
| 2017 | Bojanowski 等 | 罕见词与形态变化没有向量 | fastText:把字符 n-gram 纳入词表示 | 罕见词、拼写变体也能合成向量 | 仍是静态向量,上下文无关 |
| 2018–2019 | ELMo、GPT、BERT | 静态词向量不随上下文变化 | 表示由整句上下文决定,不再查词表里固定的一行 | 上下文表示取代静态词向量成为主流 | embedding 层退化为输入接口,表示工作交给后面的网络 |
| 2019 | Reimers & Gurevych | BERT 输出的句向量直接拿来比效果不好,逐对编码又太慢 | Sentence-BERT:siamese 结构把每个句子单独编码成一个向量 | 句向量检索从小时级降到毫秒级,SBERT 成为句向量的标准做法 | 需要标注的句对数据 |
| 2021 | Gao 等 | 句向量各向异性,没有标注对怎么办 | SimCSE:同一句子过两次 dropout 当正例,batch 内互作负例 | 无监督句向量效果逼近有监督 | 正例只来自 dropout 噪声,语义偏差有限 |
| 2021 | Radford 等 | 图像和文本能不能进同一个向量空间 | CLIP:4 亿图文对做对比学习,对齐两个模态的向量 | 零样本分类、图文检索都靠这个共享空间 | 跨模态空间对齐粒度粗,细节靠后接模型补 |
| 2022 | Wang 等 | 各家句向量各训各的,检索任务缺少通用品 | E5:大规模弱监督文本对 + query:/passage: 前缀区分两侧 |
一个模型覆盖检索、聚类、语义相似度 | 前缀约定成了新负担,换模型要记得换前缀 |
Harris 在 《Distributional Structure》 中研究词项的分布环境;Firth 在 《A synopsis of linguistic theory 1930–1955》 中写下常被引用的“知道一个词,要看它与哪些词为伴”。这是一条从统计共现到神经网络表示的线索,不表示后来所有 embedding 都采用同一种目标函数。
Bengio 等人的 神经概率语言模型 同时学习词的分布式表示和词序列概率。之后,Word2Vec、GloVe 与 fastText 分别发展出不同的训练信号或统计形式。
表示的另一条变化是:从“词表中每个词只有一行”,走到“每次出现的 token 都能根据上下文改变”。ELMo 用双向语言模型内部状态生成上下文表示;GPT-2 与 BERT 则把 Transformer 的隐藏状态用于上下文建模。
二、one-hot 与 embedding 表
假设词表只有“猫、狗、跑”三个词。one-hot 用一个与词表等长的向量表示词 ID:
| 词 | one-hot |
|---|---|
| 猫 | \([1,0,0]\) |
| 狗 | \([0,1,0]\) |
| 跑 | \([0,0,1]\) |
向量维度等于词表大小 \(V\)。任意两个不同词的内积都是 0,表示本身不提供“猫比跑更像狗”这样的相似度。
Embedding 表 \(E\in\mathbb{R}^{V\times d}\) 为每个词保存一行。查词 ID \(i\) 就取第 \(i\) 行:
\[\operatorname{Embedding}(i)=E_i.\]这也等价于 one-hot 行向量乘表:
\[\operatorname{onehot}(i)^\top E=E_i.\]实现时不必真的构造长度为 \(V\) 的 one-hot 向量;nn.Embedding 直接按 ID 查表。
反向传播时,只有被查到的行会收到非零梯度。下面用 sparse=True 让 PyTorch 把梯度实际存成稀疏张量;重复查到 ID 2 时,该行的梯度会累加两次。
import torch
from torch import nn

table = nn.Embedding(5, 2, sparse=True)
table(torch.tensor([0, 2, 2])).sum().backward()
print(table.weight.grad.coalesce().indices()[0].tolist())
print(table.weight.grad.coalesce().values())
输出的索引只有第 0、2 行。默认 sparse=False 时梯度张量是稠密的,只是未查到的行数值为零;两种情况不要混为一谈。
tokenizer 与 embedding 表:谁给谁什么
读者常问 embedding 和 tokenizer 是什么关系,其实是流水线上的两道工序:
- 文本 → token ID:tokenizer 先把字符串切成 token 并编号。GPT-2 的 BPE 把 “Embedding” 切成
Embedding三段,编号 31567、6048、278——词表外的词不存在,只会被拆得更碎。 - token ID → 向量:embedding 层拿 ID 查表,每个 ID 取出一行 \(d\) 维向量。
几点容易混的地方:
- tokenizer 是先训练再冻结的。BPE 的训练是数相邻符号对的合并次数,没有梯度、没有网络;冻结之后它只是一件查表工具。词表大小 \(V\) 就是 embedding 表的行数。
- 两者是绑死的。换一个 tokenizer,编号全变,原来的表就是一堆没有意义的行。
- 加特殊 token 就是加行。给 chat template 加
<|im_start|>这类记号时,要在表尾追加新行并初始化、随训练学出来。 - 词这个单位是会移动的。Word2Vec 时代用空格切词再按频率截断词表;第六章会看到 fastText 与 BPE 怎么把这条边界模糊掉。五种文本表示方式的对照见《预训练(02):分词与词表:BPE、词表大小与 token 效率》「2. 文本怎么变成数字:五种表示方式,以及 LLM 为什么选”子词 + embedding”」。
GPT-2 的词表矩阵有多大?
GPT-2 的配置 给出词表大小 \(V=50{,}257\)、隐藏维度 \(d=768\)。仅输入 embedding 表就有:
\[50{,}257\times768=38{,}597{,}376\]个参数。GPT-2 small 总参数约 124M,因此这张表约占 31%。词表参数不是可以忽略的“索引开销”。
GPT-2 把输入词向量矩阵与输出词表投影共享。给定最后隐藏状态 \(h\),词 \(w\) 的输出 logit 是:
\[\operatorname{logit}(w)=h^\top E_w.\]同一行既作为输入词的表示,也作为输出分类器对应词的方向;共享权重减少一张词表矩阵,并让输入与预测端共用统计。这个做法叫 weight tying,Press 与 Wolf 2017 最早在语言模型上系统验证了它。Hugging Face 的 GPT-2 模型配置与 模型实现 采用 tying;nanoGPT 也在 模型代码 中显式把 lm_head.weight 设为 wte.weight。
三、分布式假设:从共同上下文中学相似度
Word2Vec 的直觉是:如果两个词经常出现在相似的上下文里,它们的向量就应该相似。向量不再只是 ID 的编码,而是从共现数据里学出的分布式表示。
以“猫追着球跑”和“狗追着球跑”为例,猫与狗都出现在“追着球跑”附近。预测上下文的训练会把它们的向量都往能预测这些上下文的方向推。共同的邻居因此会在向量空间里形成共同方向。
这不是说两个词完全同义,也不是说语料里的偏见会自动消失。模型学到的是训练数据和目标函数所奖励的统计规律。
四、计数式:LSA、PPMI + SVD 与 GloVe
在神经网络之前,词向量已经可以“算”出来:先数共现,再把矩阵分解掉。这条线没有训练循环,只有统计量和线性代数。
1. 一个可以手算的 toy 语料
拿一个七句话的小语料:「猫 狗 吃 鱼」「狗 猫 吃 鱼」「猫 追 球」「狗 追 球」「狗 吃 球」「猫 睡」「狗 睡」。词表七个词。窗口取相邻的两个词,数出对称共现矩阵 \(X\)(\(X_{ij}\) 是词 \(i\) 与词 \(j\) 相邻出现的次数):
| 猫 | 狗 | 鱼 | 球 | 追 | 吃 | 睡 | |
|---|---|---|---|---|---|---|---|
| 猫 | 0 | 2 | 0 | 0 | 1 | 1 | 1 |
| 狗 | 2 | 0 | 0 | 0 | 1 | 2 | 1 |
| 鱼 | 0 | 0 | 0 | 0 | 0 | 2 | 0 |
| 球 | 0 | 0 | 0 | 0 | 2 | 1 | 0 |
| 追 | 1 | 1 | 0 | 2 | 0 | 0 | 0 |
| 吃 | 1 | 2 | 2 | 1 | 0 | 0 | 0 |
| 睡 | 1 | 1 | 0 | 0 | 0 | 0 | 0 |
共现次数本身受词频支配:高频词跟谁都容易撞上。要看的是共现比独立假设下多出多少,这就是点互信息(PMI):\(p_{ij}=X_{ij}/N\) 是观测到的共现概率(\(N\) 是矩阵里所有计数之和,本例 \(N=28\)),\(p_i=\sum_j X_{ij}/N\) 是词 \(i\) 单独出现的概率。
\[\operatorname{PMI}(i,j)=\log_2\frac{p_{ij}}{p_i\,p_j},\qquad \operatorname{PPMI}(i,j)=\max(0,\operatorname{PMI}(i,j)).\]PMI 大于 0 表示共现多于随机预期,小于 0 表示少于。PMI 出自 Church & Hanks 1990;负值在稀疏数据里噪声很大,把负值截成 0 的 PPMI 用在词向量上的效果,Bullinaria & Levy 2007 系统比较过。对上面的矩阵取 PPMI:
| 猫 | 狗 | 鱼 | 球 | 追 | 吃 | 睡 | |
|---|---|---|---|---|---|---|---|
| 猫 | 0 | 0.90 | 0 | 0 | 0.49 | 0 | 1.49 |
| 狗 | 0.90 | 0 | 0 | 0 | 0.22 | 0.64 | 1.22 |
| 鱼 | 0 | 0 | 0 | 0 | 0 | 2.22 | 0 |
| 球 | 0 | 0 | 0 | 0 | 2.22 | 0.64 | 0 |
| 追 | 0.49 | 0.22 | 0 | 2.22 | 0 | 0 | 0 |
| 吃 | 0 | 0.64 | 2.22 | 0.64 | 0 | 0 | 0 |
| 睡 | 1.49 | 1.22 | 0 | 0 | 0 | 0 | 0 |
现在每个词是一个七维向量。猫与狗的行最像:它们直接共现,又共享「追」「睡」这两个上下文。鱼和球则各只连着一两个动词。LSA(Deerwester 等 1990)的做法是:对这张表做截断 SVD,只留最大的几个奇异方向。SVD 的分解式与取前几维的含义见《算法工程师的数学(03):正交与旋转、特征值与 SVD——从 RoPE 到 LoRA》「四、秩与 SVD · 2. SVD:任何矩阵都能这样分解」。留两维,把 PPMI 矩阵分解为 \(P\approx U\Sigma V^\top\),取 \(U\) 的前两列乘 \(\sqrt{\Sigma}\) 当坐标,得到:
图里猫和狗的距离(0.17)明显小于它们各自到物体名词的距离(狗到鱼 0.42、狗到球 0.49、猫到鱼 0.58、猫到球 0.67)。共享上下文的词在几何上靠近,这个 toy 语料演示的就是这件事。这一整步没有梯度、没有训练,只有数数和分解;矩阵分解作为降维手段的来龙去脉见《LLM 时代的经典机器学习(08):降维——PCA、SVD、t-SNE / UMAP 与 embedding 的各向异性》「四、三个名字一件事」。
2. GloVe:把计数塞进一个回归
GloVe(Pennington 等 2014)不再显式分解矩阵,而是直接拟合共现的对数。词 \(i\) 与 \(j\) 的向量 \(w_i\)、\(\tilde w_j\) 满足:
\[J=\sum_{i,j}f(X_{ij})\bigl(w_i^\top \tilde w_j+b_i+\tilde b_j-\log X_{ij}\bigr)^2.\]\(w_i\) 是词作为中心词时的向量,\(\tilde w_j\) 是它作为上下文词时的向量,\(b_i,\tilde b_j\) 是对应的偏置;\(f(X_{ij})\) 是加权函数,给中等频次的共现更大权重、给极稀有和极常见的共现压低权重。原论文取的分段函数是
\[f(x)=\begin{cases}(x/x_{\max})^{\alpha},&x<x_{\max},\\1,&x\ge x_{\max},\end{cases}\]其中 \(x_{\max}=100\)、\(\alpha=3/4\)。目标的意思是:两个向量的点积应该预测它们共现次数的对数——计数没有被丢掉,只是从「分解的输入」变成了「回归的目标」。
五、Word2Vec:预测邻居,还是预测中心词
上一章用分解共现矩阵直接算向量,Word2Vec 换了一条路:设一个预测任务,把向量当参数学出来。
它的两个常见目标只是在输入、预测方向上不同:
| 目标 | 输入 | 预测 |
|---|---|---|
| skip-gram | 中心词 | 窗口内的上下文词 |
| CBOW | 上下文词向量的平均 | 中心词 |
以句子“猫 追着 球 跑”为例,窗口半径为 1 时,skip-gram 会从“追着”预测“猫”和“球”;CBOW 则把“猫”和“球”的向量合起来,预测“追着”。Word2Vec 原论文 讨论了这两种架构。
1. 为什么不直接对整个词表做 softmax
给定中心词向量 \(v_c\),模型要为词表中每个候选上下文词计算分数:
\[s_w=v_w^{\prime\top} v_c,\qquad P(w\mid c)=\frac{\exp(s_w)}{\sum_{u\in V}\exp(s_u)}.\]词表每增加一个词,就多算一个长度为 \(d\) 的点积。取 \(V=50{,}000\)、\(d=300\),单个中心词一次全词表打分约需 \(2Vd=30\) 百万 FLOPs;批量与 softmax 归一化还会增加工作量。
Mikolov 等人在 《Distributed Representations of Words and Phrases and their Compositionality》 中采用负采样。先补一件上面没说清的事:Word2Vec 维护的是两张 embedding 表——输入表 \(v_w\) 是词当中心词时查的行,输出表 \(v^{\prime}_w\) 是词当上下文候选时查的行;上面 softmax 那个昂贵的归一化,就是要对输出表的全部 \(V\) 行各算一个点积。负采样把它换成一个二分类:真实样本 \((c,o)\)(中心词 \(c\)、真实上下文词 \(o\))把 \(v^{\prime}_o\) 与 \(v_c\) 的点积推高,再抽 \(k\) 个「噪声词」\(n_1,\ldots,n_k\),把 \(v^{\prime}_{n_j}\) 与 \(v_c\) 的点积压低:
\[-\log\sigma(v_o^{\prime\top} v_c) -\sum_{j=1}^{k}\log\sigma(-v_{n_j}^{\prime\top} v_c),\]其中 \(\sigma(x)=1/(1+e^{-x})\) 是 sigmoid 函数,把点积压成 0 到 1 之间的概率。每个样本只算 \(k+1\) 个点积。
负样本按噪声分布 \(P_n(w)\propto f(w)^{3/4}\) 抽,\(f(w)\) 是词在语料里的频次。叫它「负」是因为抽中的词几乎不可能是真的上下文。取 3/4 次幂是 Mikolov 等人试出来的:它把分布压平,低频词被抽到的机会比原频率高,「的」这类超高频词被压低。拿两个词算一遍:假如「的」的频率是 0.05、「猫」是 0.0005,原始频率差 100 倍;各取 3/4 次幂后 \(0.05^{0.75}\approx0.106\)、\(0.0005^{0.75}\approx0.0034\),只差约 31 倍。\(k\) 的建议值是小语料 5–20,大语料 2–5。
具体看一个样本:中心词「追」、正样本上下文「猫」,抽 5 个负样本「球、狗、鱼、跑、睡」。随机初始化两张 \(d=8\) 的表、跑 15 步 SGD,各对的 \(\sigma\) 分数如下(数字由 case_09_concept_figures.py 算出):
若 \(d=300\)、\(k=5\),每个正样本是 6 个点积,约 3,600 FLOPs,而不是 3,000 万量级。
2. 二维手算与类比
先看一组特意构造的二维向量:
\[\text{man}=(1,0),\quad \text{woman}=(1,1),\quad \text{king}=(2,0),\quad \text{queen}=(2,1).\]于是:
\[\text{king}-\text{man}+\text{woman} =(2,0)-(1,0)+(1,1)=(2,1)=\text{queen}.\]这只是为了看清向量加减如何表达关系的手算例子,不是任何真实模型跑出的结果。
真实向量里常用余弦相似度检索候选。做类比时必须把输入的原词排除,否则“king”或“woman”可能因本身与查询向量相似而占住结果。即使排除了它们,类比也只是某种检索行为,并不能证明关系在语言或社会意义上成立。Nissim 等人 指出,经典词向量类比对偏见的诊断并不可靠,数据、实现与选择会影响看起来“惊艳”的例子。
3. 负采样与 PMI 的联系:两条路在同一个地方汇合
负采样训练出的点积还可以从矩阵角度理解。Levy 与 Goldberg 在 2014 年的分析 中证明,在特定假设下,skip-gram with negative sampling(SGNS)隐式分解一个 shifted PMI 矩阵:词与上下文共现越出乎独立分布的预期,它们的点积越大。
也就是说,第四章「计数 → PMI → 分解」和这一章「预测任务 + 负采样」学的是同一张统计表,只是一个显式分解它,一个隐式拟合它。GloVe 干脆把它当回归目标直接拟合。矩阵分解与低维投影的联系可见《LLM 时代的经典机器学习(08):降维——PCA、SVD、t-SNE / UMAP 与 embedding 的各向异性》「四、三个名字一件事」。
六、子词与开放词表:fastText、BPE 与 hashing
到目前为止,表的一行对应词表里的一个词。这留下两个洞:词表外的词(OOV)查不到任何一行;词表越大,行数与参数越多。这一章是补这两个洞的三条路。
1. fastText:词是字符 n-gram 的和
Bojanowski 等人 2017 的做法是不给词一个原子行,而把词拆成字符 n-gram,词的向量是它所有 n-gram 向量之和。取 \(n=3\)、词 where,拆出的 n-gram 是 <wh、whe、her、ere、re>,另外加上整词序列 <where>(<、> 是词首尾标记)。实际用法里 n 取 3 到 6,一个词就是几十个子串的和。训练照常跑 skip-gram,只是查表前先查 n-gram。词表外的词只要由见过的 n-gram 组成,也能合成一个向量。代价:n-gram 表本身很大,通常再用 hashing 压进固定大小的桶。
2. BPE:把「词」变成「词片」
另一条路是根本不用整词当单位。BPE 反复合并语料里频率最高的相邻符号对,得到固定大小的子词词表;罕见词被拆成若干子词,OOV 在分词那层就消失了。embedding 层仍然只是一张表,只是行从「词」变成「词片」。合并过程与词表大小的权衡见《预训练(02):分词与词表:BPE、词表大小与 token 效率》;LLM 里的 embedding 层查的就是这种子词 ID。
3. hashing trick:共享桶代替长表
再激进一点,可以不要词表。Weinberger 等人 2009 的 feature hashing 把任意特征(词、n-gram、类别取值)哈希进固定数量的桶,每个桶共享一行向量。优点是不需要词表、天然处理开放词表;代价是碰撞——不同的词被压进同一行、不可区分。hash embedding(Svenstrup 等 2017)给每个词配多个哈希函数、把命中向量加权求和,来缓解碰撞。推荐系统里的超大 ID 表常用这类结构,见第九章。
七、从静态词向量到上下文表示
静态词向量为一个词类型保存一行。“银行”出现在“河岸边”与“银行存款”里,查到的仍是同一个向量;向量本身无法区分这两种上下文。
ELMo 把双向语言模型每层的状态组合成 token 表示。Transformer 语言模型则让 token 表示经过多层 attention 和 FFN 后,逐层带上上下文信息。
因此,词表里的输入 embedding 只是第 0 层表示;模型内部每个位置的 hidden state 也是一个上下文 embedding。Transformer 中输入 embedding 的具体路径见《Transformer 原理与实现(01):Transformer 长什么样——从一句话到下一个 token》「token embedding:把编号变成向量」。
第二章的 GPT-2 例子已经出现过 weight tying:输入表与输出投影共享同一组权重,查表和打分用的是同一张表。Press 与 Wolf 2017 在语言模型上系统验证过这个做法:共享之后困惑度没有上升反而下降,模型还少带一张词表矩阵。
tokenizer 与 embedding 表的分工(谁切词、谁查表)第二章「tokenizer 与 embedding 表」一节已经说过,这里只看表示层面的变化。
八、句子与文本 embedding
词向量之后,自然的问题是:一整句话怎么变成一个向量,用来做检索、聚类、相似度判断?这一章看几种主流做法。
1. 为什么朴素平均和裸 CLS 不行
最简单的做法是把句子里各词的向量取平均。它能用,但很弱:高频词的向量把平均拉向公共方向,句子特有的信息被稀释。直接拿 BERT 的 [CLS] 或最后层 hidden state 平均也一样不好,因为 BERT 为下一句判断训练出的 [CLS] 不是为相似度检索设计的,而且它的表示空间各向异性严重:所有句向量挤在锥形里,余弦相似度普遍偏高,区分度差。各向异性的诊断见《LLM 时代的经典机器学习(08):降维——PCA、SVD、t-SNE / UMAP 与 embedding 的各向异性》「embedding 的各向异性」。
2. Sentence-BERT:把句向量当检索目标训练
Reimers & Gurevych 2019 的 Sentence-BERT 用两个共享权重的 encoder(siamese / bi-encoder)分别编码两个句子,在句对任务(NLI、STS)上微调后,把每个句子的向量(通常取 mean pooling)用余弦直接比。它解决两件事:句向量第一次被「为相似度训练」而不是借用 CLS;每个句子单独编码,可以离线算好存起来,检索时只做一次点积。
3. SimCSE:dropout 就是数据增强
Gao 等 2021 的 SimCSE 证明不需要标注对:把同一句子用不同的 dropout mask 过两遍 encoder,两次输出互为正例,batch 里其他句子互为负例,用 InfoNCE 目标即可。无监督版本的效果在 STS 上接近甚至超过一些有监督基线,把句向量训练的门槛降到一个 encoder + 一批句子。
4. E5 / BGE 一族:弱监督对 + 前缀约定
Wang 等 2022 的 E5 改用海量弱监督对(Reddit 问答、维基标题-正文、StackExchange 等)做对比预训练,再用小量标注微调。它引入的一个约定至今还在用:查询侧文本前加 query:、文档侧加 passage:,靠前缀区分两侧分布。BGE、GTE 等后续模型沿用同样的配方。
5. 两个实用细节
- decoder 模型做 embedding:GPT 类 decoder 是因果的,前面位置看不到后面,取句向量用最后一个 token 的 hidden state(last-token pooling)而不是平均。
- Matryoshka 表示学习(Kusupati 等 2022):训练时同时优化向量多个前缀维度上的目标,使前 64 / 128 / 256 维都是可用的完整表示,部署时按需截断,省存储和检索时间。
选模型、看 MTEB 榜、以及 embedding 模型在检索链路里的位置,见《检索与知识接入(04):索引、混合检索与 rerank》「二、embedding 模型」。
九、词以外的对象:位置、图像、图与 ID
Embedding 不只嵌入词。凡是「离散、数量大、需要被模型连续处理」的对象,都可以放一张表或一个映射函数。下面每块一个对象。
1. 位置
- 问题:Transformer 的 attention 对输入顺序不敏感,模型需要「第几个」这个信息。
- 怎么解决:把位置 \(t\) 也嵌入成向量加进 token 表示。可以是可学习的表,也可以是固定的正弦编码或旋转位置编码(RoPE)。
- 效果:RoPE 已成主流。
- 遗留问题:外推与长上下文是它现在的主要问题。为什么需要位置编码、各路方案怎么选,见《现代 LLM 结构(03):位置编码与外推》「二、为什么需要位置编码」。
2. 图像
- 问题:像素不是离散符号,但 Transformer 需要 token。
- 怎么解决:把图切成 patch,每个 patch 线性投影成向量。patch embedding 等价于步长等于核大小的卷积;CLIP 再用图文对比把图像和文本放进同一个空间。
- 效果与遗留问题:切图的过程见《深度学习基础(08):CNN——从 LeNet 到 ResNet,再到 ViT》「六、从 CNN 到 ViT · 2. ViT 的结构」,CLIP 与 ViT 在多模态里的用法见《多模态(01):VLM 的结构(上):视觉编码器——CLIP、SigLIP 与自监督 ViT》「二、ViT 回顾:编码器输出的是什么」。
3. 图节点与知识图谱实体
- 问题:图里的节点没有「词表」也没有序列顺序。
- 怎么解决:DeepWalk(Perozzi 等 2014)在图上做随机游走,把游走序列当句子、节点当词,直接跑第五章的 skip-gram;node2vec(Grover & Leskovec 2016)再加有偏游走控制偏向 BFS(邻域同质)还是 DFS(结构角色)。知识图谱的实体和关系则用 TransE(Bordes 等 2013):要求 \(h + r \approx t\)(头实体向量 + 关系向量 ≈ 尾实体向量),用 margin 排序损失训练。
- 效果:图结构被翻译成了词向量问题;TransE 能预测缺失的链接。
- 遗留问题:DeepWalk / node2vec 是 transductive 方法,图里加一个新节点就得重新游走、重新训练;GraphSAGE(Hamilton 等 2017)这类 inductive 方法才解决这个问题。TransE 对一对一关系好用,一对多、多对多、对称关系会失真。
4. 推荐里的 ID 与类别特征
- 问题:推荐系统输入是一堆 ID(用户、商品、品类、城市),每个都可能是百万级词表。
- 怎么解决:每个 ID 一张 embedding 表。也可以用矩阵分解(把用户-物品交互矩阵分解出两组向量)或双塔模型(用户塔、物品塔各自输出一个向量,线上做内积检索)。
- 效果:ID 直接进了向量空间,召回可以用内积检索。
- 遗留问题:成本集中在表的大小上。一张 10 亿行、64 维、fp32 的表就是 \(10^9\times64\times4\text{ B}=256\text{ GB}\),单机放不下,必须分片、量化或用第六章的 hashing 压缩。
十、表示学习的五种监督信号
“表示学习”不是一个固定网络结构,而是用某种训练目标,让向量保存对任务有用的信息。本文的方法按信号数其实有七种:第四章的计数分解不占梯度、不进这张表,位置的固定公式(正弦、RoPE)根本不学——剩下的五种都靠梯度训练,差别在监督从哪里来。五种信号的输入与目标画在一排:
1. 预测。 给一部分,预测缺的那部分。自回归语言模型(GPT)预测下一个 token:\(-\log P(x_t\mid x_{<t})\);掩码模型(BERT、MAE)盖住中间一块,用两侧内容预测被盖位置。模型为了完成预测,会把有助于区分目标的特征写进向量里。Word2Vec 与全部语言模型都在这一类。
2. 重建。 自编码器先把输入压进较窄的 latent,再从 latent 重建输入:
\[x\longrightarrow z=f_\theta(x)\longrightarrow \hat x=g_\phi(z), \qquad \mathcal{L}_{\text{rec}}=\lVert x-\hat x\rVert^2.\]瓶颈迫使表示保留足以重建输入的信息。VAE 在此基础上约束 latent 分布,详见《多模态(08):Latent diffusion、DiT 与文生图配方》「VAE 的结构与训练」。
3. 对比。 给定正样本对与一批负样本,让正样本相似度高于负样本。van den Oord 等人在 CPC 原论文 中使用 InfoNCE;一个常见形式是:
\[\mathcal{L}_{\text{NCE}} =-\log\frac{\exp(s(q,k^+)/\tau)} {\exp(s(q,k^+)/\tau)+\sum_j\exp(s(q,k_j^-)/\tau)}.\]这里 \(q\) 是查询,\(k^+\) 是匹配对象,\(k_j^-\) 是负样本,\(\tau\) 控制 softmax 的尖锐度。SimCSE、CLIP 走的就是这条路;InfoNCE 的推导与温度细节见《深度学习基础(02):损失函数——怎样把「好」写成一个可求导的数》「六、对比与度量学习」,互信息与 InfoNCE 的关系见《算法工程师的数学(06):熵、交叉熵与 KL——从困惑度到 DPO》「互信息与对比学习」,图文对比的 CLIP 例子见《多模态(01):VLM 的结构(上):视觉编码器——CLIP、SigLIP 与自监督 ViT》「InfoNCE」。
4. 无负样本的自蒸馏。 对比的麻烦是需要大量负样本。BYOL(Grill 等 2020)与 DINO(Caron 等 2021)干脆不要负样本:同一输入做两个增广视图,student 网络预测 teacher 网络的输出。这本来会塌缩成常数解(所有输入输出同一个向量),两家用相似的手段避免:BYOL 给 student 加一个 predictor、并给 teacher 用 student 的指数滑动平均(EMA)+ stop-gradient;DINO 给 teacher 输出做中心化与锐化。
5. 有监督。 用人工标注当信号:ImageNet 分类预训练出的特征长期是视觉表示的默认起点;度量学习(triplet loss、有监督对比)让同类样本在空间里聚得更紧。
五种信号摆在一起:
| 信号 | 需要什么数据 | 学到什么 | 常见问题 |
|---|---|---|---|
| 预测 | 序列 / 被盖住的输入 | 让表示能推出邻居 |
|
| 重建 | 原始输入 | 保留足以还原输入的信息 | 容易被像素级细节占满,高维语义不突出 |
| 对比 | 正例对 + 一批负例 | 把相似样本拉到一起 |
|
| 自蒸馏 | 同一输入的增广视图 | 不要负例也能拉开表示 | 塌缩风险,靠 EMA / predictor / 中心化撑着 |
| 有监督 | 人工标签 | 表示直接服务标注任务 | 受标注覆盖与偏见限制 |
十一、工程取舍:词表、维度与优化器状态
词表大小 \(V\) 与向量维度 \(d\) 一起决定 embedding 参数量 \(Vd\)。词表越大,能直接表示的离散符号越多;维度越高,每行容量越大,但参数与优化器状态也随之增加。
| 模型 | 配置中的 \(V\times d\) | 输入 embedding 参数 | 总参数约数 | 输入表占比 |
|---|---|---|---|---|
| GPT-2 small | \(50{,}257\times768\) | 38.6M | 124M | 31.0% |
| Llama 3 8B | \(128{,}256\times4{,}096\) | 525.3M | 8.03B | 6.5% |
GPT-2 的配置来自 Hugging Face 模型配置。Llama 3 8B 的模型设置见 Meta 技术报告 与 官方 Hugging Face 配置,架构定义见 Meta 官方实现。按该配置的层数、注意力与 FFN 矩阵形状合计约 8.03B 参数;官方实现将输入 embedding 与输出投影分别定义,因此输出词表矩阵还占约 6.5%。
词频差异也会影响更新频率:高频词的行每一步都可能更新,罕见词则很少被访问。PyTorch 的 nn.Embedding(sparse=True) 能产生稀疏梯度,但标准 AdamW 不接受这种稀疏梯度;SparseAdam 等稀疏优化器只处理出现的行。反过来,用普通稠密 AdamW 时,梯度以及一阶、二阶状态都按整张表分配,状态内存随 \(Vd\) 增长。
向量空间还有各向异性问题:很多向量可能挤在少数方向附近,导致余弦相似度普遍偏高,第八章句向量的问题与它同源。诊断方法见《LLM 时代的经典机器学习(08):降维——PCA、SVD、t-SNE / UMAP 与 embedding 的各向异性》「embedding 的各向异性」;余弦相似度本身见《算法工程师的数学(02):内积、范数与余弦相似度》「余弦相似度」。
十二、案例:在 text8 上训练 skip-gram
实验使用 Matt Mahoney 提供的完整 text8 语料,共 17,005,207 个词。先按 min_count=5 得到 71,290 词词表,再按 Mikolov 等人的高频词抽样公式降低常见词的出现率:词频为 \(f\)、阈值 \(t=10^{-5}\) 时,若 \(f>t\),保留概率为 \(P_{\text{keep}}=(\sqrt{f/t}+1)t/f\)。抽样后保留 5,597,324 个词。
训练使用 100 维稀疏 embedding、窗口半径随机取 1–5、每个正样本配 5 个按 \(P(w)\propto f(w)^{0.75}\) 构造的 alias-table 负样本。批大小为 16,384,SparseAdam 学习率从 0.01 衰减到 0.002;对 33,594,601 个训练对完整遍历 3 个 epoch,共 6,153 次更新。脚本首次运行会下载并缓存语料;本次 CPU 运行耗时 310.0 秒。
| 查询词 | 随机初始化的最近邻(余弦) | 训练后的最近邻(余弦) |
|---|---|---|
| king | irn (.410)、blaue (.392)、na (.384) | fortinbras (.672)、weds (.660)、montferrat (.646) |
| queen | auvergne (.455)、specific (.394)、yucat (.370) | elizabeth (.736)、highness (.677)、lady (.650) |
| computer | ambo (.393)、staged (.390)、soybeans (.383) | computers (.801)、machines (.725)、computing (.710)、hardware (.696)、software (.680) |
| software | namibian (.471)、dysfunctional (.397)、niger (.389) | proprietary (.753)、macos (.751)、netbeans (.747) |
| hardware | canucks (.413)、orchestrating (.400)、parse (.362) | cpu (.779)、firmware (.772)、chipsets (.757) |
| language | tribune (.381)、trs (.377)、microcoded (.366) | languages (.810)、spoken (.717)、syntax (.714) |
类比 \(\text{king}-\text{man}+\text{woman}\) 在随机初始化时返回 fairclough、mindstorms、bius;训练后返回 montferrat、widowed、matilda、daughter、eschiva。检索时排除了 king、man、woman,训练后也没有得到 queen。computer、software、hardware 的近邻已出现同领域词,但 king 的近邻仍受 text8 中的专名与叙事搭配影响。这展示了共现统计怎样改变检索排序,不是高质量词典,也不是类比关系成立的证据。
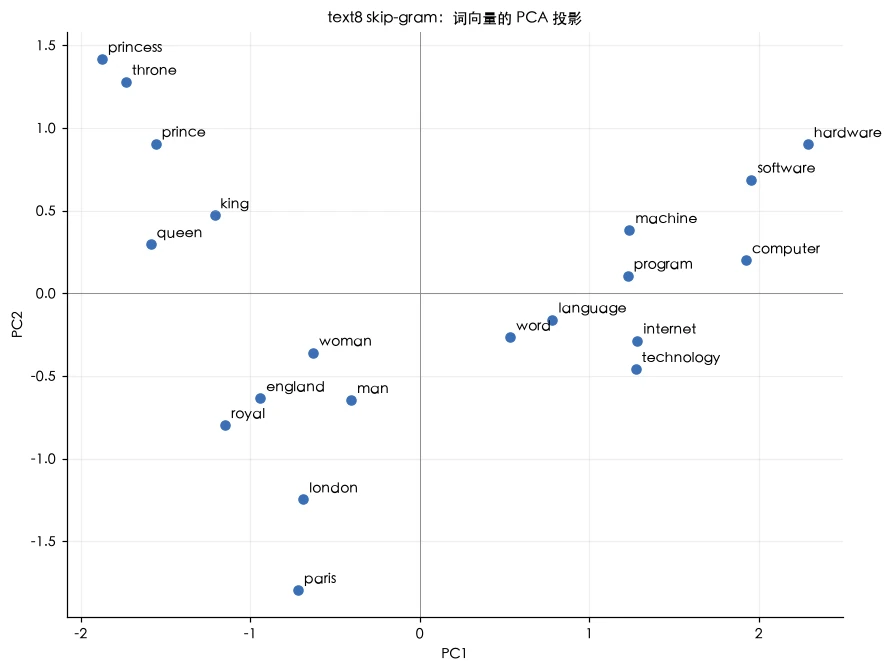
图中把训练后的 100 维词向量投影到二维 PCA 平面。PCA 只保留方差最大的两个方向,所以点之间的二维距离不能替代原始空间里的相似度。
配套脚本:case_embedding_word2vec.py、case_09_concept_figures.py。
十三、本文小结
Embedding 表把离散 ID 映射为可训练向量;后面的内容沿两条轴展开:嵌入什么——词、子词、句子与文本、图像、位置、图节点与实体、ID 与类别特征;用什么信号得到——计数分解(LSA、PPMI+SVD、GloVe)、预测(Word2Vec、BERT、GPT、MAE)、重建(AE、VAE)、对比(CLIP、SimCSE、TransE、双塔)、自蒸馏(BYOL、DINO)、有监督(ImageNet、NLI、CTR),以及根本不用学的固定公式(正弦、RoPE)。静态还是上下文相关是第三条独立的轴:它是架构属性,不是信号。
Word2Vec 用局部上下文训练静态词向量,负采样把全词表归一化改成少量正负样本判别,Levy & Goldberg 证明它和 PMI 分解学的是同一张统计表。现代语言模型把输入 embedding 继续变成受上下文影响的 hidden state,句子向量由专门的编码器给出,位置、图像、图节点和推荐 ID 走同一条「查表或映射 → 用信号摆向量」的路。工程上,词表乘维度决定参数量,稀疏访问与优化器状态决定了训练成本。
十四、自测
- one-hot 乘 embedding 矩阵为什么等价于查表?
nn.Embedding(sparse=True)的梯度与默认设置有何不同?答案
one-hot 只有第 \(i\) 位为 1,因此乘 \(E\) 后只取第 \(i\) 行。
sparse=True把非零行用稀疏张量存储;默认设置仍是稠密梯度,只是没查到的行梯度为零。 - PPMI 里的 P 是怎么来的,为什么负数要截成 0?
答案
PMI 是共现概率与独立假设下概率之比的对数;稀疏共现的负值噪声很大,截成 0 只保留「共现多于随机」的部分,作为矩阵分解的输入更稳。
- Word2Vec、GloVe、PPMI+SVD 三条路学的是不是同一样东西?
答案
是。负采样在数学上等价于分解一个 shifted PMI 矩阵;GloVe 把共现对数当回归目标;PPMI+SVD 直接分解计数矩阵。三者都在编码同一张词-上下文统计表,只是走法不同。
- skip-gram 与 CBOW 的预测方向分别是什么?负采样节省了哪一部分计算?
答案
skip-gram 用中心词预测上下文;CBOW 用上下文预测中心词。负采样只比较一个真实词对和少量噪声词对,不再对整个词表计算并归一化 softmax。
- 为什么 skip-gram 类比检索要排除输入的原词?类比结果能证明什么?
答案
原词可能因与查询向量相似而占据近邻列表,需排除它们才能看其他候选。类比只展示特定向量空间里的检索行为,不能证明语言或社会关系;偏见分析也不能只靠经典类比题。
- 词表外的词(OOV)有哪几种处理办法,各自代价是什么?
答案
fastText 把词拆成字符 n-gram 求和,代价是 n-gram 表变大;BPE 把词拆成子词,OOV 在分词层消失;hashing trick 把任意特征哈希进固定桶,代价是不同对象可能撞进同一行。
- 静态词向量与上下文表示的关键差别是什么?
答案
静态表按词类型查固定一行;上下文表示由 token 所在句子和模型层共同决定,同一个词的不同出现可以有不同向量。
- 直接拿 BERT 的
[CLS]当句向量为什么效果差?Sentence-BERT 和 SimCSE 各自怎么解决?答案
BERT 的 CLS 不是为相似度检索训的,且空间各向异性严重。Sentence-BERT 用孪生 encoder 在句对上微调;SimCSE 用同一句子两遍 dropout 当正例、batch 内互作负例。
- GPT-2 small 与 Llama 3 8B 的输入 embedding 表各有多少参数?为什么前者占总参数的比例更高?
答案
GPT-2 small 是 \(50{,}257\times768=38.6\text{M}\),约占 124M 的 31%;Llama 3 8B 是 \(128{,}256\times4{,}096=525.3\text{M}\),约占 8.03B 的 6.5%。模型主体变大后,同一张词表矩阵占比下降。
- 预测、重建、对比、自蒸馏、有监督五种信号各需要什么数据?
答案
预测要序列或遮盖的输入;重建要原始输入;对比要正例对加一批负例;自蒸馏只要同一输入的增广视图;有监督要人工标签。
下一篇
下一篇进入序列建模:《深度学习基础(10):RNN——从 LSTM 到 attention 的诞生》。
-
离散 ID 本身没有几何结构。Embedding 把 ID 查成向量;预测、重建或对比等训练目标再把信息写进这些向量。 ↩
系列 《深度学习基础:从反向传播到残差》 第 9 / 11 篇 入门
系列总览 — 为什么这样组织、读它需要什么、读完能做什么 · 幻灯片 — 整个系列的精华,一份可分享的 deck
学习地图 — AI 算法工程师学习地图 第 4 / 12 个系列
上一篇:CNN——从 LeNet 到 ResNet,再到 ViT下一篇:RNN——从 LSTM 到 attention 的诞生
下一个系列:Transformer 原理与实现:从论文到手搓 GPT-2 进阶 · 5 篇,约 1.2 小时
本文由 arganzheng 创作,采用 CC BY 4.0 许可协议。在保留原文作者、署名以及完整原文链接(https://arganzheng.life/embedding-and-representation-learning.html)的前提下,欢迎各种形式的转载、翻译或商业引用。
COMMENTS
评论存放在 GitHub Discussions, 用 GitHub 账号登录即可发表,支持 Markdown。 想针对正文某句话说?选中那段文字,点浮出的「评论」即可划线评论;觉得哪里写错了,发表时勾上「同时提交 Issue」。 有人回复你时 GitHub 会按你的通知设置发邮件,不用守在这里。