系列 《深度学习基础:从反向传播到残差》 第 6 / 7 篇
系列总览 — 为什么这样组织、读它需要什么、读完能做什么 · 幻灯片 — 整个系列的精华,一份可分享的 deck
- 反向传播——手推一个两层网络
- 训练为什么不稳定——初始化、归一化与残差
- 优化器——从 SGD 到 AdamW 与学习率调度
- 正则化与泛化——为什么参数比样本多却不过拟合
- CNN——从 LeNet 到 ResNet,再到 ViT
- RNN——从 LSTM 到 attention 的诞生
- 系列总结与通关自测
Attention 不是为 Transformer 发明的。2014 年它被加到一个循环神经网络的翻译模型上,目的很具体:encoder 把整句话压进一个固定长度的向量,句子长了向量装不下,翻译质量随句长下降——attention 让 decoder 每生成一个词都回头看 encoder 的全部隐状态,绕过这个瓶颈。三年后 Vaswani 等发现,有了 attention 之后循环本身可以不要了。
所以理解 RNN 的意义在于理解 attention 解决了什么。本篇按这条线走:循环网络怎么处理序列,它的梯度在时间上怎么传播(第二篇的 Jacobian 连乘在时间维上的版本),为什么记不住 20 步之外的东西,LSTM 的门控为什么能记更远——以及那个门在数学上就是残差连接——然后是 seq2seq 的瓶颈、attention 的原始形式,最后是 RNN 的两个致命缺点与 Transformer 的回答。四个实验各对应一段。全篇的核心问题是:
RNN 为什么记不住 20 步之外的东西?1 LSTM 的遗忘门与残差连接是什么关系?2 attention 最初是为了解决什么问题被发明的,它又为什么最终取代了发明它的 RNN?3
一、总览:一条线的四个节点
1. 从循环到 attention
| 节点 | 年 | 解决的问题 | 留下的问题 | 实验 |
|---|---|---|---|---|
| RNN | 1980s–1990 | 变长序列、参数共享、依赖历史 | 时间上的梯度消失 / 爆炸;记不住 10 步外 | 一、二 |
| LSTM / GRU | 1997 / 2014 | 用门控让状态”加法式”穿过时间——时间上的残差 | 仍是串行;路径长度仍是 \(O(n)\) | 二 |
| seq2seq + attention | 2014 | 固定向量装不下整句;让 decoder 直接看 encoder 每一步 | 有了 attention,循环还需要吗 | 三 |
| Transformer | 2017 | 去掉循环:self-attention 让任意两位置路径长度为 1、序列维完全并行 | \(O(n^2)\) 的算量、\(O(n)\) 的 KV cache | 四 |
2. 本文的章节安排
| 章 | 主题 | 内容 |
|---|---|---|
| 二 | 循环网络 | 状态更新式、参数共享、与 MLP 的关系、展开成计算图 |
| 三 | 时间上的反向传播 | BPTT 的推导、Jacobian 连乘、梯度随距离的衰减实测(0.5^t 到 1e-28)、梯度裁剪的起源 |
| 四 | LSTM 与 GRU | 门控、c_t = f⊙c_{t-1} + i⊙c̃ 就是残差、遗忘门偏置为什么要初始化为 1(实测 20 步 vs 40 步) |
| 五 | seq2seq 与它的瓶颈 | encoder-decoder、固定向量、翻译质量随句长下降的实测(8 → 32 步) |
| 六 | attention 的诞生 | Bahdanau 的公式、对齐矩阵、它与 softmax(QK^T)V 的对应 |
| 七 | RNN 的两个致命缺点与 Transformer 的回答 | 串行 vs 并行(实测硬件利用率差 4.5 倍)、路径长度、O(n²) 的代价、RNN 的回声 |
| 八 | 案例:字符级 LSTM 写莎士比亚 |
|
| 九 | 本文小结 | |
| 十 | 自测 | 5 道题 |
3. 来龙去脉:从”记住上一个词”到”看所有的词”
| 年 | 谁 | 当时的问题 | 留下的东西 |
|---|---|---|---|
| 1986 / 1990 | Jordan;Elman | 前馈网络的输入是固定长度的,句子、语音不是 | 循环网络(第二章):把上一步的隐藏状态喂回来,任意长度的序列用同一组权重处理 |
| 1994 / 1997 | Bengio 等;Hochreiter & Schmidhuber | RNN 训不了长依赖:梯度沿时间连乘,几十步就消失 | 说清病因(第三章);LSTM(第四章):用门控的细胞状态给梯度一条加法通路——就是残差 |
| 2000 / 2014 | Gers 等;Cho 等 | LSTM 忘不掉旧东西 / 门太多参数太多 | 遗忘门(原版 LSTM 没有);GRU:两个门的简化版 |
| 2013 | Graves | 用 RNN 生成文本和手写 | 深层 LSTM 的字符级语言模型(第八章的案例就是它);Karpathy 2015 的 char-rnn 让它人尽皆知 |
| 2014 | Sutskever 等;Cho 等,seq2seq | 机器翻译:输入和输出是两个不同长度的序列 | 编码器–解码器(第五章):整句压成一个向量再展开——第一个端到端的神经机器翻译 |
| 2015 | Bahdanau、Cho、Bengio | 一个向量装不下长句,翻译质量随句长掉 | attention(第六章):解码每一步回头看编码器的所有位置,按相关性加权——路径长度从 \(T\) 变成 1 |
| 2017 | Vaswani 等,Transformer | RNN 串行、GPU 喂不饱;attention 既然能看所有位置,还要循环干什么 | 去掉循环、只留 attention(第七章)——L4 系列的全部内容 |
三十年一条线:循环解决了”变长输入”,门控解决了”长依赖训不动”,编码器–解码器解决了”输入输出长度不同”,attention 解决了”一个向量装不下”,最后 Transformer 发现 attention 一个就够了。每一步都是上一步的补丁,最后一步把主体换掉、只留补丁。今天 RNN 在哪:极长序列、极小设备上的流式处理(语音唤醒词、传感器),以及 2023 年之后以 Mamba / RWKV 为名的”线性 RNN”回潮——它们想拿回 RNN 推理时 \(O(1)\) 内存的优点(第七章的”RNN 的回声”)。
二、循环网络
1. 状态更新式
序列建模的问题设定:输入 \(x_1, \dots, x_T\) 长度不定,输出依赖历史,参数量不能随 \(T\) 变。RNN 的答案是一个状态 \(h_t\) 加一个在每个时间步复用的更新函数:
\[h_t = \tanh(W h_{t-1} + U x_t + b), \qquad y_t = V h_t\]\(W \in \mathbb{R}^{d \times d}\) 是状态到状态的转移,\(U\) 是输入投影,三组参数与 \(T\) 无关——这是时间上的参数共享,与上一篇卷积在空间上的参数共享同类。\(h_t\) 是到第 \(t\) 步为止全部历史的摘要,维度固定为 \(d\)。
2. 展开
沿时间展开,RNN 是一个 \(T\) 层的网络,每层用同一组权重,每层额外吃一个输入:
%% 图:RNN 沿时间展开——T 层、同一组权重 W、每层多吃一个输入
flowchart LR
    x1[x₁] --> h1; x2[x₂] --> h2; x3[x₃] --> h3; xT[x_T] --> hT
    h0((h₀)) -->|W| h1((h₁)) -->|W| h2((h₂)) -->|W| h3((h₃)) -->|W| dots[…] -->|W| hT((h_T)) -->|V| y[y_T]
Graves 2013 论文里的图 1 画的是同一件事的三层版本——每一列是一个时间步,每一行是一层,横向的箭头是循环(同一组权重),纵向的是层间连接:
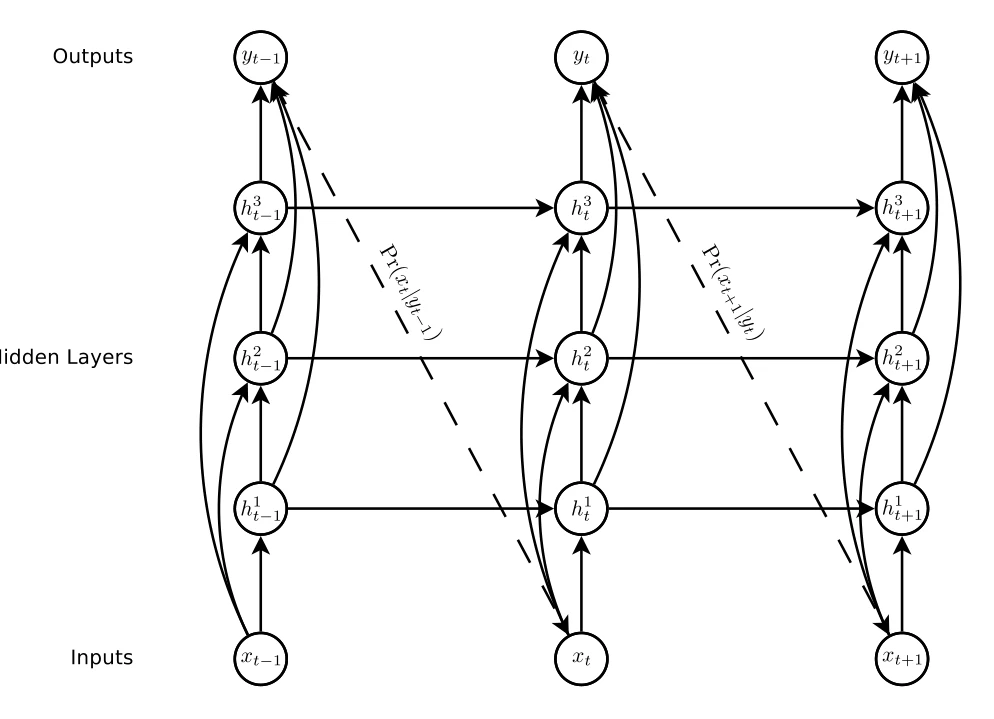
这个视角把前五篇的一切都带了进来:它是一个深度为 \(T\) 的网络,\(T\) 常常是几百上千——比任何 CNN 都深,而且每层的权重相同,第二篇里”Jacobian 连乘”的问题在这里以最纯粹的形式出现。
三、时间上的反向传播
1. BPTT
对展开图做反向传播就是 BPTT(backpropagation through time)。loss 在第 \(T\) 步,对第 \(t\) 步状态的梯度是
\[\frac{\partial L}{\partial h_t} = \left( \prod_{k=t+1}^{T} J_k^T \right) \frac{\partial L}{\partial h_T}, \qquad J_k = \frac{\partial h_k}{\partial h_{k-1}} = \text{diag}\!\left(1 - h_k^2\right) W\]\(T - t\) 个 Jacobian 的乘积,每个是”tanh 的导数(在 \((0, 1]\) 之间)乘同一个 \(W\)“。第二篇第三章的论证逐字适用:乘积的范数由 \(W\) 的谱范数与 tanh 导数的乘积决定,系统性地小于 1 就指数衰减,大于 1 就指数爆炸。而这里比 MLP 更糟——\(W\) 每一步都是同一个,没有”不同层的偏差互相抵消”的运气。
2. 实测:梯度随距离的衰减
第八章用 NumPy 实现了一个 \(d = 64\)、\(T = 60\) 的 RNN 的前向与 BPTT,loss 只在最后一步,记录 \(\|\partial L / \partial h_t\|\) 随距离 \(T - t\) 的变化。\(W\) 用 \(\sigma_w = c / \sqrt{d}\) 初始化,\(c\) 取三个值:
| \(c\) | \(\sigma_{max}(W)\) | 距离 0 | 距离 10 | 距离 20 | 距离 40 | 距离 59 |
|---|---|---|---|---|---|---|
| 0.5 | 1.00 | 8.0 | \(1.2 \times 10^{-4}\) | \(1.4 \times 10^{-9}\) | \(3.5 \times 10^{-19}\) | \(3.2 \times 10^{-28}\) |
| 1.0 | 1.87 | 8.0 | 0.19 | \(4.0 \times 10^{-3}\) | \(1.2 \times 10^{-6}\) | \(1.0 \times 10^{-10}\) |
| 1.5 | 2.97 | 8.0 | 5.5 | 0.40 | \(7.3 \times 10^{-3}\) | \(3.1 \times 10^{-4}\) |
即使 \(W\) 的最大奇异值接近 3(\(c = 1.5\)),tanh 的导数把它拉回来:以距离 0 的 8.0 为基准,20 步之外的梯度只剩 \(0.40 / 8 = 5\%\),40 步外是 \(7.3 \times 10^{-3} / 8 \approx 0.09\%\)(表里的数是绝对值,比例要除以 8)。\(c = 1.0\)(标准初始化)时 20 步外是 \(4.0 \times 10^{-3} / 8 = 0.05\%\),60 步外是 \(10^{-11}\) 量级。这就是”RNN 记不住 20 步之外的东西”的全部含义:不是它的状态装不下,是训练信号传不到那么远——第 \(t\) 步的输入对 loss 的影响梯度几乎为零,\(U\) 与 \(W\) 学不到”保留第 \(t\) 步信息”这件事。另一边,\(W\) 稍大就会爆炸;Pascanu 等 2013 系统分析了这两种失败,并提出用梯度裁剪对付爆炸——第三篇第七章那个 LLM 训练标配的裁剪,最初是为 RNN 发明的。
3. 实测:记忆长度
一个直接的任务:随机 token 序列,要求在第 \(T\) 步输出第一个 token。信息必须穿过 \(T\) 步。第八章的结果(Adam、裁剪、1500 步,之后延长到 6000 步):
| \(T\) | vanilla RNN | LSTM(默认初始化) |
|---|---|---|
| 5 | 100% | 100% |
| 10 | 17.7%(6000 步后仍 10%) | 100% |
| 20 | 10%(随机) | 9.7%(随机) |
| 40 | 10% | 9.2% |
| 80 | 10% | 10.6% |
RNN 在 10 步就失败了。LSTM 好一点,但默认初始化下也止于 10 步——直到把遗忘门的偏置初始化为 1(下一章解释为什么),20 步与 40 步都在 500 步之内学会,80 步在 6000 步内仍学不会。
四、LSTM 与 GRU
1. 门控
LSTM(Hochreiter & Schmidhuber 1997;遗忘门由 Gers 等 2000 加入)在隐状态 \(h_t\) 之外加一个细胞状态 \(c_t\),用三个门控制它的读写:
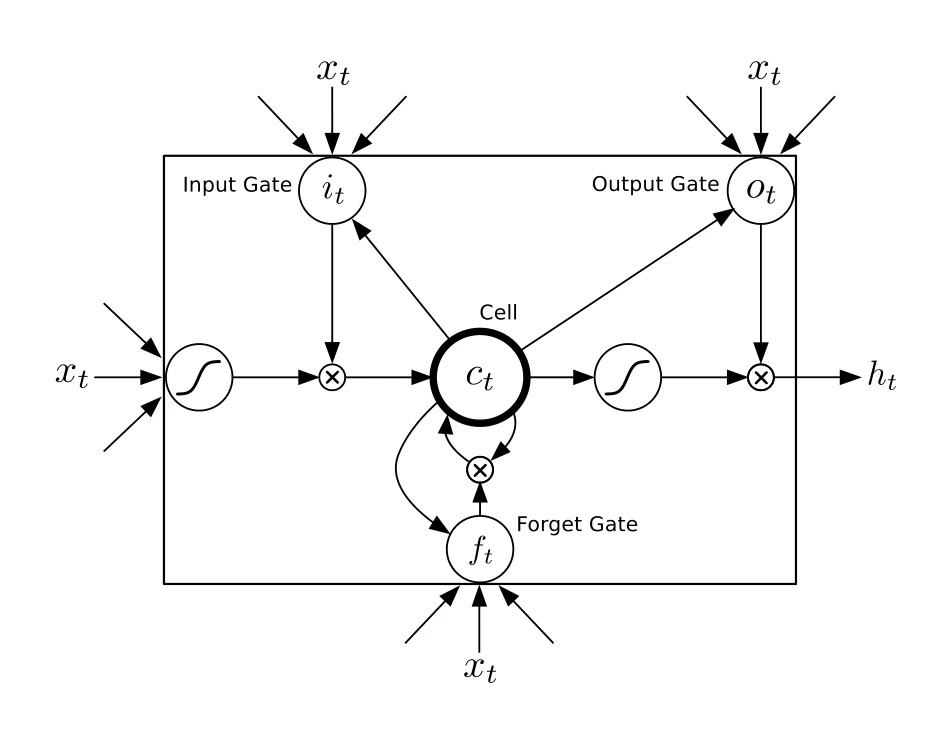
\[\begin{aligned} f_t &= \sigma(W_f [h_{t-1}, x_t] + b_f) &&\text{遗忘门:保留多少旧状态} \\ i_t &= \sigma(W_i [h_{t-1}, x_t] + b_i) &&\text{输入门:写入多少新信息} \\ \tilde c_t &= \tanh(W_c [h_{t-1}, x_t] + b_c) &&\text{候选新信息} \\ c_t &= f_t \odot c_{t-1} + i_t \odot \tilde c_t &&\text{细胞状态更新} \\ o_t &= \sigma(W_o [h_{t-1}, x_t] + b_o), \quad h_t &= o_t \odot \tanh(c_t) &&\text{输出门} \end{aligned}\]经典的 LSTM 细胞图(Graves 2013 图 2)——中间的 Cell 是 \(c_t\),围着它的三个 \(\sigma\) 是输入门、遗忘门、输出门,\(\otimes\) 是逐元素乘,自己指向自己的那条环就是 \(c_t = f_t \odot c_{t-1} + \ldots\):
同一张图按本文的记号重画一遍,只保留细胞状态那条路:
%%{init: {"flowchart": {"wrappingWidth": 160}}}%%
%% 图:LSTM 的门控:细胞状态 c 从 c_{t−1} 到 c_t 只经一次逐元素乘和一次加法
flowchart LR
    CP["c_{t−1}"] --> MF(("⊙"))
    F["f_t = σ(·)
遗忘门"] --> MF
    MF --> ADD(("+"))
    I["i_t = σ(·)
输入门"] --> MI(("⊙"))
    CT["c̃_t = tanh(·)
候选信息"] --> MI
    MI --> ADD
    ADD --> C["c_t"]
    C --> TH["tanh"] --> MO(("⊙"))
    O["o_t = σ(·)
输出门"] --> MO
    MO --> H["h_t"]
    IN["[h_{t−1}, x_t]"] --> F
    IN --> I
    IN --> CT
    IN --> O

    classDef cell fill:#fff7e0,stroke:#c98a00,stroke-width:2px,color:#222
    classDef gate fill:#eef6ff,stroke:#5b8fd6,color:#222
    class CP,MF,ADD,C cell
    class F,I,O,CT gate
黄色是细胞状态 \(c\) 走的那条路:从 \(c_{t-1}\) 到 \(c_t\) 只经过一次逐元素乘(遗忘门)和一次加法,没有矩阵乘、没有 tanh——下一节说它为什么就是残差。四组权重(\(f, i, c, o\)),每组 \(d \times 2d\),参数量是 vanilla RNN 的 4 倍。GRU(Cho 等 2014)合并成两个门、去掉独立的细胞状态,参数 3 倍,效果相近。
2. 细胞状态的更新式就是残差
细胞状态的更新式是加法:新状态 \(=\) 旧状态(乘一个门)\(+\) 新信息。对比第二篇第五章的残差 \(x_{l+1} = x_l + f(x_l)\),结构相同——只多了一个逐元素的门 \(f_t\)。它的 Jacobian 是
\[\frac{\partial c_t}{\partial c_{t-1}} = \text{diag}(f_t) + (\text{依赖 } h_{t-1} \text{ 的项})\]第一项是”接近恒等”的通路:只要 \(f_t \approx 1\),梯度沿 \(c\) 穿过时间几乎不衰减——这正是残差连接给 ResNet 的东西,LSTM 在 1997 年先做到了,只是叫法不同(原论文叫 “constant error carousel”)。vanilla RNN 的 \(h_t = \tanh(W h_{t-1} + \dots)\) 是乘法式的:状态每步被 \(W\) 变换一次、被 tanh 压一次,没有恒等通路。
3. 遗忘门偏置为什么要初始化为 1
恒等通路只在 \(f_t \approx 1\) 时打开。默认初始化下 \(b_f = 0\),\(f_t = \sigma(\text{接近 } 0) \approx 0.5\)——每步保留一半,20 步后是 \(0.5^{20} \approx 10^{-6}\),通路是关着的。把 \(b_f\) 初始化为 1(Gers 等 2000 建议;Jozefowicz 等 2015 系统验证),\(f_t \approx \sigma(1) = 0.73\),20 步后还剩 0.2%……仍然不多,但足以让梯度把 \(f_t\) 进一步推向 1,训练能启动。第三章的实验就是这个差别:\(b_f = 0\) 时 LSTM 在 20 步失败,\(b_f = 1\) 时 20 步与 40 步都在 500 步内学会。
这与第二篇的教训是同一个:残差通路要在初始时刻就是打开的——ResNet 靠 \(x + f(x)\) 的结构保证,GPT-2 靠残差分支的小初始化保证,LSTM 靠遗忘门偏置保证。忘了这一条,加了残差也白加。
4. 仍然不够
LSTM 把可用的记忆长度从 10 步推到几十步、精心调过的模型能到几百步,但两个问题它没有解决:梯度沿 \(c\) 的路径长度仍然是 \(O(T)\),\(f_t\) 的连乘只是衰减得慢了;每一步仍然依赖上一步,\(T\) 步就是 \(T\) 次串行计算。第七章回到这两点。
五、seq2seq 与它的瓶颈
1. Encoder-decoder
Sutskever 等 2014 用两个 LSTM 做机器翻译:encoder 读完源句得到最终状态 \(h_T^{enc}\),decoder 从这个状态出发逐词生成目标句。整个源句的信息被压进一个 \(d\) 维向量——\(d\) 通常是 1000 左右。
2. 固定向量装不下
Cho 等 2014 与 Bahdanau 等 2014 都报告了同一个现象:翻译质量随源句长度下降,句子超过 20–30 词后 BLEU 明显掉。一个固定维度的向量要编码任意长的句子,长了就丢信息;decoder 生成第 \(k\) 个词时需要的是源句的第 \(k\) 个词附近的信息,却只能从一个”全句摘要”里挖。
第八章用一个最小任务复现:把随机序列倒序输出。这个任务对瓶颈极其敏感——输出第 1 个词需要输入的最后一个词,输出最后一个词需要输入的第 1 个词,所有位置的信息都要完整保留。GRU encoder-decoder、只用最终状态、2000 步:
| 序列长 \(T\) | 固定向量:token 准确率 | 整句准确率 |
|---|---|---|
| 8 | 89.7% | 40.4% |
| 16 | 67.5% | 0.0% |
| 32 | 43.5% | 0.0% |
16 个 token 就一句都对不了。64 维的向量装不下 16 个 20 类的 token(信息量 \(16 \times \log_2 20 \approx 69\) bit,理论上 64 个 float 装得下,但网络学不出这种编码)。
六、attention 的诞生
1. Bahdanau 的公式
Bahdanau 等 2014 的改动:不让 decoder 只看 \(h_T^{enc}\),而是在生成每个词时对 encoder 的全部隐状态 \(h_1^{enc}, \dots, h_T^{enc}\) 算一组权重,加权求和成一个”上下文向量”:
\[e_{kj} = v_a^T \tanh(W_a h_j^{enc} + U_a s_{k-1}), \qquad \alpha_{kj} = \frac{\exp(e_{kj})}{\sum_{j'} \exp(e_{kj'})}, \qquad c_k = \sum_j \alpha_{kj}\, h_j^{enc}\]两篇原论文的图放在一起,就是”瓶颈”与”打破瓶颈”:
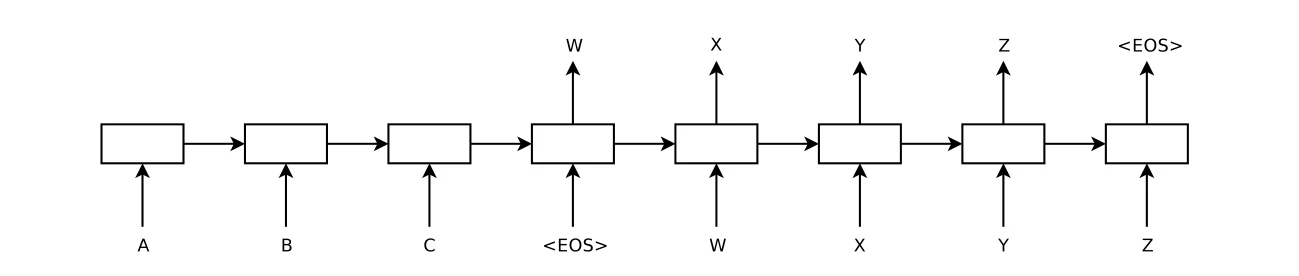
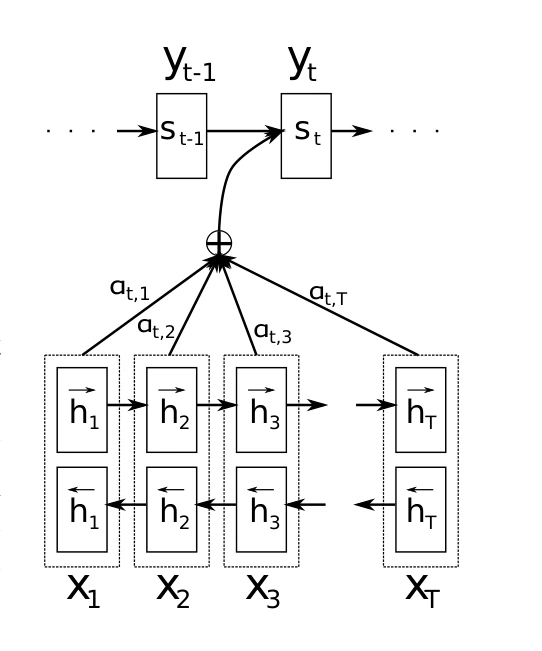
\(s_{k-1}\) 是 decoder 的当前状态,\(e_{kj}\) 是”生成第 \(k\) 个词时第 \(j\) 个源词有多相关”的打分,softmax 变成权重,\(c_k\) 送进 decoder 的下一步。瓶颈消失了:decoder 每一步能直接取到源句任何位置的信息,路径长度从 \(O(T)\) 变成 1。
2. 实测与对齐矩阵
同一个倒序任务加上 attention:
| \(T\) | 固定向量:整句准确率 | attention:token 准确率 | 整句准确率 |
|---|---|---|---|
| 8 | 40.4% | 98.5% | 91.3% |
| 16 | 0.0% | 97.7% | 76.4% |
| 32 | 0.0% | 95.5% | 47.0% |
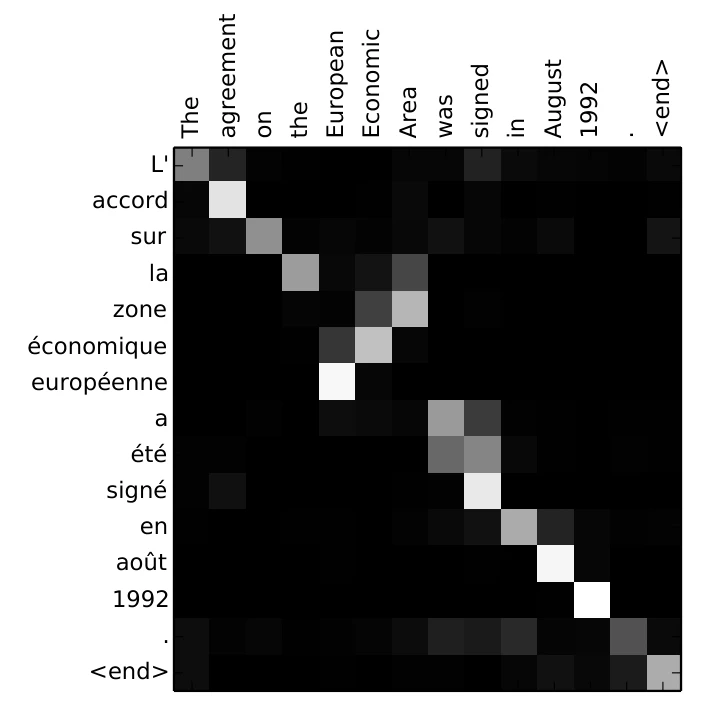
权重 \(\alpha_{kj}\) 排成矩阵就是对齐矩阵——Bahdanau 论文里那张著名的法英对齐图。倒序任务上它应该是反对角线;第八章从训好的模型里取一个样本画成热力图:
左边是 Bahdanau 等 2015 论文图 3 里英法翻译的真实对齐——大体沿对角线(两种语言词序接近),在 “European Economic Area” ↔ “zone économique européenne” 处交叉(法语形容词后置):
模型自己学出了”倒序 = 反对角线对齐”,没有人告诉它。细看它偏了一格(第 2 步仍在看第 8 位):教师强制下解码器已经拿到了上一步的正确输出,注意力学成了”找到我刚输出的那个字符在输入里的位置”,再靠 GRU 状态往前推一格——对齐是从数据里学出来的,不保证长成人预想的样子,这也是读任何 attention 可视化时要记住的。这是 attention 的可解释性来源,也是它作为一种可学习的、由内容决定的路由的本质:每一步该看哪里,由当前状态与各位置的匹配度决定,而不是由固定的结构决定。
3. 与 softmax(QKᵀ)V 的对应
把 Bahdanau 的式子换一套记号:\(s_{k-1}\) 是 query,\(h_j^{enc}\) 既是 key(用来打分)也是 value(用来加权求和),打分函数 \(v_a^T \tanh(W_a h_j + U_a s)\) 是一个小 MLP(”additive attention”)。Luong 等 2015 把打分简化成点积 \(s^T h_j\);Vaswani 等 2017 给 query、key、value 各配一个投影矩阵,打分用缩放点积 \(q^T k / \sqrt{d_k}\)(L0 数学系列第四篇解释了 \(\sqrt{d_k}\)),再把整件事写成矩阵形式:
\[\text{Attention}(Q, K, V) = \text{softmax}\!\left(\frac{QK^T}{\sqrt{d_k}}\right) V\]这就是 Transformer 的 attention。它与 2014 年的版本只差记号与打分函数;变的是用法:Bahdanau 的 attention 是 decoder 看 encoder(cross-attention),Transformer 让序列里的每个位置看同一序列的所有位置(self-attention),并且发现有了它,循环可以整个去掉。
七、RNN 的两个致命缺点与 Transformer 的回答
1. 串行
\(h_t\) 依赖 \(h_{t-1}\),\(T\) 步就是 \(T\) 次不能并行的计算。每一步是一个 \(d \times d\) 的矩阵乘向量——对 GPU 来说太小,算力用不起来。self-attention 没有这个依赖:\(QK^T\) 是一个 \(T \times d\) 乘 \(d \times T\) 的矩阵乘法,整个序列一次算完。第八章在 CPU 上测前向耗时(\(d = 256\),batch 1):
| \(T\) | RNN 耗时 | RNN FLOPs | RNN 达到的算力 | self-attention 耗时 | attention FLOPs | 达到的算力 |
|---|---|---|---|---|---|---|
| 1024 | 3.7 ms | 0.27 G | 73 GFLOPS | 4.0 ms | 1.07 G | 270 GFLOPS |
| 4096 | 14.6 ms | 1.07 G | 73 GFLOPS | 52.4 ms | 17.2 G | 330 GFLOPS |
RNN 的 FLOPs 只有 attention 的 1/16,耗时却只少 3.6 倍:同一颗 CPU,attention 达到的算力是 RNN 的 4.5 倍,因为 RNN 的每一步只有一个小矩阵乘向量、无法填满硬件。在几千核并行的 GPU 上差距更大——这是 Transformer 能用同样的时间训更大的模型、吃更多的数据的直接原因。
2. 路径长度
序列里相距 \(n\) 的两个位置,在 RNN 里信息要经过 \(n\) 步才能相遇(LSTM 只是衰减慢一些);在 self-attention 里,任意两个位置在一层之内直接相连,路径长度 1。第三章实测的梯度衰减、第五章的瓶颈,在 self-attention 里从结构上不存在。
3. 代价:平方级的算量与 KV cache
Attention 的 FLOPs 是 \(O(T^2 d)\),RNN 是 \(O(T d^2)\);\(T > d\) 之后 attention 更贵,且推理时要保留全部历史的 key 与 value——KV cache,大小 \(O(T)\)。上表 \(T = 4096\) 时 attention 的 FLOPs 已是 RNN 的 16 倍。《Transformer 与 LLM》系列的第二、三、四篇全是在算这个代价:长上下文的二次项、KV cache 的字节数、GQA / MLA 怎么压它。可以说那个系列是本篇最后一行的展开。
4. RNN 的回声
RNN 的推理成本是 \(O(1)\) / token、状态大小固定——这两点 Transformer 没有。状态空间模型(S4、Mamba)、线性 attention、RWKV 一类工作试图找回它们:训练时像 attention 一样并行,推理时像 RNN 一样只维护一个固定大小的状态。它们在权衡的是”固定状态装不下长历史”(第五章的瓶颈以新形式回来)与”\(O(T)\) 的 KV cache”。当前主流仍是 Transformer,混合结构(大部分层线性、少数层完整 attention)在一些模型里开始出现。知道它们在权衡什么,就够了。
八、案例:字符级 LSTM 写莎士比亚
0. 与 nanoGPT 同一份语料、同一预算
问题与数据:Transformer 系列第四篇用 nanoGPT 在 1 MB 的莎士比亚剧本上训了一个字符级 GPT(4 层、128 维、0.80M 参数,batch 12 × 64 字符 × 2000 步,val loss 4.17 → 1.66)。这一节用同一份语料、同样的 batch / 上下文 / 步数训一个 2 层 LSTM(256 维,1.09M 参数),看 2013 年 Graves、2015 年 Karpathy char-rnn 那一代模型和小 Transformer 比在哪、差在哪。这是 RNN 最有名的应用之一——它让”神经网络能写出像人话的东西”第一次进入大众视野。
思路:字符级语言模型——输入 64 个字符,每个位置预测下一个字符,loss 是交叉熵(每字符的 nats)。LSTM 一次读一个字符、状态 \((h, c)\) 各 256 维;nanoGPT 一次看全部 64 个。
class CharLSTM(nn.Module):
    def __init__(self, V, d=256, layers=2):
        super().__init__()
        self.emb = nn.Embedding(V, d); self.lstm = nn.LSTM(d, d, layers, batch_first=True); self.head = nn.Linear(d, V)
    def forward(self, x, state=None):
        h, state = self.lstm(self.emb(x), state)          # [B, T, d]:每个位置一个状态
        return self.head(h), state                        # [B, T, V]:每个位置预测下一个字符

for s in range(2000):
    x, y = get_batch(train, B=12, T=64)                   # y 是 x 右移一位
    logits, _ = model(x)
    loss = F.cross_entropy(logits.reshape(-1, V), y.reshape(-1))
    opt.zero_grad(); loss.backward(); nn.utils.clip_grad_norm_(model.parameters(), 1.0); opt.step()   # 第三章:裁剪
效果(case_06_char_lstm_and_alignment.py,MPS 上 27 秒):
| 步 | LSTM train | LSTM val | nanoGPT val(Transformer 04) |
|---|---|---|---|
| 0 | 4.17 | 4.17 | 4.16 |
| 250 | 2.08 | 2.12 | 2.87 |
| 500 | 1.85 | 1.94 | 2.40 |
| 1000 | 1.67 | 1.80 | 1.95 |
| 1500 | 1.61 | 1.74 | 1.72 |
| 2000 | 1.58 | 1.71 | 1.66 |
生成 400 个字符(temperature 0.8):
Well be to the cheept to put till to the well,
Thou will voited and breon fortiend?
And I the fair to sentration to that be him the country
As your king lead it, sife on the netter'd they goes--
A shall come to may she so condice at the sholied, to meated of my heaven,
His is our heaven as pition are their.

FARIANA:
As I have the less to beon the muts be made
Then you do hath the destion and stri
三件事:
- 同一量级:LSTM val 1.71 vs nanoGPT 1.66。1 MB 的莎士比亚、0.8–1.1M 参数上,2015 年的模型和 2017 年的模型几乎一样好,生成的样子也一样——单词一半是拼出来的,但角色名、冒号、换行、诗行长度、thee / hath 全对。Transformer 的优势不在这个规模上。
- LSTM 前期快得多(500 步 1.94 vs 2.40):循环结构自带”下一个字符和上一个字符相关”的偏置,Transformer 要从数据里学出这个偏置——第五篇 ViT 那节”归纳偏置 vs 数据量”的序列版。
- 快 15 倍(27 秒 vs 7 分钟)——但这是 nanoGPT 小 batch 在 MPS 上 kernel 启动瓶颈的假象,不是 LSTM 算得少。真正的差别在第七章:LSTM 的 64 步是顺序的,序列长到几千、batch 大到几百时 GPU 喂不饱;Transformer 的 64 个位置是并行的一次矩阵乘。这个规模上看不出来,规模上去就是全部。
落地还差什么:把 LSTM 做大(Graves 2013 是 3 层 × 700;2016 年 Google 翻译的 GNMT 是 8 层 LSTM + attention)在 2017 年之前就是最强的序列模型;之后所有资源都转向了 Transformer,不是因为 LSTM 在小数据上更差,而是因为它在大数据、长序列、大 batch 上训不快——第七章讲的那两个致命缺点。下面第 1–2 节是本篇其余实验(梯度衰减、记忆长度、遗忘门偏置、seq2seq、计时)的代码与结果。
1. 代码
四个实验。第一个纯 NumPy(30 行):RNN 前向 + BPTT,只算 \(\partial L / \partial h_t\),不更新参数:
for t in range(T): h = np.tanh(W @ h + U @ x[t]); hs.append(h)
g = np.ones(d)                                    # dL/dh_T
for t in range(T, 0, -1):
    norms.append(np.linalg.norm(g))
    g = W.T @ (g * (1 - hs[t] ** 2))               # J_t^T g
其余三个用 PyTorch:记忆任务用 nn.RNN / nn.LSTM 加线性头;seq2seq 用 GRU encoder + GRUCell decoder,attention=True 时在每步算 Bahdanau 打分 va(tanh(Wa(H) + s)),softmax 后加权求和拼进 decoder 输入;耗时对比用 nn.RNN 与 nn.MultiheadAttention。
2. 结果
四组结果已分别列在第三、四、五、六、七章。补两条:LSTM 遗忘门偏置为 1 时的学习速度——\(T = 20\) 与 \(T = 40\) 都在第 500 步的第一次评估时就达到 100%,\(T = 80\) 在 6000 步内未学会;耗时实验 \(T = 64\) 与 256 时两者都在 1 ms 以下,差别从 \(T = 1024\) 起才显现。全部实验在笔记本 CPU 上约 5 分钟。
3. 值得自己动手的扩展
- 在第一个实验里把 tanh 换成 ReLU,看 \(c = 1.5\) 时梯度是否转为爆炸(ReLU 的导数是 0 或 1,不再把 \(W\) 拉回来);
- 给记忆任务加一个”\(T\) 步之间有干扰 token 要忽略”的变体,看 LSTM 的门是否学会关闭输入门;
- 把 seq2seq 的 attention 打分从 additive 换成点积,对比收敛速度——这是 Luong 2015 做的事。
九、本文小结
- RNN 用一个固定维度的状态与一组共享参数处理变长序列;展开后是深度为 \(T\)、每层权重相同的网络。
- BPTT 的梯度是 \(T - t\) 个 \(\text{diag}(1 - h^2) W\) 的乘积;标准初始化下 20 步外衰减到千分之四、60 步外 \(10^{-10}\)。RNN 记不住 10 步外的东西(实测),不是装不下,是训练信号传不到。梯度裁剪最初为 RNN 的爆炸而发明。
- LSTM 的 \(c_t = f_t \odot c_{t-1} + i_t \odot \tilde c_t\) 是时间上的残差连接,1997 年就有;恒等通路要在初始时刻打开——遗忘门偏置初始化为 1,20 步与 40 步的任务从”学不会”变成”500 步学会”。
- seq2seq 把整句压进一个固定向量,16 个 token 的倒序任务整句准确率 0%。Bahdanau attention 让 decoder 每步对 encoder 全部状态加权求和,同一任务到 76%;对齐矩阵自己学出反对角线。
- Bahdanau 的 \(s\)、\(h_j\)、加权和,就是 query、key / value、\(\text{softmax}(QK^T)V\);Transformer 换了打分函数与用法(self-attention),然后去掉了循环。
-
RNN 的两个致命缺点:串行(实测同一 CPU 上 attention 达到的算力是它的 4.5 倍)与 \(O(n)\) 的路径长度。Transformer 用 \(O(n^2)\) 的算量与 \(O(n)\) 的 KV cache 换掉了两者——04 系列全在算这笔账。SSM / 线性 attention 在找回 RNN 的 \(O(1)\) 推理成本。
- 案例:与 nanoGPT 同一份莎士比亚、同一预算,2 层 LSTM val loss 1.71 vs 1.66——这个规模上看不出 Transformer 的优势,差别在顺序 vs 并行;倒序任务的对齐矩阵是一条反对角线(偏一格),从数据里学出来的。
配套代码:deep-learning-foundations/06_rnn_attention.py(bptt / memory / forget / seq2seq / timing 五个子实验)与 case_06_char_lstm_and_alignment.py(第八章案例,MPS 上半分钟)。
本篇的 Bahdanau attention 是 \(\text{softmax}(QK^T)V\) 的前身;04 系列第一篇《Transformer 长什么样》从这里接过去:把它变成 self-attention、加上 mask、多头、FFN、残差与 LayerNorm,用 \(d = 4\) 的例子手算一遍,再用 nanoGPT 写出来。
十、自测
-
把一个 RNN 沿时间展开,它是一个几层的网络?与普通深网络最大的不同是什么?
答案
深度为 \(T\)(序列长度)的网络,每层多吃一个输入 \(x_t\);最大的不同是每层权重相同——第二篇里 Jacobian 连乘的问题以最纯粹的形式出现,一个因子偏离 1 就在所有层同时偏离。
-
LSTM 隐藏维度 \(d = 256\)、输入维度也是 256:四组门的参数量合计多少?是 vanilla RNN 的几倍?
答案
每组 \(W \in \mathbb{R}^{256 \times 512}\)(拼接 \([h, x]\))加偏置:\(256 \times 512 + 256 = 131{,}328\);四组 525K;vanilla RNN 只有一组,所以是 4 倍。GRU 三组。
-
遗忘门偏置初始化为 0 与初始化为 1,\(f_t\) 初始各约多少?对梯度通路意味着什么?
答案
\(\sigma(0) = 0.5\):细胞状态每步衰减一半,20 步后 \(10^{-6}\),通路是关的;\(\sigma(1) \approx 0.73\)(配合输入接近 1 时更高):通路基本打开。实验里 20 步与 40 步的任务从”学不会”变成”500 步学会”。
-
把 Bahdanau attention 的 \(s_{k-1}\)、\(h_j^{enc}\)、\(\alpha_{kj}\)、\(c_k\) 分别对到 \(\text{softmax}(QK^T)V\) 里的哪一项?Transformer 改了什么?
答案
\(s_{k-1}\) 是 query,\(h_j^{enc}\) 同时是 key 与 value,\(\alpha_{kj}\) 是 softmax 后的权重,\(c_k\) 是加权和 \(\sum_j \alpha_{kj} v_j\)。Transformer 把打分函数从加性的 \(v_a^T \tanh(\cdot)\) 换成缩放点积、让序列对自己做 attention(self-attention)、然后去掉了循环。
-
RNN 生成一个 token 的推理成本是 \(O(1)\)、Transformer 是 \(O(n)\)(读 KV cache)——Transformer 为什么还是赢了?
答案
训练时 RNN 是串行的(\(T\) 步依赖),Transformer 全部位置并行,同样算力下能训的数据多几倍;任意两个位置之间的路径长度 RNN 是 \(O(n)\)、attention 是 1,长依赖直接可学。推理侧的 \(O(n)\) 用 KV cache 与系统优化(04 系列)换回来;SSM / 线性 attention 在试图两头都要。
-
BPTT 的梯度是 \(T - t\) 个 \(\text{diag}(1 - h^2)\, W\) 的乘积,标准初始化下 20 步外衰减到千分之四、60 步外 \(10^{-10}\)——不是状态装不下,是训练信号传不到(实测记忆长度约 10 步)。详见第三章。 ↩
-
同一件事。LSTM 的 \(c_t = f_t \odot c_{t-1} + i_t \odot \tilde c_t\) 是加法更新,Jacobian \(\partial c_t / \partial c_{t-1} = \text{diag}(f_t) + \dots\),只要 \(f_t \approx 1\) 就是一条接近恒等的通路——与 ResNet 的 \(I + J\) 同构,1997 年就有;所以遗忘门偏置要初始化为 1,把通路在初始时刻打开。详见第四章。 ↩
-
为了解决 seq2seq 的瓶颈:整句压进一个固定向量,16 个 token 的倒序任务整句准确率 0%;Bahdanau 让 decoder 每步对 encoder 全部状态加权求和,同一任务到 76%(第五章、第六章)。之后人们发现 attention 本身就能建模序列,而 RNN 有两个 attention 没有的致命缺点:串行(同一 CPU 上 attention 的算力是它的 4.5 倍)与 \(O(n)\) 的路径长度;Transformer 用 \(O(n^2)\) 的算量与 \(O(n)\) 的 KV cache 换掉了两者(第七章)。 ↩
系列 《深度学习基础:从反向传播到残差》 第 6 / 7 篇
系列总览 — 为什么这样组织、读它需要什么、读完能做什么 · 幻灯片 — 整个系列的精华,一份可分享的 deck
- 反向传播——手推一个两层网络
- 训练为什么不稳定——初始化、归一化与残差
- 优化器——从 SGD 到 AdamW 与学习率调度
- 正则化与泛化——为什么参数比样本多却不过拟合
- CNN——从 LeNet 到 ResNet,再到 ViT
- RNN——从 LSTM 到 attention 的诞生
- 系列总结与通关自测
本文由 arganzheng 创作,采用 CC BY 4.0 许可协议。在保留原文作者、署名以及完整原文链接(https://arganzheng.life/rnn-lstm-and-the-birth-of-attention.html)的前提下,欢迎各种形式的转载、翻译或商业引用。
COMMENTS
评论存放在 GitHub Discussions, 用 GitHub 账号登录即可发表,支持 Markdown。 想针对正文某句话说?选中那段文字,点浮出的「评论」即可划线评论;觉得哪里写错了,发表时勾上「同时提交 Issue」。 有人回复你时 GitHub 会按你的通知设置发邮件,不用守在这里。