系列 《深度学习基础:从反向传播到残差》 第 5 / 7 篇
系列总览 — 为什么这样组织、读它需要什么、读完能做什么 · 幻灯片 — 整个系列的精华,一份可分享的 deck
- 反向传播——手推一个两层网络
- 训练为什么不稳定——初始化、归一化与残差
- 优化器——从 SGD 到 AdamW 与学习率调度
- 正则化与泛化——为什么参数比样本多却不过拟合
- CNN——从 LeNet 到 ResNet,再到 ViT
- RNN——从 LSTM 到 attention 的诞生
- 系列总结与通关自测
前四篇讲训练动力学,用的网络全是 MLP。这一篇和下一篇回看 Transformer 之前的两条结构史——卷积与循环——不是为了怀旧,而是因为 Transformer 的每个部件都有来历:残差连接、归一化、”堆同样的块”来自卷积这条线;attention 来自循环那条线。理解一个部件当初解决了什么问题,才知道它今天还在解决什么、什么时候可以拿掉。
卷积网络的故事可以压缩成三句话:卷积是一个被强约束的线性层,约束带来的参数节省与归纳偏置让它在数据不多时远胜 MLP;深度是为了感受野(receptive field,一个输出位置能看到输入的范围),而深了就训不动,ResNet 用残差解决了它;数据足够多时约束成了负担,ViT 把图切成 patch、当成 token 送进标准 Transformer,只保留了卷积的一个影子——patch embedding 本身就是一个 stride 等于 kernel 的卷积。三句话各对应本篇的一个实验。全篇的核心问题是:
一个 3×3 卷积核相当于多大的全连接矩阵?1 ResNet 的残差与 Transformer 的残差是同一个东西吗?2 ViT 为什么可以不用卷积?3
一、总览:三个阶段
1. 卷积网络的三个阶段
| 阶段 | 年代 | 解决的问题 | 代表 | 留给 Transformer 的 |
|---|---|---|---|---|
| 卷积作为归纳偏置 | 1989–2014 | 图像的局部性与平移不变性;用参数共享把参数量压下来 | LeNet、AlexNet、VGG、GoogLeNet | 1×1 卷积 = 逐位置的线性层;小核堆深 |
| 深度与残差 | 2015–2016 | 深了训不动(退化问题);BN 让前向稳定,残差让反向稳定 | ResNet、ResNet-v2 | 残差连接、归一化、堆同样的块、pre-activation(Pre-Norm 的前身) |
| 去掉归纳偏置 | 2020– | 数据够多时局部性约束成了上限;把图切成 token 交给 attention | ViT、ConvNeXt | patch embedding = stride 卷积;一张图等于多少 token |
2. 本文的章节安排
| 章 | 主题 | 内容 |
|---|---|---|
| 二 | 卷积作为带约束的线性层 | 定义、参数量与 FLOPs 公式、等价的稀疏矩阵(实测 16×36 矩阵 144 个非零 9 个自由参数)、两个归纳偏置 |
| 三 | 感受野、stride 与深度 | 感受野公式 1+2L、下采样、为什么必须深 |
| 四 | 五个里程碑 |
|
| 五 | ResNet 的实验与遗产 |
|
| 六 | 从 CNN 到 ViT |
|
| 七 | 案例:复现 LeNet-5 |
|
| 八 | 本文小结 | |
| 九 | 自测 | 5 道题 |
3. 来龙去脉:从猫的视觉皮层到 ImageNet
| 年 | 谁 | 当时的问题 | 留下的东西 |
|---|---|---|---|
| 1959–1962 | Hubel & Wiesel(生理学) | 猫的视觉皮层神经元对什么有反应 | 每个神经元只看视野的一小块、对特定方向的边缘敏感;简单细胞 → 复杂细胞的层级——局部感受野与层级特征的生物原型 |
| 1980 | Fukushima,Neocognitron | 把 Hubel & Wiesel 的层级做成能识别手写字的模型 | 交替的”S 层”(卷积)与”C 层”(池化),已经是 CNN 的骨架——但当时不知道怎么训 |
| 1989 / 1998 | LeCun 等 | 邮政编码、支票金额的手写识别要能上线 | 用反向传播训 Neocognitron 式的网络;LeNet-5(第四章、第七章的案例):卷积 + 池化 + 全连接的范式,MNIST 0.95% |
| 1998–2011 | 更大的图(ImageNet 120 万张 224×224)上 CNN 训不动、也不如 SVM + 手工特征 | 十年里 CNN 是小众——算力和数据都不够 | |
| 2012 | Krizhevsky、Sutskever、Hinton,AlexNet | ImageNet 比赛 | 8 层、6000 万参数、两块 GPU、ReLU、dropout,错误率 26% → 16%——深度学习复兴的起点(第四章) |
| 2014 | Simonyan & Zisserman,VGG;Szegedy 等,GoogLeNet | 再深一点怎么设计 | 只用 3×3 堆到 19 层;1×1 卷积做通道降维、多分支(第四章) |
| 2015 | He 等,ResNet | 56 层比 20 层训练误差还高——深了反而差 |
|
| 2020 | Dosovitskiy 等,ViT | 卷积的归纳偏置在数据够多时还是优势吗 | 把图切成 16×16 的 patch 当 token 喂 Transformer;数据够大时超过 CNN(第六章)——多模态 LLM 的视觉编码器由此而来 |
一条线看下来,CNN 的想法(局部、共享、层级)1980 年就有了,等了 32 年才等到足够的数据和算力(2012 年);它统治视觉八年,又被”数据够多时不需要归纳偏置”的 ViT 接替。本篇要讲清的是这三段:卷积是什么、为什么它在数据少时赢(第二、三章);深了怎么训(第四、五章);数据多了为什么可以不用它(第六章)。
二、卷积作为带约束的线性层
1. 定义与两条公式
二维卷积(深度学习里实际是互相关,不翻转核):输入 \(x \in \mathbb{R}^{C_{in} \times H \times W}\),核 \(k \in \mathbb{R}^{C_{out} \times C_{in} \times k_h \times k_w}\),输出的每个位置是核与输入对应窗口的内积:
\[y_{o, i, j} = \sum_{c=1}^{C_{in}} \sum_{a=0}^{k_h - 1} \sum_{b=0}^{k_w - 1} k_{o, c, a, b}\, x_{c,\, i + a,\, j + b} + \beta_o\]参数量 \(= C_{out} \cdot C_{in} \cdot k_h \cdot k_w + C_{out}\),与图像大小无关。FLOPs \(= 2 \cdot H_{out} \cdot W_{out} \cdot C_{out} \cdot C_{in} \cdot k_h \cdot k_w\)——每个输出位置做一次长度为 \(C_{in} k_h k_w\) 的内积,与图像大小成正比。这是卷积与全连接层最大的算术区别:全连接层每个参数每样本用一次(2 FLOPs,第一篇),卷积层每个参数被用”输出位置数”次。ResNet-50 有 2560 万参数、每张图 82 亿 FLOPs(\(2 \times\) 乘加),比值 320 FLOPs / 参数——即一个参数平均被用了 160 次(每次 2 FLOPs),是全连接的 160 倍。
2. 它就是一个稀疏矩阵
对每个输出位置,卷积是输入的一个线性函数;把输入拉直成向量,整个卷积就是一个矩阵乘法 \(y = Mx\)。第七章的实验构造了这个矩阵:一个 \(3 \times 3\) 核作用在 \(6 \times 6\) 单通道图像上,输出 \(4 \times 4\),\(M\) 是 \(16 \times 36\):
max |conv - M@x| = 8.9e-16
matrix shape (16, 36), entries 576, nonzero 144, distinct free params 9
row 0 of M (reshaped 6x6):          ← 输出位置 (0,0) 对输入的权重
[[-0.65 -0.13  0.78  0.    0.    0. ]
 [ 1.49 -1.26  1.51  0.    0.    0. ]
 [ 1.35  0.78  0.26  0.    0.    0. ]
 [ 0.    0.    0.    0.    0.    0. ]
 [ 0.    0.    0.    0.    0.    0. ]
 [ 0.    0.    0.    0.    0.    0. ]]
576 个矩阵元素里 144 个非零(每行 9 个)、且这 144 个只有 9 个不同的值——每一行是同一个核在不同位置。所以卷积 \(=\) 全连接层 \(+\) 两条约束:
- 局部性:每个输出只看输入的一个 \(k \times k\) 窗口,矩阵稀疏;
- 参数共享(平移等变性):所有位置用同一组权重,矩阵的各行是同一个模式的平移。
代一个真实尺寸:ResNet-50 第二阶段一个 \(3 \times 3\)、\(64 \to 64\) 通道、\(56 \times 56\) 特征图的卷积,参数 36,864;等价的全连接矩阵是 \((56 \times 56 \times 64)^2 = 200704^2 \approx 4 \times 10^{10}\) 个元素——160 GB 的 fp32。两条约束把参数压了六个量级,这是 CNN 在 2012–2016 年能训、MLP 不能的算术原因。
3. 约束就是先验
上一篇第五章说显式正则化是”把模型拉向某种简单解的先验”。卷积的两条约束是最强的一种:不是拉向、而是只允许满足局部性与平移等变性的解。在图像上这个先验几乎总是对的(一只猫在左上角和右下角是同一只猫),所以数据不多时 CNN 远胜 MLP。但它也是一个上限——长距离的关系(图像两端的两个物体)要靠堆很多层才能看到(第三章),而数据足够多时模型本可以自己学出比”局部 + 平移”更好的先验(第六章)。
三、感受野、stride 与深度
1. 感受野
第 \(L\) 层的一个输出位置能”看到”输入的多大范围,叫感受野(receptive field,中文文献里的通行译法,借自神经科学里视网膜神经元的同名概念)。stride 为 1 的 \(3 \times 3\) 卷积每层把感受野扩大 2:\(\text{RF}_L = 1 + 2L\)。一维的截面:
第 3 层输出        ·  ·  ·  ·  ·  ·  ●  ·  ·  ·  ·  ·  ·        一个位置
                                 ╱  │  ╲
第 2 层            ·  ·  ·  ·  ·  ●  ●  ●  ·  ·  ·  ·  ·        看到 3 个(RF = 3)
                              ╱ ╱ ╲ │ ╱ ╲ ╲
第 1 层            ·  ·  ·  ·  ●  ●  ●  ●  ●  ·  ·  ·  ·        看到 5 个(RF = 5)
                           ╱ ╱  ╲ ╲ │ ╱ ╱  ╲ ╲
输入               ·  ·  ·  ●  ●  ●  ●  ●  ●  ●  ·  ·  ·        看到 7 个(RF = 7 = 1 + 2 × 3)
5 层是 11,10 层是 21,20 层是 41——要让一个输出看到整张 \(224 \times 224\) 的图,stride 1 需要 112 层。这就是”深”的最初动机:感受野随深度线性增长,而任务需要全局信息。
2. Stride 与池化
stride 为 \(s\) 的卷积(或池化)把特征图缩小 \(s\) 倍,之后每层的感受野增量乘 \(s\)。ResNet-50 用一个 stride 2 的 \(7 \times 7\) 卷积和一个 stride 2 的池化把 224 降到 56,之后每个阶段再降一半,最终特征图 \(7 \times 7\)、总下采样 32 倍——50 层的感受野覆盖整张图有余。下采样同时把 FLOPs 降下来(每次减 4 倍)、把通道数升上去(每次乘 2),保持每个阶段的计算量大致相同。这个”空间减半、通道翻倍”的模式从 VGG 沿用到 ResNet,是 CNN 设计的默认节奏。
3. 深了就训不动
感受野要求深,深了就遇到第二篇的全部问题:方差衰减或爆炸、梯度连乘。2014 年的 VGG 到 19 层就停了,不是不想更深,是更深训不动。BatchNorm(2015 年初)解决了前向的一半;同年底 ResNet 用残差解决了反向的一半,一口气到 152 层。第五章的实验在 56 层上复现这个转折。
四、五个里程碑
1. 各解决了什么
| 网络 | 年 | 层数 | 参数 | 引入的东西 | 今天还在用的 |
|---|---|---|---|---|---|
| LeNet-5 | 1998 | 5 | 60K | 卷积 + 池化 + 全连接的范式;反向传播训练 | 范式本身 |
| AlexNet | 2012 | 8 | 60M | ReLU、dropout、GPU 训练、数据增强;ImageNet 上把错误率从 26% 降到 16% | ReLU、GPU、增强 |
| VGG-16 | 2014 | 16 | 138M | 只用 \(3 \times 3\) 核堆深;两个 \(3 \times 3\) 的感受野等于一个 \(5 \times 5\),参数 18 vs 25 且多一个非线性 | 小核堆深;”空间减半通道翻倍” |
| GoogLeNet | 2014 | 22 | 6.8M |
|
\(1 \times 1\) 卷积;全局平均池化 |
| ResNet-50 / 152 | 2015 | 50 / 152 | 25.6M / 60M |
|
残差、归一化、堆同样的块 |
四张原论文的结构图,按年代——
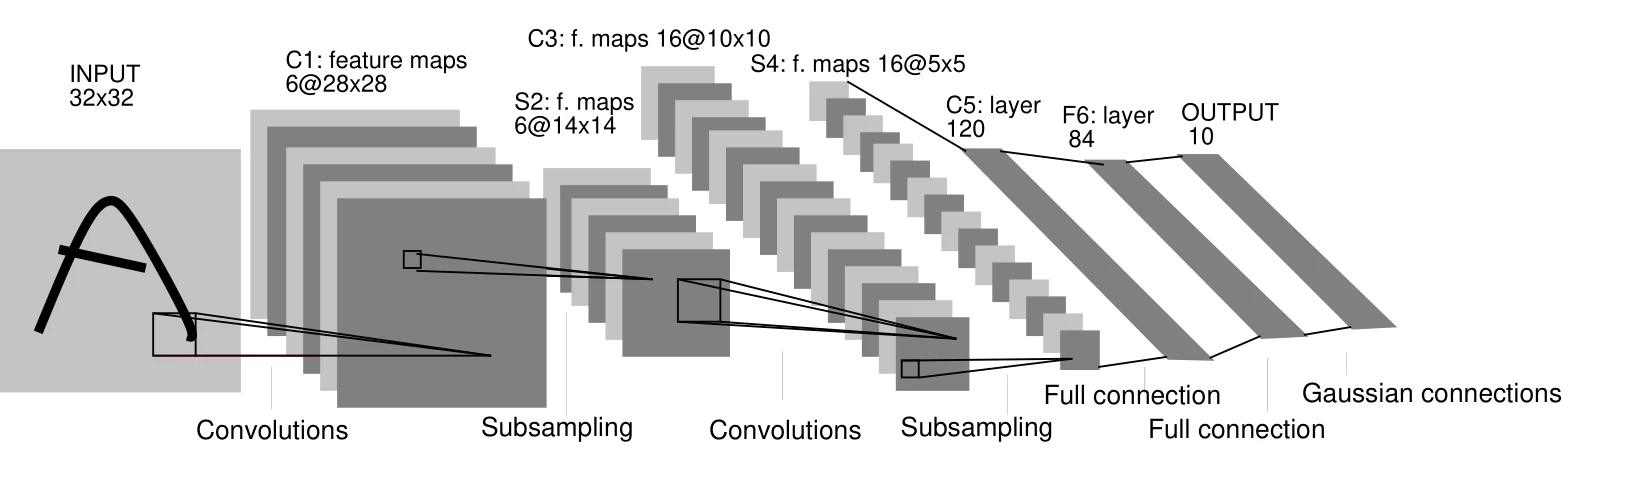
LeNet-5:五个带参数的层,卷积和下采样(池化)交替,最后接全连接——这张图里的每个部件今天都还在用(第七章的案例把它一层层数一遍:61,706 个参数)。
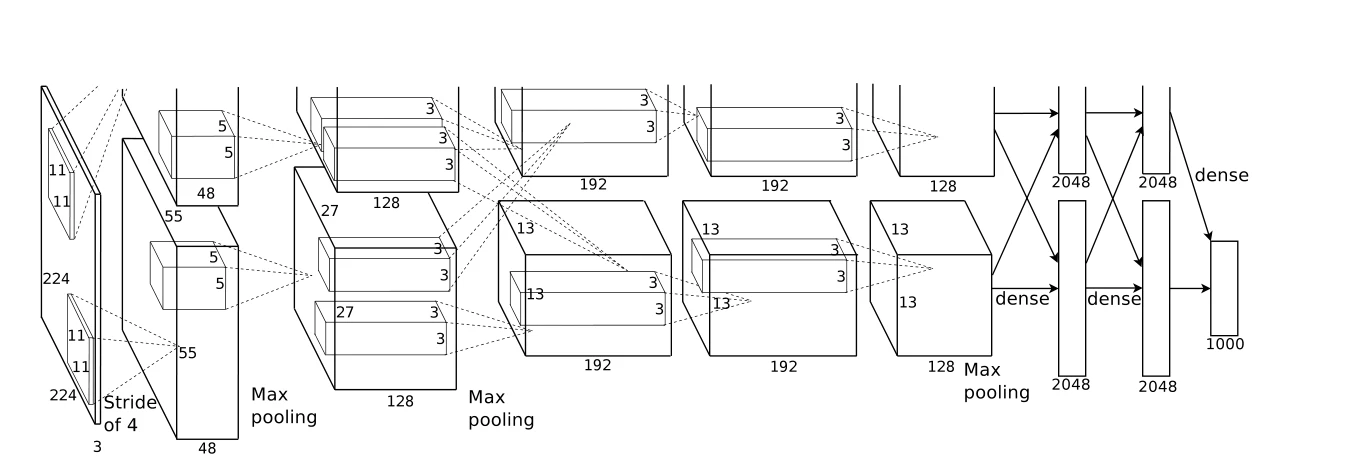
AlexNet:结构上就是放大的 LeNet(5 卷积 + 3 全连接),新东西是 ReLU、dropout、数据增强,以及模型被切成上下两半跑在两块 3 GB 的 GTX 580 上——模型并行的第一次实用,因为一块卡装不下 6000 万参数。这张图顶部被裁掉不是本站的错,原论文 PDF 里就是这样。
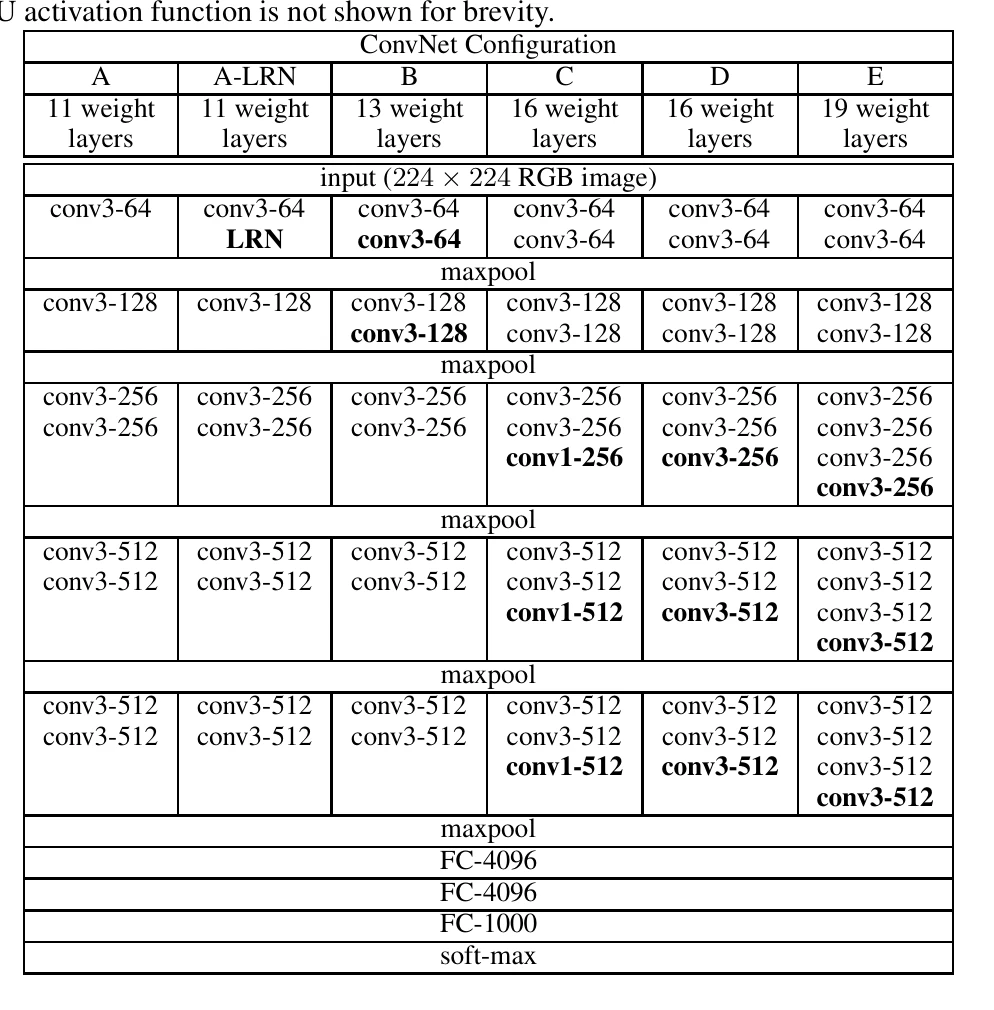
VGG:一张表而不是一张图,因为它的结构简单到能用表格写完——只有 3×3 卷积、2×2 池化和”空间减半、通道翻倍”的节奏。这种规整性是它留给后来者最大的遗产:ResNet、以及 Transformer 的”堆 N 个相同的块”都是这个思路。
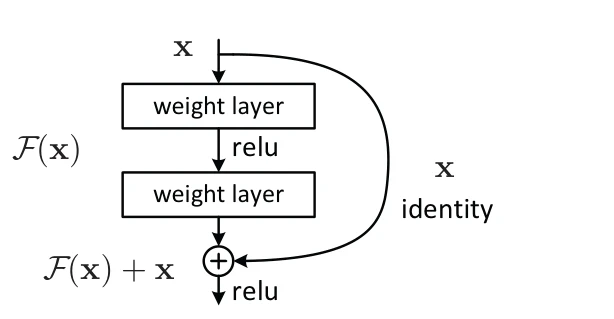
ResNet:结构图只需要画一个块——弧线那条恒等通路就是第二篇第五章的 \(I + J\),也是 Transformer 每一层的残差。
两个趋势值得看:参数量从 AlexNet 的 60M 到 GoogLeNet 的 6.8M 再到 ResNet-50 的 25.6M——大全连接层被砍掉后(AlexNet 的 60M 里 58M 在最后三个全连接层),参数量不再是深度的函数;层数从 8 到 152,深度成了主要的扩展维度。
2. ResNet-50 的账
第七章用 torchvision 的 ResNet-50 逐层数了一遍:
params 25.56M  (conv 23.45M, fc 2.05M, bn 0.05M)
FLOPs per image (224x224): conv 8.17 G, fc 0.004 G -> 8.18 GFLOPs (= 4.09 GMACs)
文献里常说的”ResNet-50 4.1 GFLOPs”数的是乘加次数(MACs),按本系列”一次乘加 = 2 FLOPs”的约定是 8.2 GFLOPs。参数 92% 在卷积,全连接只有最后 \(2048 \times 1000\) 一层;BN 的参数可以忽略。
3. Bottleneck 块的算术
ResNet-50 的残差块是三层:\(1 \times 1\) 降维 → \(3 \times 3\) → \(1 \times 1\) 升维。以 256 通道的输入为例:
| 设计 | 层 | 参数 |
|---|---|---|
| 两个 \(3 \times 3\),\(256 \to 256 \to 256\)(ResNet-18/34 的块) | 2 | \(2 \times 256 \times 256 \times 9 = 1.18\)M |
| Bottleneck:\(1 \times 1\) \(256 \to 64\),\(3 \times 3\) \(64 \to 64\),\(1 \times 1\) \(64 \to 256\) | 3 | \(16\text{K} + 37\text{K} + 16\text{K} = 69\)K |
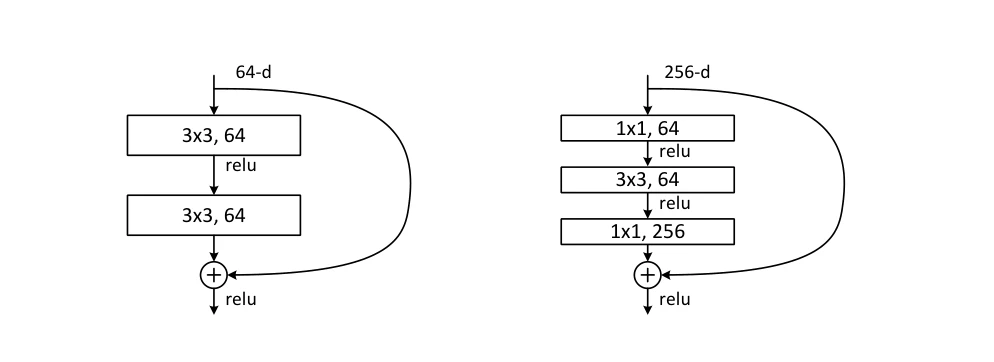
三层比两层少 17 倍参数,因为昂贵的 \(3 \times 3\) 在 4 倍窄的通道上做。\(1 \times 1\) 卷积没有空间感受野,它就是对每个位置独立做一次线性变换——与 Transformer 里对每个 token 独立做的 FFN 是同一种算子。Transformer 的 FFN 是反过来的 bottleneck(\(d \to 4d \to d\),先升后降),但”用逐位置的线性层做通道混合、用另一种算子做位置混合”这个分工是共同的:CNN 用 \(3 \times 3\) 混合空间位置,Transformer 用 attention 混合序列位置。
五、ResNet 的实验与遗产
1. 退化问题
He 等 2015 的出发点是一个实验事实:在 CIFAR-10 上,56 层的 plain 网络比 20 层的训练误差更高——不是过拟合(训练误差高),是优化失败。理论上深网络至少能表示浅网络(多出的层学成恒等),但 SGD 找不到那个解。残差把”学恒等”变成”学零”(\(f(x) = 0\) 时块就是恒等),找到就容易了。
2. 实测:20 层与 56 层
第七章在 MNIST(stride 2 到 \(14 \times 14\),16 通道,每块一个 \(3 \times 3\) 卷积 + BN,plain 或残差)上复现:
| 深度 | 结构 | 初始梯度范数:第 1 块 / 第 \(L\) 块 | 比值 | 训练 loss @ 1 epoch | @ 3 epoch | 测试准确率 |
|---|---|---|---|---|---|---|
| 20 | plain | 1.7 / 0.16 | 11 | 0.460 | 0.128 | 96.4% |
| 20 | residual | 1.3 / 0.37 | 3.4 | 0.224 | 0.093 | 96.8% |
| 56 | plain | 950 / 0.33 | 2849 | 1.676 | 0.724 | 70.9% |
| 56 | residual | 2.2 / 0.76 | 2.9 | 0.268 | 0.129 | 96.1% |
两个观察。第一,退化问题复现了:plain 网络从 20 层到 56 层,训练 loss 从 0.13 恶化到 0.72;残差网络 0.09 与 0.13,深了没有变坏。第二,梯度爆炸的方向:plain-56 第 1 块的梯度范数是第 56 块的 2849 倍——是靠近输入的层梯度大,不是小。这与第二篇”没有归一化时梯度消失”相反:有了 BN 的深 plain 网络,梯度反向穿过每个 BN 时被输入方差归一化放大,越靠输入越大(Yang 等 2019 从平均场理论证明了 BN 在深 plain 网络里必然导致梯度爆炸)。BN 修了前向,把反向的问题换了一个方向。残差网络的比值在 3 左右——恒等通路把它压平了。
3. 四样遗产
ResNet 留给 Transformer 的不只是残差:
| 遗产 | ResNet 里 | Transformer 里 |
|---|---|---|
| 残差连接 | \(x + f(x)\),每块 | \(x + \text{Attn}(\cdot)\),\(x + \text{FFN}(\cdot)\),每层两次 |
| 归一化到处用 | 每个卷积后一个 BN | 每个子层一个 LayerNorm / RMSNorm |
| Pre-activation | ResNet-v2(He 等 2016)把 BN 与 ReLU 移到卷积之前、残差相加之后不再有非线性,更深更稳 | Pre-Norm(第二篇第六章)——同一个想法后来进了 Transformer:原始 Transformer(2017)与 BERT 用的是 Post-Norm,GPT-2(2019)起 Pre-Norm 成为主流 |
| 堆同样的块 | 一个块的设计定好,重复 \(N\) 次,只改深度与宽度 | 一层的设计定好,重复 \(L\) 次;scaling 只动 \(L\)、\(d\)、\(d_{ff}\) |
第三条最少被提到、也最有意思:Transformer 后来的 Pre-Norm 在 ResNet 这条线上已经被发现过一次(Transformer 自己是从 Post-Norm 起步、两年后才换的)。
六、从 CNN 到 ViT
1. 归纳偏置与数据量
第二章说卷积的两条约束是先验。先验的价值与数据量反相关:数据少时先验替你排除了大量错误假设,数据多时数据本身足以排除它们,先验只剩限制。Dosovitskiy 等 2020 的 ViT 论文把这个关系做成了一个干净的实验:只用 ImageNet-1k(130 万张)训练,ViT 不如同规模的 ResNet;用 JFT-300M(3 亿张)预训练再迁移,ViT 反超,且模型越大差距越大。CNN 的先验在 100 万张图上是资产,在 3 亿张图上是负债。
2. ViT 的结构
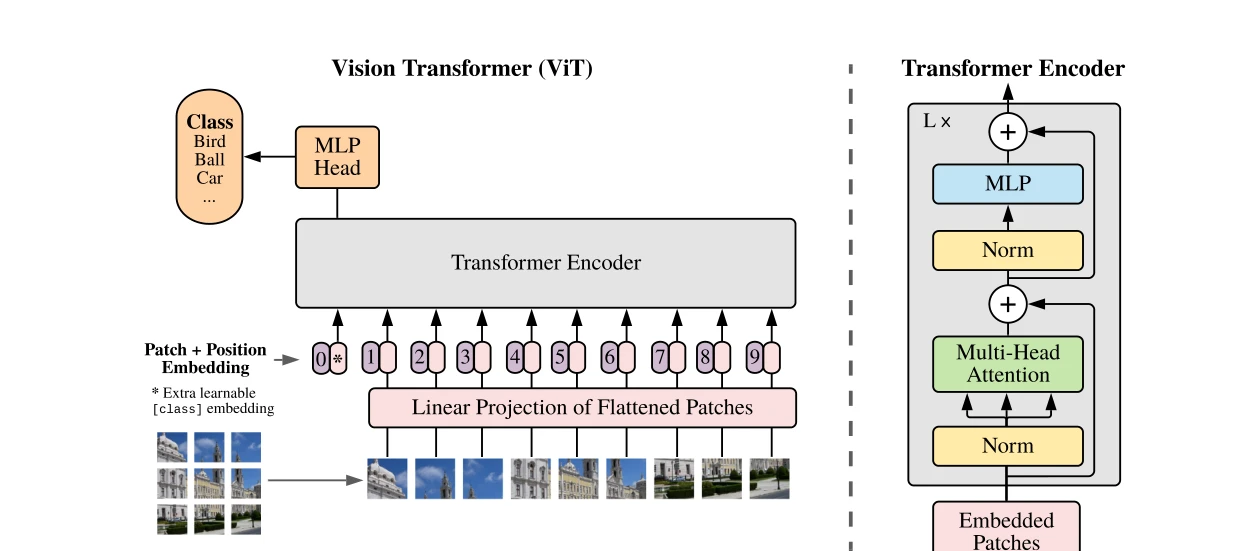
ViT 对 Transformer encoder 几乎没有改动,改的只是输入。下图是 Dosovitskiy 等 2020 论文的图 1:
按形状走一遍:
- 图像 \([3, 224, 224]\),切成 \(16 \times 16\) 的 patch,共 \((224 / 16)^2 = 196\) 个;
- patch 序列 \([196, 3 \cdot 16 \cdot 16 = 768]\),线性投影到 \(d = 768\)(”patch embedding”),前面拼一个
[CLS]token,加可学习的位置编码; - token 序列 \([197, 768]\),过标准 Transformer encoder × 12 层(Pre-Norm,MHA + FFN;块结构同 BERT,但 BERT 是 Post-Norm);
[CLS]的输出 → 分类头。
没有卷积、没有池化、没有”空间减半通道翻倍”。一张图就是 196 个 token,之后的每一步与处理 196 个词完全相同。图像的二维结构只通过位置编码告诉模型——模型要自己从数据里学出”相邻 patch 相关”这件事,这就是它需要更多数据的原因。
3. Patch embedding 就是一个卷积
“切 patch + 线性投影”这一步,等价于一个 kernel 与 stride 都等于 patch 大小的卷积。第七章用 PyTorch 验证:nn.Conv2d(3, 768, kernel_size=16, stride=16) 与”unfold 切 patch → 矩阵乘”的输出差 \(1.2 \times 10^{-6}\)(fp32 的求和顺序差异)。参数 \(3 \times 16 \times 16 \times 768 + 768 = 590{,}592\),两种写法完全相同。所以 ViT 保留了卷积的一个影子:只在输入那一层、只做一次、窗口互不重叠。之后的 Transformer 层里,任意两个 patch 之间的路径长度是 1——CNN 要堆几十层才有的全局感受野,attention 第一层就有。
4. 一张图等于多少 token
token 数 \(= (H / p) \times (W / p)\),由分辨率与 patch 大小决定,与模型大小无关:
| 配置 | 分辨率 | patch | token 数 |
|---|---|---|---|
| ViT-B/16、ViT-L/16 | 224 | 16 | 196 |
| ViT-L/14、ViT-H/14 | 224 | 14 | 256 |
| CLIP ViT-L/14-336(LLaVA-1.5 用) | 336 | 14 | 576 |
| 原生分辨率 ViT(Qwen2-VL 一类)在 1024² 上 | 1024 | 14 | 5476(merge 前) |
这张表是 L7 多模态的入口:VLM 把 ViT 的输出 token 送进 LLM,一张图占多少上下文、多少 KV cache,从这里开始算——04 系列第十三篇把这笔账算完了。attention 的算量随 token 数平方增长,所以高分辨率图像要么用更大的 patch、要么在 encoder 后合并 token(2×2 merge)、要么用窗口 attention——三种办法都在那一篇。
5. 卷积的残余
卷积没有消失,它退到了几个特定位置:
- ViT 的 patch embedding:如上;Xiao 等 2021 发现把这一个大卷积换成几个小卷积堆叠(”early convolutions”)能让 ViT 更好训、对超参数更稳;
- 语音的前端:Whisper 的 encoder 在 Transformer 之前有两层一维卷积(第二层 stride 2),把 mel 频谱下采样一半再进 attention;
- 扩散模型的 U-Net:Stable Diffusion 1.x / 2.x 的去噪网络是卷积 U-Net 加 attention 层;DiT(扩散 Transformer)之后才被 patch 化的 Transformer 取代;
- ConvNeXt(Liu 等 2022):把 ResNet 按 Transformer 的设计(大核、更少的归一化、GELU、倒 bottleneck)现代化之后,纯卷积网络在 ImageNet 上追平了 Swin Transformer——说明 ViT 的优势有相当一部分来自训练配方而非结构本身。
对算法工程师,卷积今天要懂到的程度是:知道它是带约束的线性层、会算参数与 FLOPs、知道 patch embedding 是它、能读懂 encoder 前端的几层。设计新的 CNN 骨干不再是主流工作。
七、案例:复现 LeNet-5,以及 plain vs residual
0. LeNet-5:6 万参数的 1998 年网络
问题与数据:MNIST,与 L2 第四篇(KNN 2.95%)、第五篇(RBF-SVM 1.43%)、本系列第一篇(两层 MLP 2.39%)同一份数据、同一个划分。1998 年 LeCun 等在这份数据上报了 LeNet-5 0.95% 的错误率,SVM 1.1%——卷积网络第一次在公开对比里领先。这一节把第四章那张图里的网络一层层写出来、训一遍、和前面三种方法对照。
思路:按原图的 C1-S2-C3-S4-C5-F6-OUT 七层照搬,只把 1998 年的三处改成今天的写法——tanh → ReLU、平均池化 → 最大池化、RBF 输出层 → softmax;结构、每层的通道数和核大小一个不改。
class LeNet5(nn.Module):
    def __init__(self):
        super().__init__()
        self.c1 = nn.Conv2d(1, 6, 5, padding=2)     # 28×28 补到 32×32 再卷 → 6@28×28
        self.c3 = nn.Conv2d(6, 16, 5)               # 6@14×14 → 16@10×10
        self.c5 = nn.Linear(16 * 5 * 5, 120)        # 原文 C5 是 16@5×5 → 120 的卷积,核正好覆盖全图,等价于全连接
        self.f6 = nn.Linear(120, 84)
        self.out = nn.Linear(84, 10)

    def forward(self, x):
        x = F.max_pool2d(F.relu(self.c1(x)), 2)     # C1 → S2
        x = F.max_pool2d(F.relu(self.c3(x)), 2)     # C3 → S4
        x = x.flatten(1)                            # 16@5×5 → 400
        return self.out(F.relu(self.f6(F.relu(self.c5(x)))))
逐层形状与参数量(case_05_lenet5.py 用一次前向打印出来):
| 层 | 输出形状 | 参数 |
|---|---|---|
| 输入 | \([1, 28, 28]\) | |
| C1 卷积 5×5,1 → 6 | \([6, 28, 28]\) | 156 |
| S2 池化 2×2 | \([6, 14, 14]\) | 0 |
| C3 卷积 5×5,6 → 16 | \([16, 10, 10]\) | 2,416 |
| S4 池化 2×2 | \([16, 5, 5]\) | 0 |
| 拉平 | \([400]\) | |
| C5 全连接 400 → 120 | \([120]\) | 48,120 |
| F6 全连接 120 → 84 | \([84]\) | 10,164 |
| 输出 84 → 10 | \([10]\) | 850 |
| 合计 | 61,706 |
第二章的公式在这里对上数:C1 是 \(6 \times (1 \times 5 \times 5 + 1) = 156\),C3 是 \(16 \times (6 \times 5 \times 5 + 1) = 2{,}416\)。两个卷积层合起来只有 2,572 个参数,96% 的参数在三个全连接层——这就是第四章说的”AlexNet 6000 万参数里 5800 万在全连接层”的 1998 年版本,也是后来 GoogLeNet 用全局平均池化砍掉全连接层的原因。
效果(AdamW,one-cycle 学习率,5 个 epoch,MPS 上 10 秒):
| epoch | 训练 loss | 测试准确率 |
|---|---|---|
| 1 | 0.733 | 97.10% |
| 2 | 0.088 | 98.04% |
| 3 | 0.048 | 98.85% |
| 4 | 0.030 | 99.15% |
| 5 | 0.019 | 99.18% |
| 方法 | 参数 | 测试错误率 | 出处 |
|---|---|---|---|
| KNN,\(k = 3\) | 0(存 60,000 张) | 2.95% | L2 第四篇 |
| 两层 MLP 784-256-10 | 203,530 | 2.39% | 本系列第一篇 |
| RBF-SVM | 16,122 个支持向量 | 1.43% | L2 第五篇 |
| LeNet-5(1998 原文) | 60K | 0.95% | LeCun 等 1998 |
| LeNet-5(本节复现,5 个 epoch) | 61,706 | 0.82% |
参数是 MLP 的 1/3,错误率降到 1/3。卷积赢在第二章那两条约束:每个 5×5 的核在整张图上共享,同一个笔画特征出现在哪都认得;池化让它对几个像素的平移不敏感。MLP 把图拉直成 784 维向量,”相邻像素相关”这条信息它得自己从数据里学,LeNet-5 把它写进了结构。
第一层学到了什么:
6 个核里能认出几个方向的边缘检测器(一侧正一侧负)——特征图 3 亮的是笔画的左侧边、特征图 4 亮的是右侧边。没有人告诉它要检测边缘,它从”把数字分对”这个目标里学出来的第一层特征,正是 Hubel & Wiesel 1959 年在猫的视觉皮层里看到的那种”对特定方向的边缘敏感”的细胞——来龙去脉那张表的第一行和最后一行在这 6 张小图里接上了。
落地还差什么:0.82% 是 1998 年的水平;今天 MNIST 的最好结果在 0.2% 以下,靠的是数据增强、更深的网络和集成——但没人再在 MNIST 上比了。LeNet-5 真正的下一步是第四章那张表:同样的范式放大到 224×224 的彩色图、1000 类、120 万张,中间隔了 14 年的算力和数据。下面第 1–3 节是本篇其余实验的代码与结果,其中”plain vs residual”是把 LeNet 式的网络加深到 20 / 56 层会怎样——第五章的答案。
1. 代码
四个实验,前两个纯 NumPy,后两个用 PyTorch(torchvision 只用来加载 ResNet-50 的结构):
# 1. 卷积 == 稀疏矩阵
def conv_as_matrix(k, H, W):            # 构造 (Ho*Wo) x (H*W) 的矩阵 M,使 conv(x,k).flatten() == M @ x.flatten()
    ...
# 2. ResNet-50 逐层数参数与 FLOPs:对每个 Conv2d / Linear 注册 forward hook,FLOPs = 2 * 输出元素数 * (C_in * kh * kw)
# 3. plain vs residual:stem(stride 2) + L × [3x3 conv, BN],forward 里一行切换 h = relu(h + out) / relu(out)
# 4. patch embedding:nn.Conv2d(3, 768, 16, stride=16) 对比 x.unfold(...) @ W.T
2. 结果
实验 1、2、4 的输出已在第二、四、六章引用。实验 3 的完整输出(MNIST 前 2 万张,3 个 epoch,SGD momentum 0.9、\(\eta = 0.05\)、裁剪 1.0,测试前用 1 万张训练图重估 BN 统计量):
L=20 plain   : init grad norm block1 1.7e+00 vs block20 1.6e-01 (ratio 10.9)  | train loss @ep1 0.460 @ep3 0.128 | test acc 96.4%
L=20 residual: init grad norm block1 1.3e+00 vs block20 3.7e-01 (ratio 3.4)   | train loss @ep1 0.224 @ep3 0.093 | test acc 96.8%
L=56 plain   : init grad norm block1 9.5e+02 vs block56 3.3e-01 (ratio 2849)  | train loss @ep1 1.676 @ep3 0.724 | test acc 70.9%
L=56 residual: init grad norm block1 2.2e+00 vs block56 7.6e-01 (ratio 2.9)   | train loss @ep1 0.268 @ep3 0.129 | test acc 96.1%
四个实验里前三个在笔记本 CPU 上几秒钟,实验 3 的四个配置约 9 分钟(56 层的两个占了三分之二)。
3. 值得自己动手的扩展
- 把实验 3 的 BN 去掉、给残差分支零初始化(\(f(x) = 0\),块在初始时刻是恒等),看没有 BN 的残差网络能否训——这是 Fixup / SkipInit 一类工作的起点;
- 用
conv_as_matrix构造 stride 2 或 padding 的卷积矩阵,看稀疏模式怎么变; - 把 ViT 的 patch 从 16 改到 8,token 数变 4 倍,用 04 系列第十篇的公式算 attention 的 FLOPs 变了多少倍。
八、本文小结
- 卷积是带两条约束的线性层:局部性(矩阵稀疏)与参数共享(各行是同一核的平移)。\(3 \times 3\) 核在 \(6 \times 6\) 图上是一个 \(16 \times 36\) 矩阵、144 个非零、9 个自由参数;ResNet-50 一个卷积层的等价全连接矩阵有 \(4 \times 10^{10}\) 个元素。参数量与图像大小无关,FLOPs 与之成正比(ResNet-50:25.6M 参数、8.2 GFLOPs、每个参数用 320 次)。
- 深度是为了感受野:\(1 + 2L\),stride 与池化把它乘上去;深了就遇到第二篇的全部问题。VGG 止于 19 层,BN 修前向,残差修反向,ResNet 到 152 层。
- 五个里程碑各留下一样东西:ReLU 与 GPU(AlexNet)、小核堆深(VGG)、\(1 \times 1\) 卷积与全局池化(GoogLeNet)、残差 + BN + 堆同样的块(ResNet)。Bottleneck 块用 \(1 \times 1\) 降维把参数压 17 倍;\(1 \times 1\) 卷积就是逐位置的线性层,与 Transformer 的 FFN 同类。
- 退化问题复现:plain 网络 20 → 56 层训练 loss 从 0.13 恶化到 0.72,残差网络不变;有 BN 的深 plain 网络梯度向输入方向爆炸(第 1 块是第 56 块的 2849 倍),残差把比值压到 3。ResNet-v2 的 pre-activation 是 Pre-Norm 的前身。
- ViT:数据足够多时卷积的先验成为负担;把图切成 \((H/p)(W/p)\) 个 patch、线性投影成 token、送进标准 encoder。Patch embedding 就是 kernel = stride = \(p\) 的卷积(实测差 \(10^{-6}\),590,592 个参数)。一张 224 图是 196 个 token,CLIP-336 是 576,原生分辨率 1024² 是 5476——这是多模态成本的起点。
- 卷积退到了 patch embedding、语音前端、U-Net 与 ConvNeXt;懂到”带约束的线性层 + 会算账 + 认得出 patch embedding”即可。
- 下一篇:另一条线——循环网络怎么处理序列、为什么记不住远处、attention 如何从它的瓶颈里被发明出来。
配套代码:deep-learning-foundations/05_cnn.py——matrix / resnet / patch / deep 四个子实验,deep(L=20 / 56 的 plain 与 residual)在 CPU 上约 10 分钟;第七章的 LeNet-5 复现是 case_05_lenet5.py(MPS / CPU 均可,10 秒到 1 分钟);原论文结构图由 tools/paper_figures.py 从 PDF 裁出。
九、自测
-
\(3 \times 3\) 卷积、输入 64 通道、输出 128 通道:参数量多少?在 \(56 \times 56\) 的 feature map 上 FLOPs 多少?把图放大到 \(112 \times 112\) 各怎么变?
答案
参数 \(3 \times 3 \times 64 \times 128 = 73{,}728\)(+128 偏置);FLOPs \(\approx 2 \times 56 \times 56 \times 73{,}728 \approx 462\) M;图放大 4 倍(面积),参数不变、FLOPs 变 4 倍。
-
stride 为 1 的 \(3 \times 3\) 卷积堆 10 层,感受野多大?中间插一个 stride 2 的下采样后再堆 10 层呢?
答案
\(1 + 2 \times 10 = 21\);下采样后每层扩大的感受野在原图上翻倍:\(21 + 2 \times 10 \times 2 = 61\)。stride 与池化是让感受野快速覆盖全图的办法。
-
ResNet-50 的 bottleneck 块(256 → 64 → 64 → 256)为什么比两个 \(3 \times 3\) 的 256 → 256 少 17 倍参数?\(1 \times 1\) 卷积在做什么?
答案
昂贵的 \(3 \times 3\) 在 4 倍窄的通道上做:\(16\text{K} + 37\text{K} + 16\text{K} = 69\)K 对 \(1.18\)M。\(1 \times 1\) 卷积没有空间感受野,是对每个位置独立做一次线性变换——与 Transformer 里逐 token 的 FFN 是同一种算子。
-
ViT-B/16 处理一张 \(224 \times 224\) 图是多少个 token?patch embedding 的参数量是多少?CLIP-336 呢?
答案
\((224/16)^2 = 196\) 个 token(+1 个 CLS);patch embedding 是 \(3 \times 16 \times 16 \to 768\) 的线性层:\(768 \times 768 + 768 = 590{,}592\);336 分辨率、patch 14:\((336/14)^2 = 576\) 个 token。
-
plain 网络从 20 层加到 56 层训练 loss 反而变差(0.13 → 0.72),这是过拟合吗?有 BN 的深 plain 网络梯度出了什么问题?
答案
不是——训练 loss 变差是优化失败(退化问题),过拟合是训练好、测试差。有 BN 的深 plain 网络梯度向输入方向爆炸:第 1 块的梯度范数是第 56 块的 2849 倍;残差把比值压到 3。
-
等价矩阵的行数是输出位置数、列数是输入位置数——\(6 \times 6\) 图上是 \(16 \times 36\),576 个元素里只有 144 个非零、且这 144 个只由 9 个自由参数生成(局部性 + 参数共享);ResNet-50 一个卷积层的等价矩阵有 \(4 \times 10^{10}\) 个元素。所以卷积是带两条约束的线性层,参数量与图像大小无关、FLOPs 与之成正比。详见第二章。 ↩
-
是。ResNet 的 \(x + f(x)\) 与 Transformer 每层的两个残差块都是把 Jacobian 变成 \(I + J\);ResNet-v2 的 pre-activation 就是 Pre-Norm 的前身。本文复现退化问题——plain 网络 20 → 56 层训练 loss 从 0.13 恶化到 0.72,残差网络不变。详见第五章。 ↩
-
卷积的先验(局部、平移不变)在数据少时是优势、数据多时是限制;把图切成 \((H/p)(W/p)\) 个 patch 线性投影成 token 送进标准 encoder,二维结构只靠位置编码——而这个 patch embedding 本身就是 kernel = stride = \(p\) 的卷积(实测差 \(10^{-6}\)),卷积没有消失,退到了第一层。详见第六章。 ↩
系列 《深度学习基础:从反向传播到残差》 第 5 / 7 篇
系列总览 — 为什么这样组织、读它需要什么、读完能做什么 · 幻灯片 — 整个系列的精华,一份可分享的 deck
- 反向传播——手推一个两层网络
- 训练为什么不稳定——初始化、归一化与残差
- 优化器——从 SGD 到 AdamW 与学习率调度
- 正则化与泛化——为什么参数比样本多却不过拟合
- CNN——从 LeNet 到 ResNet,再到 ViT
- RNN——从 LSTM 到 attention 的诞生
- 系列总结与通关自测
本文由 arganzheng 创作,采用 CC BY 4.0 许可协议。在保留原文作者、署名以及完整原文链接(https://arganzheng.life/cnn-from-lenet-to-resnet-and-vit.html)的前提下,欢迎各种形式的转载、翻译或商业引用。
COMMENTS
评论存放在 GitHub Discussions, 用 GitHub 账号登录即可发表,支持 Markdown。 想针对正文某句话说?选中那段文字,点浮出的「评论」即可划线评论;觉得哪里写错了,发表时勾上「同时提交 Issue」。 有人回复你时 GitHub 会按你的通知设置发邮件,不用守在这里。