系列 《深度学习基础:从反向传播到残差》 第 3 / 7 篇
系列总览 — 为什么这样组织、读它需要什么、读完能做什么 · 幻灯片 — 整个系列的精华,一份可分享的 deck
- 反向传播——手推一个两层网络
- 训练为什么不稳定——初始化、归一化与残差
- 优化器——从 SGD 到 AdamW 与学习率调度
- 正则化与泛化——为什么参数比样本多却不过拟合
- CNN——从 LeNet 到 ResNet,再到 ViT
- RNN——从 LSTM 到 attention 的诞生
- 系列总结与通关自测
打开任何一份 LLM 技术报告的训练配置,会看到同一组数字:AdamW,\(\beta_1 = 0.9\),\(\beta_2 = 0.95\),weight decay 0.1,梯度裁剪 1.0,warmup 2000 步,cosine 衰减到峰值的 10%。这组数字从 GPT-3 到 Llama-3 几乎没变过,以至于很少有人再问它们是从哪来的。本篇把每一个数字拆开:它在公式里的位置、它解决的问题、改了会怎样、以及为什么优化器状态要占每参数 8 字节。
主线从最简单的 SGD 开始,每加一个部件就问两个问题——它改变了更新量的哪个性质、代价是什么。Momentum 改变了方向的平滑度,Adam 改变了每个参数的步长尺度,weight decay 改变了参数范数的平衡点,warmup 与调度改变了步长随时间的形状,裁剪改变了步长的上界。每一项都用同一个网络测出来。全篇的核心问题是:
Adam 的两个矩各在做什么?1 为什么 AdamW 与在 loss 里加 \(L_2\) 不一样?2 warmup 为什么在 Adam 下几乎不能省?3 batch 变大时学习率该怎么变、变到哪里为止?4
一、总览:五个部件与它们的代价
1. 一步更新的解剖
从梯度 \(g_t\) 到参数更新 \(\Delta\theta_t\),现代优化器做了五件事:
| 部件 | 公式里的位置 | 改变了什么 | 代价 | 章 |
|---|---|---|---|---|
| SGD | \(\Delta\theta = -\eta\, g\) | 基线:沿负梯度走 \(\eta\) | 梯度噪声 \(\propto 1/B\) 限制 \(\eta\) | 二 |
| Momentum | \(m \leftarrow \beta m + g\) | 平滑方向:一致的方向累积、震荡的方向抵消;有效学习率 \(\eta / (1 - \beta)\) | 每参数 4 字节状态 | 三 |
| Adam | \(\Delta\theta = -\eta\, \hat m / (\sqrt{\hat v} + \epsilon)\) | 每个参数自己的步长尺度:更新量 \(\approx \eta\) 而与梯度大小无关 | 每参数 8 字节状态;初期估计不准 | 四 |
| Weight decay | \(\theta \leftarrow \theta - \eta\lambda\theta\) | 参数范数的平衡点 | 与 \(L_2\) 在 Adam 下不等价 | 五 |
| 调度与裁剪 | \(\eta_t\) 随 \(t\) 变;\(g \leftarrow g \cdot \min(1, c / |g|)\) | 步长随时间的形状;步长的上界 | 多几个超参数 | 六、七 |
五个部件在一步 AdamW 更新里的位置——梯度进来,经过裁剪、两个矩、调度后的学习率,最后与一条不经过任何矩的 weight decay 支路相加:
%%{init: {"flowchart": {"wrappingWidth": 200}}}%%
%% 图:一步 AdamW 更新的解剖:梯度经裁剪、两个矩、学习率调度,weight decay 走一条不经过矩的支路
flowchart LR
    G["梯度 g_t"] --> C["裁剪
g ← g · min(1, c/‖g‖)"]
    C --> M["`**一阶矩 m**
m ← β₁m + (1−β₁)g
(Momentum:方向)`"]
    C --> V["`**二阶矩 v**
v ← β₂v + (1−β₂)g²
(每参数的尺度)`"]
    M --> D["m̂ / (√v̂ + ε)
量级 ≈ 1,与 g 大小无关"]
    V --> D
    D --> LR["× η_t
(warmup / cosine / WSD)"]
    TH["参数 θ"] --> WD["`**weight decay**
η_t · λ · θ`"]
    LR --> UPD(("−"))
    WD --> UPD
    UPD --> NEW["θ_new"]

    classDef st fill:#fff7e0,stroke:#c98a00,stroke-width:2px,color:#222
    classDef sched fill:#eef6ff,stroke:#5b8fd6,color:#222
    class M,V st
    class LR,WD sched
黄色是两份与参数同形的状态(每参数 8 字节,第八章的账);weight decay 那条路直接从 \(\theta\) 出发绕过了矩的归一化——这正是 AdamW 与”在 loss 里加 \(L_2\)“的区别(第五章),后者的 \(\lambda\theta\) 会混进 \(g\) 再被 \(\sqrt{v}\) 除掉。
2. 本文的章节安排
| 章 | 主题 | 内容 |
|---|---|---|
| 二 | SGD 与它的噪声 | 无偏估计、方差与 1/B、线性 scaling 规则的推导与失效点;实测到 B=512 成立、2048 发散 |
| 三 | Momentum | 指数移动平均、有效学习率放大 1/(1−β)、Nesterov |
| 四 | Adam | 两个矩、偏差修正、第一步的更新量恰好是 η、β₂ 的记忆窗、ε、每参数 8 字节 |
| 五 | AdamW 与 L2 的区别 |
|
| 六 | 学习率调度 | warmup 为什么几乎不能省(大学习率下)、cosine 与 WSD、衰减到多少、峰值学习率的量级与宽度的关系 |
| 七 | 梯度裁剪 | 全局范数裁剪的公式、对 SGD 与 Adam 各做了什么、梯度范数曲线怎么读 |
| 八 | 优化器状态的账 |
|
| 九 | 案例:同一个 MNIST MLP,五个部件各试一遍 |
|
| 十 | 本文小结 | |
| 十一 | 自测 | 5 道题 |
3. 来龙去脉:七十年里加的五个部件
| 年 | 谁 | 当时的问题 | 留下的东西 |
|---|---|---|---|
| 1951 | Robbins & Monro | 只能拿到带噪声的观测,怎么找一个函数的零点 / 极值 | 随机近似:每步用一个噪声样本的梯度走一小步,学习率逐步减小——SGD 的数学(第二章) |
| 1964 | Polyak | 梯度下降在狭长的山谷里来回震荡、走得慢 | Momentum(重球法):把历史梯度平均,震荡抵消、一致的方向累积(第三章) |
| 1983 | Nesterov | Momentum 冲过头才刹车 | 先按动量方向预走一步再算梯度(NAG),收敛率有理论保证 |
| 2011 | Duchi 等,AdaGrad | 稀疏特征(词向量)里,常见词和罕见词的梯度差几个量级,一个学习率顾不了两头 | 每个参数一个学习率:用历史梯度平方和的平方根去除——Adam 的 \(v\) 从这里来 |
| 2012 | Tieleman & Hinton,RMSProp(课程讲义) | AdaGrad 的平方和只增不减,学习率最终归零 | 平方和换成指数移动平均——\(v\) 会忘 |
| 2014 | Kingma & Ba,Adam | 把 Momentum 和 RMSProp 合起来,再修好初期偏差 | Adam(第四章):\(m\)、\(v\) 两个矩 + 偏差修正;默认超参 \((0.9, 0.999, 10^{-8})\) 十年没变 |
| 2017 | Loshchilov & Hutter,AdamW | Adam 上 weight decay 效果不对——比 SGD + wd 差 | 把 wd 从梯度里拿出来直接作用于参数(第五章);LLM 全部用它 |
| 2017 | Goyal 等(Facebook) | 用 8,192 的 batch 一小时训完 ImageNet,学习率怎么定 | 线性 scaling 规则 + warmup(第二、六章):LLM 训练配置的两条默认 |
| 2018 / 2024 | Shazeer & Stern,Adafactor;Zhao 等,GaLore | 优化器状态 8 字节 / 参数,比模型本身还大 | 分解 / 低秩存 \(v\)(第八章)——省状态是大模型时代的新问题 |
七十年只做了一件事:让步长更合理。Robbins–Monro 说”带噪声的梯度也能走”,Momentum 说”方向要平均”,AdaGrad / RMSProp / Adam 说”每个参数的步长要归一”,AdamW 说”衰减别混进步长里”,warmup 说”一开始步子要小”。今天 LLM 配置里那一行 AdamW(lr, betas=(0.9, 0.95), weight_decay=0.1) + warmup + cosine,就是这张表从上到下叠出来的。什么时候不用 Adam:卷积网络的图像分类至今 SGD + Momentum 常常泛化更好(AdamW 论文的动机之一);参数太多存不下两份状态(第八章)。
二、SGD 与它的噪声
1. 无偏但有噪声
全量梯度 \(\nabla L(\theta) = \frac{1}{N}\sum_i \nabla \ell_i(\theta)\) 太贵,用一个大小为 \(B\) 的 batch 估计:\(g_B = \frac{1}{B}\sum_{i \in \text{batch}} \nabla \ell_i\)。它是无偏的(\(\mathbb{E}[g_B] = \nabla L\)),方差是单样本梯度方差的 \(1/B\):
\[\text{Cov}(g_B) \approx \frac{1}{B}\, \Sigma, \qquad \Sigma = \text{Cov}_i(\nabla \ell_i)\]一步 SGD \(\theta \leftarrow \theta - \eta g_B\) 于是等于”沿真梯度走 \(\eta\),再加一个方差为 \(\eta^2 \Sigma / B\) 的随机扰动”。噪声不全是坏事——它帮助逃离鞍点、有正则化效果(下一篇)——但它决定了 \(\eta\) 的上限:噪声的尺度 \(\eta / \sqrt{B}\) 太大,参数就在最优点附近乱跳而不收敛。
2. 线性 scaling 规则
由此得到一个直接的推论。\(k\) 步 batch 为 \(B\)、学习率 \(\eta\) 的 SGD,总位移是 \(-\eta \sum_{j=1}^{k} g_{B}^{(j)}\);一步 batch 为 \(kB\)、学习率 \(k\eta\) 的 SGD,位移是 \(-k\eta\, g_{kB} = -\eta \sum_{j=1}^{k} g_{B}^{(j)}\)(把大 batch 拆成 \(k\) 个小 batch)。如果这 \(k\) 步之内梯度基本不变,两者走到同一个地方。这就是 Goyal 等 2017 的线性 scaling 规则:batch 乘 \(k\),学习率乘 \(k\),训练轨迹近似不变,而每个样本的计算量不变、步数少 \(k\) 倍——这是大 batch 训练的全部动机。
3. 规则在哪里失效
“梯度在 \(k\) 步内基本不变”在 \(k\eta\) 大到一定程度后不成立:学习率超过 loss 曲面曲率允许的上限(对二次函数是 \(2/\lambda_{max}\)),一步就跨过最优点,发散。第九章的实验:SGD、\(\eta = 0.05 \times B / 32\)、固定 4 个 epoch 的样本预算,\(B = 32, 128, 512\) 三组的最终 loss 是 0.049、0.048、0.054,准确率都在 96.1% 左右——规则成立;\(B = 2048\)(\(\eta = 3.2\))第 32 步 NaN,\(B = 8192\) 第 15 步 NaN——规则失效。存在一个临界 batch(McCandlish 等 2018),低于它加 batch 几乎免费,高于它加 batch 只是浪费样本。它由梯度噪声的尺度决定,训练过程中随 loss 下降而增大——这是 LLM 预训练用”batch 逐步增大”的 warmup 策略的依据。
Adam 下这个规则变成平方根:\(\eta \propto \sqrt{B}\),因为 Adam 的更新量已经被 \(\sqrt{v}\) 归一,噪声对步长的影响与 SGD 不同。两条规则都是经验近似,做实验时以小规模扫描为准。
三、Momentum
1. 指数移动平均
Momentum 不直接用 \(g_t\),而用它的指数移动平均:
\[m_t = \beta\, m_{t-1} + g_t, \qquad \theta \leftarrow \theta - \eta\, m_t\]展开 \(m_t = \sum_{j=0}^{t} \beta^j g_{t-j}\):过去的梯度按 \(\beta^j\) 衰减地加进来。梯度方向一致时,\(m\) 累积到 \(g / (1 - \beta)\)——\(\beta = 0.9\) 时是 \(10 g\),有效学习率是 \(\eta\) 的 10 倍;方向来回震荡时相邻项抵消,\(m\) 很小。第九章的实验与此一致:SGD 最优学习率 0.3,Momentum 0.9 的最优学习率 0.03,差恰好 10 倍,结果相近(93.8% 与 93.9%)。
PyTorch 的 SGD(momentum=0.9) 就是这个形式;有的实现写成 \(m_t = \beta m_{t-1} + (1 - \beta) g_t\),此时不放大学习率,两者只差一个常数因子。Nesterov 动量在计算梯度前先按动量方向走一步(nesterov=True),理论上收敛更快,实践差别不大。
2. 代价
每个参数多一个与它同形状的状态 \(m\),fp32 下 4 字节。这是本篇要算的”每参数 8 字节”的第一个 4。
四、Adam
1. 两个矩
Adam(Kingma & Ba 2014)同时维护梯度的一阶矩与二阶矩的指数移动平均:
\[m_t = \beta_1 m_{t-1} + (1 - \beta_1) g_t, \qquad v_t = \beta_2 v_{t-1} + (1 - \beta_2) g_t^2\] \[\hat m_t = \frac{m_t}{1 - \beta_1^t}, \quad \hat v_t = \frac{v_t}{1 - \beta_2^t}, \qquad \theta \leftarrow \theta - \eta\, \frac{\hat m_t}{\sqrt{\hat v_t} + \epsilon}\]这就是 Kingma & Ba 2014 论文里的算法框——十年来所有框架的 Adam 实现的就是这十行:
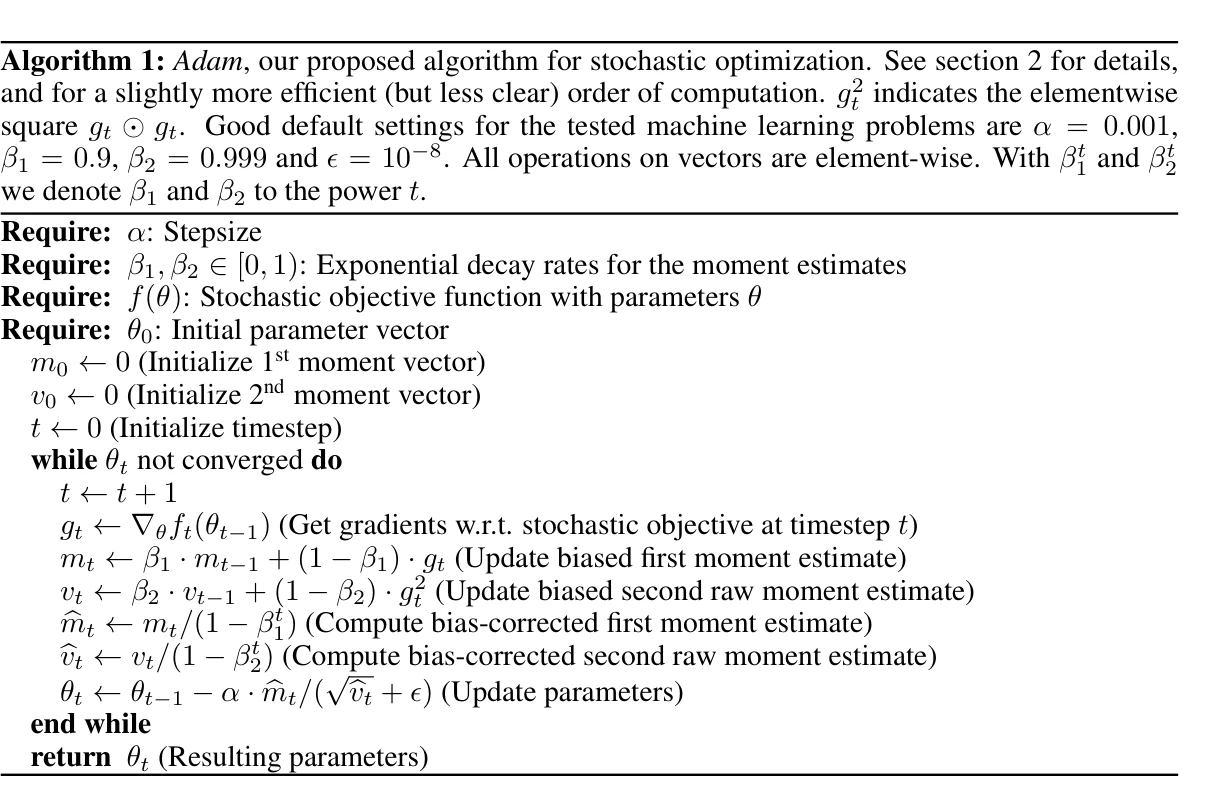
\(m\) 是 Momentum(归一化形式)。\(v\) 是每个参数梯度平方的平均,\(\sqrt{v}\) 是梯度的典型幅度;用它去除,更新量 \(\hat m / \sqrt{\hat v}\) 是一个无量纲的、量级约为 1 的数——梯度一直很大的参数和梯度一直很小的参数,每步走的距离都约等于 \(\eta\)。这是 Adam 与 SGD 的本质区别:SGD 的步长与梯度成正比,Adam 的步长与梯度无关,只由 \(\eta\) 决定。它让一个学习率适用于梯度尺度相差几个量级的所有参数(embedding、norm 的增益、深层与浅层的权重),是 Adam 成为默认优化器的原因。
2. 偏差修正与第一步
\(m_0 = v_0 = 0\),前几步的 \(m_t, v_t\) 系统性地偏小:\(\mathbb{E}[m_t] = (1 - \beta_1^t)\, \mathbb{E}[g]\)(假设 \(g\) 平稳)。除以 \((1 - \beta^t)\) 就是偏差修正。它对第一步的影响可以精确算出:\(t = 1\) 时 \(\hat m_1 = g_1\),\(\hat v_1 = g_1^2\),更新量是
\[\frac{\hat m_1}{\sqrt{\hat v_1}} = \frac{g_1}{|g_1|} = \text{sign}(g_1)\]| 有偏差修正时,第一步每个参数都移动 \(\eta\)(梯度非零、$$\epsilon \ll | g | \(、不算 weight decay 那一项时),与梯度大小无关。第九章实测最大\)\lvert \text{更新量} \rvert / \eta = 1.00\(。没有偏差修正时是\)(1 - \beta_1) / \sqrt{1 - \beta_2}\(:\)\beta_2 = 0.999\(下是 3.16(实测 3.16),\)\beta_2 = 0.95$$ 下是 0.45。 |
这一行解释了 warmup 为什么在 Adam 下几乎不能省(第六章):训练开始时 \(v\) 还没有学到梯度的真实尺度,更新量 \(\approx \eta \cdot \text{sign}(g)\),每个参数都在以满步长乱走。(”满步长”是有偏差修正时稳态下的典型上界;下一节说到 \(v\) 反应慢、\(m/\sqrt v\) 暂时大于 1 的情形,更新量可以超过 \(\eta\),两处不矛盾——一个是第一步的精确值,一个是之后的瞬态。)
3. β₂ 的记忆窗
指数移动平均的等效记忆长度约为 \(1 / (1 - \beta)\) 步:\(\beta_1 = 0.9\) 记 10 步,\(\beta_2 = 0.999\) 记 1000 步,\(\beta_2 = 0.95\) 记 20 步。默认的 0.999 让 \(v\) 反应很慢:梯度幅度突然变大(一个异常 batch、loss spike 的开端)时,\(v\) 要几百步才跟上,这期间 \(m / \sqrt{v}\) 会远大于 1,更新过大,spike 被放大。LLM 训练把 \(\beta_2\) 降到 0.95(GPT-3 起),让 \(v\) 在 20 步内跟上梯度尺度的变化——牺牲一点估计的平滑,换稳定性。
\(\epsilon\)(默认 \(10^{-8}\))防止除零,也在 \(\sqrt{v} \ll \epsilon\) 时把 Adam 退化成 SGD。梯度极小的参数(某些 embedding 行)会受它影响;一般不动。
4. 代价
两个与参数同形状的状态,fp32 下 8 字节 / 参数。加上混合精度训练里的 fp32 主权重(04 系列第十一篇)4 字节,就是 L1 工具箱系列那张显存账里 16 字节的 12。Llama-3-8B:\(m\) 与 \(v\) 共 \(8.03 \times 10^9 \times 8 = 64\) GB。第九章的小网络也一样:参数 795 KiB,Adam 状态 1590 KiB。
五、AdamW 与 L2 正则的区别
1. 两种”衰减”
\(L_2\) 正则在 loss 里加 \(\frac{\lambda}{2}\|\theta\|^2\),梯度多出一项 \(\lambda\theta\),随梯度一起进优化器。在 SGD 下,\(\theta \leftarrow \theta - \eta(g + \lambda\theta) = (1 - \eta\lambda)\theta - \eta g\)——参数每步按 \((1 - \eta\lambda)\) 衰减,这就是 weight decay。在 SGD 下两者等价。
在 Adam 下不等价。\(L_2\) 的 \(\lambda\theta\) 混进 \(g\) 后被 \(\sqrt{v}\) 归一化:衰减量变成 \(\eta\lambda\theta / \sqrt{v}\)。梯度大的参数(\(\sqrt{v}\) 大)几乎不衰减,梯度小的参数衰减极强——与”让所有参数均匀地向零收缩”的初衷相反。Loshchilov & Hutter 2017 提出把衰减从梯度里拿出来、直接作用在参数上:
\[\theta \leftarrow \theta - \eta\lambda\theta - \eta\, \frac{\hat m}{\sqrt{\hat v} + \epsilon}\]这是 AdamW(decoupled weight decay)。衰减量 \(\eta\lambda\theta\) 与梯度无关,对所有参数一致。
2. 实测:同一个 λ,两个世界
第九章在同一个两层网络上用 \(\lambda = 0.1\)、\(\eta = 10^{-3}\) 训 2 个 epoch:
| \(|W_1|_F\) | \(|W_2|_F\) | 准确率 | |
|---|---|---|---|
| 初始 | 22.65 | 4.51 | — |
| AdamW | 23.59 | 4.86 | 95.6% |
| Adam + \(L_2\) | 2.33 | 2.16 | 86.2% |
\(W_1\) 的梯度很小(\(\sqrt{v}\) 均值约 \(10^{-3}\)),而 \(\lambda\theta\) 的典型值是 \(0.1 \times 0.088 \approx 9 \times 10^{-3}\),比梯度大一个量级——归一化之后 \(L_2\) 项主导,更新量 \(\approx \eta \cdot \text{sign}(\theta)\),每个元素每步向零走 \(10^{-3}\),938 步后元素量级从 0.088 掉到接近零,范数从 22.6 到 2.3。AdamW 的衰减是 \(\eta\lambda = 10^{-4}\) / 步,938 步累计 \(e^{-0.094} \approx 0.91\),几乎没动。同一个 \(\lambda = 0.1\),一个把网络训坏了,一个几乎没有作用——“weight decay 0.1”这个数只在 AdamW 的语义下有意义。
3. LLM 里 weight decay 的真实含义
按 AdamW 的公式,累计衰减因子是 \(\exp(-\lambda \sum_t \eta_t)\)。LLM 预训练 \(\lambda = 0.1\)、峰值 \(\eta\) 约 \(3 \times 10^{-4}\)、几十万到上百万步,\(\lambda \sum_t \eta_t\) 是几十——如果只有衰减,权重早就是零了。实际发生的是平衡:梯度更新把范数往外推(Adam 每步 \(\approx \eta\) 的随机游走让范数以 \(\sqrt{t}\) 增长),衰减往里拉,两者在某个范数上达到平衡。对有归一化层跟随的权重(上一篇第四章的尺度不变性),这个平衡范数决定了有效学习率——范数大则同样的 \(\eta\) 产生的角度变化小。所以 LLM 里的 weight decay 与其说是正则化,不如说是控制参数范数、进而控制有效学习率的旋钮。这也是为什么 norm 的增益与 bias 通常不加 weight decay(它们没有尺度不变性可利用),而 embedding 是否加各家不同。
六、学习率调度
1. Warmup 为什么必须
第四章第 2 节给了根本原因:Adam 训练初期 \(v\) 不可靠,更新量取最大值 \(\eta \cdot \text{sign}(g)\)。此时如果 \(\eta\) 就是峰值,所有参数同时以最大步长向各自梯度的方向跳,深网络里这会立刻把上一篇建立的平衡打破。Warmup 在前几百到几千步把 \(\eta\) 从 0 线性升到峰值,给 \(v\) 时间学到真实尺度。上一篇的 Post-Norm 初期梯度大,是 warmup 的第二个理由。
第九章在 64 层 Pre-Norm 网络上、Adam \(\beta_2 = 0.95\):
| 峰值 \(\eta\) | warmup | 第 5–100 步的最大 loss | 第 20 步 loss | 400 步后 |
|---|---|---|---|---|
| \(10^{-3}\) | 0 | — | 0.649 | 0.205 |
| \(3 \times 10^{-3}\) | 0 | 2.84 | 0.853 | 0.157 |
| \(3 \times 10^{-3}\) | 100 步 | 1.02 | 0.606 | 0.216 |
| \(10^{-2}\) | 0 | 4.59 | 2.123 | 0.226 |
| \(10^{-2}\) | 100 步 | 1.26 | 0.659 | 0.188 |
\(\eta = 10^{-2}\) 不加 warmup 时,前 100 步里 loss 冲到 4.59——高于随机初始化的 \(\ln 10 = 2.30\),网络被打到比随机还差再慢慢爬回来;加 100 步 warmup 最高 1.26。小学习率下 warmup 看不出差别,学习率越大差别越大——而 LLM 训练总是想用尽可能大的学习率。
2. Warmup 之后:cosine 与 WSD
峰值之后学习率要降下来,让参数在 loss 谷底停住而不是来回跳(第二章的噪声尺度 \(\eta / \sqrt{B}\))。两种主流形状:
Cosine:\(\eta_t = \eta_{min} + \frac{1}{2}(\eta_{max} - \eta_{min})(1 + \cos(\pi t / T))\),平滑地从峰值降到 \(\eta_{min}\),通常取峰值的 10%(Llama、GPT-3)而不是 0——降到 0 的最后一段几乎不学东西。缺点是必须预先知道总步数 \(T\),中途想多训一会儿就要重新规划。
WSD(warmup-stable-decay,Hu 等 2024 MiniCPM):warmup 后在峰值保持恒定,最后 10–20% 的步数快速衰减。恒定阶段可以随时延长、从任意点分叉出一个衰减段得到一个可用的模型,对”训到什么时候停”不确定的预训练更灵活;实验表明最终 loss 与 cosine 相当或更好。Llama-3 之后的一些模型用它或它的变体。
 η   cosine(要预先知道 T)                     η   WSD(恒定段可随时延长)
峰值 ┤   ╭╮                                  峰值 ┤   ╭─────────────────────╮
     │  ╱  ╲                                      │  ╱                       │
     │ ╱    ╲                                     │ ╱                        │
     │╱      ╲                                    │╱                         │
     │        ╲                                   │                          │
     │         ╲_                                 │                          │
 10% ┤           ╲___________                 10% ┤                          ╲
   0 ┼──┬────────────────────────┬──► t         0 ┼──┬─────────────────────┬──┬──► t
     warmup                      T                 warmup            衰减开始   T
两者共同的经验:衰减阶段才是 loss 大幅下降的阶段——恒定学习率下 loss 在一个由噪声决定的水平上震荡,学习率一降噪声就小,loss 立刻掉下去。看到 loss 曲线在衰减开始处有个明显的下折,是正常的。
3. 峰值学习率的量级
| 场景 | 典型峰值 \(\eta\) | 说明 |
|---|---|---|
| 预训练,小模型(\(< 1\)B) | \(6 \times 10^{-4}\) 到 \(10^{-3}\) | GPT-3 125M 用 \(6 \times 10^{-4}\) |
| 预训练,大模型(\(> 10\)B) | \(1 \times 10^{-4}\) 到 \(3 \times 10^{-4}\) | GPT-3 175B 用 \(0.6 \times 10^{-4}\);Llama-3-8B 用 \(3 \times 10^{-4}\)、70B 用 \(1.5 \times 10^{-4}\) |
| SFT | \(10^{-5}\) 到 \(2 \times 10^{-5}\) | 比预训练小一个量级:已有的表示不能被打乱 |
| LoRA 微调 | \(10^{-4}\) 到 \(3 \times 10^{-4}\) | LoRA 参数从零开始,可以大 |
| RL(PPO / GRPO)的策略 | \(10^{-6}\) 到 \(5 \times 10^{-6}\) | 再小一个量级:策略每步只能微动 |
模型越宽学习率越小,不是巧合:Adam 下每个参数每步移动 \(\approx \eta\),一层的输出变化量 \(\approx \eta \times \sqrt{n_{in}}\)(\(n_{in}\) 个独立扰动相加),宽度翻 4 倍、输出变化翻 2 倍。\(\mu\)P(Yang 等 2022)把这个关系做成规则——隐层权重的学习率按 \(1 / n_{in}\) 缩放——让小模型上调好的学习率能直接用到大模型。上一篇第二章的”0.02 不随宽度变”与这里的”学习率要随宽度变”是同一个问题的两面。
七、梯度裁剪
1. 公式
按全局范数裁剪:把所有参数的梯度看成一个长向量,范数 \(\|g\|\) 超过阈值 \(c\) 时等比缩小:
\[g \leftarrow g \cdot \min\!\left(1, \frac{c}{\|g\|}\right)\]方向不变,长度不超过 \(c\)。LLM 几乎全用 \(c = 1.0\)。它只在梯度异常大时介入,正常步骤不受影响——这是它可以”一直开着”的原因。
2. 对 SGD 与 Adam 各做了什么
对 SGD,裁剪直接限制了步长上界 \(\eta c\),一个异常 batch 不再能把参数打飞。对 Adam,更新量本来就被 \(\sqrt{v}\) 归一,裁剪的作用弱一些但仍然有:异常梯度进入 \(m\) 后要 10 步才衰减掉,进入 \(v\) 后(\(\beta_2 = 0.95\))要 20 步;这期间 \(m / \sqrt{v}\) 的比例被打乱。第九章在第 200 步注入一个输入放大 50 倍的 batch(梯度范数从 0.8 跳到 46):
| 优化器 | 裁剪 | loss @199 | @210 | @250 | @600 |
|---|---|---|---|---|---|
| SGD + Momentum | 无 | 0.188 | 1.181 | 0.483 | 0.699 |
| SGD + Momentum | 1.0 | 0.199 | 0.145 | 0.188 | 0.421 |
| Adam | 无 | 0.178 | 0.252 | 0.202 | 0.389 |
| Adam | 1.0 | 0.174 | 0.136 | 0.169 | 0.322 |
SGD 不裁剪时一个坏 batch 让 loss 从 0.19 跳到 1.18,400 步后仍没恢复到原来的水平;Adam 的损伤小但可见。裁剪之后两者都几乎无感。
3. 梯度范数曲线怎么读
梯度范数是训练里第二重要的曲线(第一是 loss)。健康的形状:初期较大、随 loss 下降而下降、后期在一个水平上小幅波动。三种病态:持续上升——学习率太大或某层失稳,spike 的前兆;周期性尖峰——数据里有周期出现的异常样本(比如每个 epoch 同一位置的坏文件);裁剪一直在介入(范数长期高于 \(c\))——说明 \(c\) 设得太小或学习率太大,裁剪变成了在系统性地缩小学习率。记录”被裁剪的步数比例”是一个便宜的健康指标。
八、优化器状态的账与更省的优化器
1. 16 字节里的 12
混合精度 + AdamW 下每个参数的训练状态:
| 项 | 精度 | 字节 | 谁需要 |
|---|---|---|---|
| 权重(计算用) | bf16 | 2 | 前向、反向 |
| 梯度 | bf16 | 2 | 反向 → 优化器 |
| 主权重 | fp32 | 4 | 优化器:bf16 精度不够累积小更新(04 系列第十一篇) |
| \(m\) | fp32 | 4 | Adam |
| \(v\) | fp32 | 4 | Adam |
后三项 12 字节全是优化器的。Llama-3-8B 是 96 GB,70B 是 847 GB——这就是 ZeRO / FSDP 要把优化器状态切到各卡上的原因(Infra 地图 07 系列第二篇)。
2. 省状态的方法
| 方法 | 做法 | 每参数状态 |
|---|---|---|
| 8-bit Adam(Dettmers 等 2021) | \(m\)、\(v\) 用分块量化的 int8 存 | 2 字节 |
| Adafactor(Shazeer & Stern 2018) | \(v\) 只存行均值与列均值,用外积近似 | \(\approx 0\)(\(O(m + n)\) 而非 \(O(mn)\)) |
| Lion(Chen 等 2023) | 只用符号更新 \(\text{sign}(m)\),不存 \(v\) | 4 字节 |
| 主权重用 bf16 + 随机舍入 / Kahan 求和 | 省掉 fp32 主权重 | 省 4 字节 |
3. 二阶与新优化器
Adam 对每个参数用一个标量 \(1/\sqrt{v}\) 做预处理,是”对角”的曲率信息。Shampoo、SOAP、Muon 一类用矩阵级的预处理(对权重矩阵的行空间与列空间分别归一,或直接把更新正交化),每步更贵但步数更少;Muon 在 2024–2025 年的一些开源预训练里显示出比 AdamW 更高的算力效率。SOPHIA 用 Hessian 对角的估计代替 \(v\)。这些是当前活跃的方向,知道它们都在回答同一个问题——用多少曲率信息换多少步数——就够了;AdamW 仍是默认。
九、案例:同一个 MNIST MLP,五个部件各试一遍
问题:前八章拆开了 LLM 配置里的每个数字,这一章把它们放回同一个网络上测——第一篇的两层 MLP(浅、好训,用来比优化器)和第二篇的 64 层 Pre-Norm 网络(深、敏感,用来看 warmup 和裁剪)。每组实验只改一个部件,问两个问题:它改变了什么、代价是什么。
思路:优化器之间不能只比一个学习率——SGD 和 Adam 的合理学习率差 300 倍,固定一个学习率比就是在比谁碰巧被照顾到。所以每个优化器扫五个学习率取最好,再看曲线的形状(对学习率敏不敏感)而不只是最高点。
1. 代码
在系列的 NumPy 基座上加两个优化器类(约 40 行):
class Adam:
    def step(self):
        self.t += 1
        c1 = 1 - self.b1 ** self.t; c2 = 1 - self.b2 ** self.t        # 偏差修正
        for (P, g), m, v in zip(self.params, self.m, self.v):
            if self.wd and not self.decoupled: g = g + self.wd * P     # L2:混进梯度
            m *= self.b1; m += (1 - self.b1) * g
            v *= self.b2; v += (1 - self.b2) * g * g
            if self.wd and self.decoupled: P -= self.lr * self.wd * P  # AdamW:直接衰减
            P -= self.lr * (m / c1) / (np.sqrt(v / c2) + self.eps)
decoupled 一个开关切换 AdamW 与 Adam + \(L_2\),bias_correction 一个开关切换偏差修正。训练循环加了三样:学习率调度函数、全局范数裁剪、在指定步注入异常 batch。
2. 结果
优化器对比(两层 MLP,1 个 epoch,每个优化器在三个学习率里取最好):
| 优化器 | 最优 \(\eta\) | 准确率 | 最后 50 步平均 loss | 状态大小 |
|---|---|---|---|---|
| SGD | 0.3 | 93.80% | 0.158 | 0 |
| Momentum 0.9 | 0.03 | 93.94% | 0.143 | 795 KiB |
| Adam | 0.001 | 94.80% | 0.129 | 1590 KiB |
| AdamW(\(\lambda = 0.1\)) | 0.001 | 94.80% | 0.130 | 1590 KiB |
把学习率扫描的整条曲线画出来(case_03_optimizers_mnist.py,网格再宽一档):
| 优化器 | 扫的学习率 | 最优 \(\eta\) | 最好准确率 | 状态大小 |
|---|---|---|---|---|
| SGD | 0.03 / 0.1 / 0.3 / 1.0 / 3.0 | 1.0 | 96.3% | 0 |
| Momentum 0.9 | 0.003 / 0.01 / 0.03 / 0.1 / 0.3 | 0.1 | 96.2% | 795 KiB |
| Adam | 3e-4 / 1e-3 / 3e-3 / 1e-2 / 3e-2 | 0.003 | 96.6% | 1590 KiB |
| AdamW(\(\lambda = 0.1\)) | 同上 | 0.003 | 96.5% | 1590 KiB |
读法:(一)调好学习率后四种优化器差不到半个点——两层 MLP 上谁都能训,”Adam 更准”在这里不成立;(二)最优学习率差 300 倍(SGD 1.0 vs Adam 0.003)——这就是第四章说的 Adam 把每个参数的更新量归一到 \(\approx \eta\),而 SGD 的更新量是 \(\eta \times\) 梯度、这个网络的梯度很小;(三)Adam 的最优学习率在几乎所有模型上都是 \(10^{-3}\) 量级、SGD 的每个模型都要重找——Adam 的优势不在成绩,在于不用重新找学习率;(四)代价是右边那一列:Momentum 多存一份参数、Adam 多存两份,每参数 8 字节,这是第八章 Llama-3-8B 优化器状态 64 GB 的来源。
Adam 第一步的更新量(\(\max \lvert \Delta\theta \rvert / \eta\)):有偏差修正 1.00(\(\beta_2\) 无关);无偏差修正 \(\beta_2 = 0.999\) 时 3.16、\(\beta_2 = 0.95\) 时 0.45——与第四章的 \((1 - \beta_1) / \sqrt{1 - \beta_2}\) 一致。
Warmup 在 64 层 Pre-Norm 网络上的曲线(第六章那张表的图形版):
峰值 \(\eta = 10^{-2}\) 不加 warmup,前 20 步 loss 冲到 4.59——比随机初始化的 \(\ln 10 = 2.30\) 还差一倍,网络被第一步的满步长更新打坏、再花 60 步爬回来;加 100 步线性 warmup 最高 1.26。\(\eta = 10^{-3}\) 时两条虚线几乎重合——小学习率下 warmup 看不出差别。学习率越大伤得越重,而 LLM 训练总想用尽量大的学习率,所以 warmup 几乎不能省。
AdamW vs \(L_2\)、线性 scaling、裁剪三组结果已分别列在第五、二、七章。线性 scaling 一组的完整数字:
| \(B\) | \(\eta = 0.05 B / 32\) | 步数 | 最终 loss | 准确率 |
|---|---|---|---|---|
| 32 | 0.05 | 7500 | 0.049 | 96.12% |
| 128 | 0.20 | 1875 | 0.048 | 96.06% |
| 512 | 0.80 | 468 | 0.054 | 96.04% |
| 2048 | 3.20 | 117 | NaN @ 32 | — |
| 8192 | 12.8 | 29 | NaN @ 15 | — |
全部六组在笔记本 CPU 上约两分钟。
3. 值得自己动手的扩展
- 把 \(\beta_2\) 换成 0.999 重跑裁剪实验,看 Adam 从异常 batch 恢复要多少步;
- 在线性 scaling 实验里把 SGD 换成 Adam、学习率按 \(\sqrt{B}\) 缩放,看规则是否成立;
- 实现 WSD 调度与 cosine 对比,观察衰减开始处 loss 的下折。
落地还差什么:这里的实验都在几百到几千步、一个 MNIST 上;LLM 一次训练几十万步,优化器的差别在后半程才显出来——AdamW 与 Adam+\(L_2\) 一个 epoch 差 9 个点(第五章),几十万步会差得更多;warmup 从 100 步变成 2000 步、cosine 的衰减段是 loss 大幅下降的阶段(第六章)。但每个部件”改变了什么、代价是什么”的答案不随规模变,这一章测出来的方向在 8B 模型上仍然成立——这正是能在笔记本上学 LLM 训练配置的原因。
十、本文小结
- SGD 的 batch 梯度无偏、方差 \(\propto 1/B\);由此得线性 scaling 规则(\(B\) 乘 \(k\)、\(\eta\) 乘 \(k\)),在临界 batch 之内成立(实测到 512),之外发散(2048)。Adam 下近似为 \(\sqrt{B}\)。
- Momentum 是梯度的指数移动平均,有效学习率放大 \(1/(1-\beta)\)(实测 SGD 最优 0.3 对应 Momentum 0.03);4 字节 / 参数。
- Adam 用 \(\hat m / \sqrt{\hat v}\) 让每个参数的步长 \(\approx \eta\)、与梯度大小无关;偏差修正后第一步是 \(\eta \cdot \text{sign}(g)\)——满步长——这是大学习率下 warmup 几乎不能省的根本原因(第六章的表:小学习率时差别看不出);\(\beta_2 = 0.95\) 让 \(v\) 20 步内跟上尺度变化;8 字节 / 参数,Llama-3-8B 64 GB。
- AdamW ≠ Adam + \(L_2\):\(L_2\) 被 \(1/\sqrt{v}\) 缩放,梯度小的参数被过度衰减(实测 \(\|W_1\|\) 从 22.6 掉到 2.3,准确率 95.6% → 86.2%);AdamW 的衰减均匀。LLM 里 weight decay 0.1 的作用是设定参数范数的平衡点、控制有效学习率。
- 调度:warmup 让 \(v\) 先学到尺度(\(\eta = 10^{-2}\) 无 warmup 时 loss 冲到 4.59,有则 1.26);cosine 衰减到 10%;WSD 更灵活;衰减阶段是 loss 大幅下降的阶段;峰值 \(\eta\) 随宽度减小,\(\mu\)P 把它做成规则。
- 裁剪到全局范数 1.0 限制步长上界,SGD 下一个坏 batch 不裁剪 loss 跳 6 倍,裁剪后无感;Adam 下损伤小但可见;梯度范数曲线是第二重要的诊断曲线。
- 混合精度 + AdamW 的 16 字节 / 参数里 12 字节是优化器的;8-bit Adam、Adafactor 各省多少;Muon 一类用更多曲率信息换步数。
- 下一篇:有了能稳定训练的网络与优化器,为什么参数比样本多得多却不过拟合——以及什么时候会。
配套代码:deep-learning-foundations/03_optimizers.py——六个实验各是一个子命令(compare / bias / warmup / adamw / scaling / clip);case_03_optimizers_mnist.py 画学习率扫描、warmup 与调度曲线;优化器实现在 dlf/optim.py。
十一、自测
-
Adam 的 \(\beta_1 = 0.9\)、\(\beta_2 = 0.999\),第一步 \(t = 1\) 时 \(\hat m_1\) 与 \(\hat v_1\) 各是多少?更新量是多少?
答案
\(m_1 = 0.1 g\),\(\hat m_1 = m_1 / (1 - 0.9) = g\);\(v_1 = 0.001 g^2\),\(\hat v_1 = g^2\);更新量 \(\eta \cdot g / \lvert g \rvert = \eta \cdot \text{sign}(g)\)——满步长,这就是要 warmup 的原因。
-
Llama-3-8B 用 AdamW 训练,优化器状态占多少显存?换成 SGD + Momentum 呢?8-bit Adam 呢?
答案
AdamW 两个矩各 4 字节:\(8.03 \times 10^9 \times 8 = 64\) GB;SGD + Momentum 一个矩 4 字节:32 GB;8-bit Adam 两个矩各 1 字节:16 GB。
-
SGD 下 batch 从 256 加到 1024,学习率该怎么变?Adam 下呢?什么时候这条规则失效?
答案
SGD 线性 scaling:乘 4;Adam 近似平方根:乘 2。超过临界 batch(梯度噪声已经不是瓶颈)后失效,再加 batch 每步的进步不再随之增加,实测 2048 时发散。
-
同一个 \(\lambda\),Adam + \(L_2\) 与 AdamW 对一个梯度一直很小的参数(比如 embedding 里罕见 token 的行)各做了什么?
答案
Adam + \(L_2\):\(\lambda\theta\) 混进 \(g\),被 \(1/\sqrt{v}\) 放大(\(v\) 小),这个参数被过度衰减、往零缩得很快;AdamW:衰减 \(\eta\lambda\theta\) 独立于矩,与其他参数一样均匀地缩。
-
cosine 与 WSD 两种调度各有什么优缺点?loss 曲线在衰减开始处突然下折是正常的吗?
答案
cosine 平滑、但必须预先知道总步数 \(T\),中途延长要重排;WSD 恒定段可随时延长、从任意点分叉出一个衰减段就能得到可用模型。下折正常:恒定学习率下 loss 在噪声决定的水平上震荡,学习率一降噪声变小,loss 立刻掉——衰减阶段才是 loss 大幅下降的阶段。
-
\(m\) 是梯度的指数移动平均(Momentum,平滑方向),\(v\) 是梯度平方的指数移动平均(每个参数的尺度);更新量 \(\hat m / \sqrt{\hat v}\) 是量级约 1 的无量纲数,所以每个参数每步走约 \(\eta\)、与梯度大小无关——一个学习率适用于尺度相差几个量级的所有参数。详见第三章、第四章。 ↩
-
\(L_2\) 的 \(\lambda\theta\) 混进 \(g\) 后被 \(1/\sqrt{v}\) 缩放,梯度小的参数被过度衰减(实测 \(\lVert W_1 \rVert\) 从 22.6 掉到 2.3,准确率 95.6% → 86.2%);AdamW 把衰减放在矩之外,均匀作用于所有参数。SGD 下两者等价,Adam 下不等价。详见第五章。 ↩
-
偏差修正后 Adam 第一步的更新恰好是 \(\eta \cdot \text{sign}(g)\)——满步长——此时 \(v\) 还没学到真实尺度,所有参数同时以最大步长乱跳;\(\eta = 10^{-2}\) 无 warmup 时 loss 冲到 4.59、有则 1.26。详见第六章。 ↩
-
SGD 下梯度噪声方差 \(\propto 1/B\),\(B\) 乘 \(k\) 则 \(\eta\) 乘 \(k\)(线性 scaling),Adam 下近似 \(\sqrt{k}\);在临界 batch 之内成立(实测到 512),之外发散(2048)——超过临界 batch 再加 batch 只是浪费样本。详见第二章、第六章。 ↩
系列 《深度学习基础:从反向传播到残差》 第 3 / 7 篇
系列总览 — 为什么这样组织、读它需要什么、读完能做什么 · 幻灯片 — 整个系列的精华,一份可分享的 deck
- 反向传播——手推一个两层网络
- 训练为什么不稳定——初始化、归一化与残差
- 优化器——从 SGD 到 AdamW 与学习率调度
- 正则化与泛化——为什么参数比样本多却不过拟合
- CNN——从 LeNet 到 ResNet,再到 ViT
- RNN——从 LSTM 到 attention 的诞生
- 系列总结与通关自测
本文由 arganzheng 创作,采用 CC BY 4.0 许可协议。在保留原文作者、署名以及完整原文链接(https://arganzheng.life/optimizers-from-sgd-to-adamw.html)的前提下,欢迎各种形式的转载、翻译或商业引用。
COMMENTS
评论存放在 GitHub Discussions, 用 GitHub 账号登录即可发表,支持 Markdown。 想针对正文某句话说?选中那段文字,点浮出的「评论」即可划线评论;觉得哪里写错了,发表时勾上「同时提交 Issue」。 有人回复你时 GitHub 会按你的通知设置发邮件,不用守在这里。