系列 《深度学习基础:从反向传播到残差》 第 2 / 7 篇
上一篇的两层网络怎么训都能训。把它加深到 64 层,同样的代码会出现四种结局:loss 停在 \(\ln 10\) 一步不动;第三步变成 NaN;能动但慢得像没训;正常收敛。四种结局对应的网络只差三样东西——权重初始化的标准差、有没有归一化层、有没有残差连接——而这三样东西恰好是 1990 年代到 2016 年深度学习解决”深了就训不动”这个问题的三步。
本篇把这三步各自推到公式、算到数字、在同一个 64 层网络上测出来。推导的主线只有一条:信号的方差在层间怎么传播,梯度作为一串 Jacobian 的乘积怎么放大或缩小。三种修法各自动了这条链上的哪一环,决定了它们能修什么、修不了什么。最后落到当前 LLM 的标准配置——Pre-Norm、RMSNorm、残差、初始化标准差 0.02、残差分支缩放——每一项在本篇都有它的来历与数字。全篇的核心问题是:
一、总览:一条链与三处修补
1. 深网络的一条链
\(L\) 层网络的前向是 \(L\) 个函数的复合,反向是 \(L\) 个 Jacobian 的乘积。两件事都是”连乘”,连乘对每个因子的偏离极端敏感:每层把方差乘 0.5,64 层后是 \(0.5^{64} \approx 5 \times 10^{-20}\);每层的 Jacobian 谱范数是 0.9,128 层后梯度至多是 \(0.9^{128} \approx 1.4 \times 10^{-6}\);是 1.1 则是 \(2 \times 10^{5}\)。深度学习的稳定性问题几乎全部是这个连乘的问题。三种修法:
| 修法 | 动了哪一环 | 修好了什么 | 修不了什么 |
|---|---|---|---|
| 初始化(Xavier / Kaiming) | 让每个因子在初始时刻的期望为 1 | 初始时刻前向方差、反向方差不爆不消 | 训练开始后因子偏离 1;因子的随机波动累积 |
| 归一化(BN / LN / RMSNorm) | 每层前向后强制把方差拉回 1 | 前向方差在整个训练过程中受控;对权重尺度不敏感 | 反向仍是连乘;64 层无残差的网络加了 LN 仍几乎训不动 |
| 残差连接 | 把每层的 Jacobian 从 \(J\) 变成 \(I + J\) | 梯度有一条恒等通路,不再随深度指数衰减 | 残差流方差随深度增长——需要归一化或缩放配合 |
三处修补各动在这条链的哪一环,画出来更清楚——初始化只管 \(t = 0\) 时每个因子的大小,归一化在每层前向之后把方差拉回 1,残差把反向的每个因子从 \(J\) 换成 \(I + J\):
%%{init: {"flowchart": {"wrappingWidth": 220}}}%%
%% 图:深网络的一条链:前向是方差的连乘,反向是 Jacobian 的连乘,初始化、归一化、残差各修一环
flowchart LR
    subgraph FWD["前向:方差的连乘  Var(h_L) = Var(x) · ∏ 因子"]
        direction LR
        X["x"] --> W1["W₁ ·"] --> N1["Norm"] --> W2["W₂ ·"] --> N2["Norm"] --> DOTS["…"] --> HL["h_L"]
    end
    subgraph BWD["反向:Jacobian 的连乘  ∂L/∂x = ∏ (I + J_l)"]
        direction RL
        GL["∂L/∂h_L"] --> J2["(I + J₂)"] --> J1["(I + J₁)"] --> GX["∂L/∂x"]
    end
    INIT["`**初始化**
让 W_l 的因子在 t=0 时期望为 1`"] -.-> W1
    INIT -.-> W2
    NORM["`**归一化**
每层之后把方差拉回 1`"] -.-> N1
    NORM -.-> N2
    RES["`**残差**
每个因子多一项 I`"] -.-> J1
    RES -.-> J2

    classDef fix fill:#fff7e0,stroke:#c98a00,stroke-width:2px,color:#222
    class INIT,NORM,RES fix
三者是叠加的:当前的 LLM 三样都用,缺任何一样都会在某个深度上出问题。第九章的实验把七种组合放在同一个 64 层网络上,结果与这张表一一对应。
2. 本文的章节安排
| 章 | 主题 | 内容 |
|---|---|---|
| 二 | 方差的前向传播 |
|
| 三 | 梯度作为 Jacobian 的乘积 |
|
| 四 | 归一化 |
|
| 五 | 残差连接 |
|
| 六 | Pre-Norm 与 Post-Norm |
|
| 七 | 大模型上的稳定性工具 | loss spike、QK-norm、z-loss、μP、embedding 缩放 |
| 八 | 诊断 | 看哪三条曲线、每种病的形状 |
| 九 | 案例:把 MLP 加深到 64 层 | 7 种接法在同一份数据、同一个骨架上:逐层激活方差与梯度范数的曲线、300 步训练曲线——只有 Pre-Norm 一条线冲到底 |
| 十 | 本文小结 | |
| 十一 | 自测 | 5 道题 |
3. 来龙去脉:每一样都是为了”再深一点”
| 年 | 谁 | 当时的问题 | 留下的东西 |
|---|---|---|---|
| 1998 | LeCun 等,《Efficient BackProp》 | 网络训不动,多半是输入没归一、权重初始化随手取 | 输入标准化、权重按 \(1/\sqrt{n}\) 初始化——第一份”怎么让网络能训”的工程手册 |
| 2010 | Glorot & Bengio(Xavier 初始化) | 5 层以上的 sigmoid / tanh 网络就训不动了,为什么 | 逐层分析方差怎么传(第二章):前向方差和反向方差都要保持不变,解出 \(\sigma^2 = 2/(n_{in} + n_{out})\) |
| 2015 | He 等(Kaiming 初始化) | ReLU 网络用 Xavier 到 30 层就不行 | ReLU 砍掉一半方差,所以 \(\sigma^2 = 2/n\)(第二章第 2 节);第一次把 30 层的 ReLU 网络训起来 |
| 2015 | Ioffe & Szegedy,BatchNorm | 初始化只管第一步,训着训着分布又变了 | 归一化层(第四章):每层强制拉回均值 0 方差 1,学习率可以大 10 倍;代价是依赖 batch |
| 2015 | He 等,ResNet | 有了 BN,56 层还是比 20 层差——不是过拟合,是训练误差更高 | 残差连接(第五章):\(x + f(x)\),梯度多一条恒等通路,152 层能训;之后深度不再是瓶颈 |
| 2016 | Ba、Kiros、Hinton,LayerNorm | RNN / 序列模型 batch 内长度不一,BN 用不了 | 按样本、沿特征归一化(第四章第 2 节)——Transformer 用的就是它 |
| 2019 / 2020 | Zhang & Sennrich,RMSNorm;Xiong 等,Pre-LN | LayerNorm 里减均值是不是必要的;原始 Transformer 的 Post-Norm 为什么必须 warmup | 去掉减均值省 7% 时间效果不变(第四章第 3 节);证明 Post-Norm 靠近输出的层梯度大、Pre-Norm 各层梯度均匀(第六章)——LLM 全部改用 Pre-Norm + RMSNorm |
一条线看下来,三样东西解决的是同一个问题的三个阶段:”再深一点”就训不动。初始化管第一步(信号进出网络不爆不灭),归一化管训练中(分布跑偏了拉回来),残差管梯度的路(不管多深都有一条恒等通路)。每一次深度的跃升(5 层 → 30 层 → 150 层 → Transformer 的 100 层)都对应表里的一行,而今天 LLM 的配置——Kaiming 量级的初始化、Pre-Norm、RMSNorm、残差——是这张表全部叠起来的结果。第九章用一个 64 层的 MLP 把这几行各拆开试一遍。
二、方差的前向传播
1. 一层线性变换对方差做了什么
\(y = Wx\),\(W \in \mathbb{R}^{n_{out} \times n_{in}}\),元素独立同分布、均值 0、方差 \(\sigma_w^2\);\(x\) 的分量独立、均值 0、方差 \(\sigma_x^2\)。\(y\) 的每个分量是 \(n_{in}\) 个独立项之和:\(y_i = \sum_j W_{ij} x_j\),方差相加(L0 数学系列第四篇的高斯性质):
\[\text{Var}(y_i) = n_{in}\, \sigma_w^2\, \sigma_x^2\]要让方差不变,\(\sigma_w^2 = 1 / n_{in}\)。这是 Xavier / Glorot 初始化(Glorot & Bengio 2010)的前向版本;同一篇论文考虑反向后取了折中 \(2 / (n_{in} + n_{out})\)。
2. ReLU 砍掉一半
ReLU 把负半轴置零。对均值 0 对称分布的输入,输出的二阶矩是输入的一半:\(\mathbb{E}[\text{ReLU}(y)^2] = \frac{1}{2}\mathbb{E}[y^2]\)(严格说砍半的是二阶矩不是方差——ReLU 输出均值不为零,标准正态过 ReLU 后方差是 \(\tfrac12 - \tfrac{1}{2\pi} \approx 0.34\);Kaiming 的推导用的正是二阶矩,因为下一层 \(\sum w_i x_i\) 的方差里出现的是 \(\mathbb{E}[x_i^2]\))。于是”Linear + ReLU”一层让下一层前激活的方差乘 \(\frac{1}{2} n_{in} \sigma_w^2\),不变的条件是
\[\sigma_w^2 = \frac{2}{n_{in}}\]这是 Kaiming 初始化(He 等 2015)。差一个因子 2 看起来无关紧要,连乘之后不是:用 \(1/n_{in}\) 初始化一个 ReLU 网络,每层方差乘 0.5、标准差乘 \(0.707\),64 层后标准差是 \(2^{-32} \approx 2.3 \times 10^{-10}\)。第九章实测 \(7.2 \times 10^{-10}\)(初始层略有差异),loss 停在 \(\ln 10 = 2.303\) 一步不动——logits 全是零,梯度全是零。
其他激活函数各有自己的因子:tanh 在原点附近近似恒等,用 \(1/n_{in}\);GELU、SiLU 介于两者之间,PyTorch 的 kaiming_normal_ 的 nonlinearity 参数就是在选这个因子。
3. 数字:宽度决定标准差
Kaiming 的 \(\sigma_w = \sqrt{2 / n_{in}}\) 代几个宽度:
| \(n_{in}\) | \(\sqrt{1/n_{in}}\) | \(\sqrt{2/n_{in}}\) |
|---|---|---|
| 256(本文实验) | 0.0625 | 0.088 |
| 768(GPT-2 small) | 0.036 | 0.051 |
| 4096(Llama-3-8B) | 0.0156 | 0.022 |
| 8192(Llama-3-70B) | 0.011 | 0.0156 |
GPT-2 与之后几乎所有 LLM 的 initializer_range 都是一个固定的 0.02,不随宽度变。对 \(d = 4096\) 它恰好接近 Kaiming 值;对 \(d = 768\) 偏小、对 \(d = 8192\) 偏大。这个常数能用是因为 Transformer 每个子层前面都有归一化(第四章)——归一化让前向对初始化的尺度不敏感。但它不是没有代价:不同宽度下最优学习率会漂移,这是 \(\mu\)P(第七章)要解决的问题。
三、梯度作为 Jacobian 的乘积
1. 反向的方差传播
反向传播里 \(\partial L / \partial x = W^T (\partial L / \partial y)\)(上一篇第三章),同样的推导给出 \(\text{Var}(\partial L / \partial x_j) = n_{out}\, \sigma_w^2\, \text{Var}(\partial L / \partial y_i)\),不变的条件是 \(\sigma_w^2 = 1/n_{out}\)(ReLU 网络是 \(2 / n_{out}\))。前向要 \(1/n_{in}\)、反向要 \(1/n_{out}\),两者只在 \(n_{in} = n_{out}\) 时同时满足——这是 Xavier 取调和平均的原因,也是 He 等 2015 论证”只满足一个方向就够”的地方:只要每层的比例 \(n_{out}/n_{in}\) 不系统性地偏向一边,另一个方向的偏差是常数因子而不是指数因子。
2. 谱范数与连乘
更一般地,第 \(l\) 层输入的梯度是
\[\frac{\partial L}{\partial x_l} = J_l^T J_{l+1}^T \cdots J_{L}^T \frac{\partial L}{\partial x_{L+1}}\]它的范数上界是各 Jacobian 谱范数(最大奇异值)的乘积。初始化把每个 \(J\) 的”平均放大率”调到 1,但两件事初始化管不了:训练开始后 \(W\) 会变,放大率随之偏离 1;随机矩阵的乘积即使每个的期望放大率是 1,乘积的分布也会越来越宽——这是随机矩阵理论里的结果,实践中表现为深层网络即使初始化正确、梯度范数也在层间有很大的随机波动。
第九章的实验里,Kaiming 初始化的 64 层 plain 网络前向方差控制得很好(各层标准差在 2–3 之间),但梯度范数在层间从 1.7 波动到 13,学习率 0.05 时三步就 NaN、学习率 0.005 时 300 步只到 29%。初始化只能修初始时刻,深了之后需要在训练全程持续起作用的机制。
四、归一化
1. 三种归一化的公式
归一化层把输入沿某个维度减均值、除标准差,再乘一个可学习的增益 \(\gamma\)、加偏置 \(\beta\):
| 沿哪个维度统计 | 公式 | 参数 | 出处 | |
|---|---|---|---|---|
| BatchNorm | 同一特征在 batch 内的 \(m\) 个样本 | \(\hat x_{ij} = (x_{ij} - \mu_j) / \sqrt{\sigma_j^2 + \epsilon}\),\(\mu_j, \sigma_j\) 沿 \(i\) 统计 | \(2d\) | Ioffe & Szegedy 2015 |
| LayerNorm | 同一样本的 \(d\) 个特征 | 同上,\(\mu_i, \sigma_i\) 沿 \(j\) 统计 | \(2d\) | Ba 等 2016 |
| RMSNorm | 同一样本的 \(d\) 个特征,不减均值 | \(\hat x_{ij} = x_{ij} / \sqrt{\frac{1}{d}\sum_j x_{ij}^2 + \epsilon}\) | \(d\) | Zhang & Sennrich 2019 |
三者都让输出的每个样本(或每个特征)尺度固定为 \(\gamma\),前向方差从此不依赖前面所有层的权重尺度——第二章那条连乘链在每个归一化层被切断一次。
2. BatchNorm 为什么不适合序列模型
BatchNorm 的统计量来自 batch,带来三个问题:统计量随 batch 大小与组成变化,batch 小时噪声大;序列模型里同一位置的样本可能是 padding,不同长度的序列让”同一特征”的含义不清;推理时没有 batch,要用训练时的滑动平均,训练与推理行为不一致。LayerNorm 沿特征统计,每个 token 自己归一,三个问题都不存在。这就是 CNN 用 BatchNorm、Transformer 用 LayerNorm 的原因。
3. RMSNorm 省了什么
RMSNorm 去掉了减均值这一步和 \(\beta\)。计算上少一次 reduction(均值)和一次减法,参数少一半;Zhang & Sennrich 的实验与后来 Llama 系列的实践表明质量不受影响——归一化的作用主要来自”固定尺度”,不来自”中心化”。当前 LLM(Llama、Qwen、DeepSeek、Gemma)几乎全用 RMSNorm。它的反向也更简单:记 \(\hat x = x / r\),\(r = \sqrt{\text{mean}(x^2) + \epsilon}\),则 \(\partial L / \partial x = \frac{1}{r}\left[ g - \hat x \cdot \text{mean}(g \odot \hat x) \right]\),其中 \(g = \gamma \odot \partial L / \partial \hat x\)。第九章的代码实现了 LayerNorm 与 RMSNorm 两个类的前向反向。
4. 归一化的另一个作用:尺度不变性
归一化之后的输出对输入的整体尺度不敏感:\(\text{Norm}(cx) = \text{Norm}(x)\)。于是归一化层之前那个权重矩阵的尺度不影响前向——\(W\) 乘 2,输出不变。这带来一个重要的副作用:该权重的梯度与它的范数成反比(尺度大了,同样的扰动产生的相对变化小),等价于一个随权重范数自动调节的有效学习率。这是 weight decay 在有归一化的网络里仍然有用的原因之一(下一篇第五章),也是初始化常数可以不随宽度变的原因(第二章第 3 节)。
5. 归一化修不了反向的连乘
第九章的 “ln” 配置——64 层、Kaiming、每层一个 LayerNorm、没有残差——前向各层标准差严格为 1.0,但梯度范数从底层的 0.26 到顶层的 1.48,且训练 300 步后 loss 仍在 1.56(准确率 37%)。归一化把前向管住了,反向仍然是 64 个 Jacobian 的乘积。深网络的最后一块拼图是残差。
五、残差连接
1. I + J:一条恒等通路
残差块把 \(x_{l+1} = f_l(x_l)\) 改成
\[x_{l+1} = x_l + f_l(x_l), \qquad \frac{\partial x_{l+1}}{\partial x_l} = I + J_{f_l}\]\(L\) 层的乘积 \(\prod_l (I + J_{f_l})\) 展开后有一项是 \(I\)——梯度从 loss 到任何一层都有一条不经过任何 Jacobian 的直达通路。只要 \(J_{f_l}\) 的范数不太大,这条通路就保证梯度不会指数级衰减。He 等 2015(ResNet)用它把 152 层训了起来;Transformer 每层有两个残差块(attention 与 FFN),Llama-3-70B 的 80 层就是 160 个残差块。第九章实测:有残差的配置(Pre-Norm)各层梯度范数在 0.12–0.15 之间,均匀得像同一层。
2. 残差流的方差:翻倍还是线性增长
残差修好了反向,却给前向带来新问题:每个块往残差流上加东西,方差只增不减。增长的速度取决于 \(f_l\) 的输出方差与 \(x_l\) 的关系:
没有归一化时,方差每层翻倍。 若 \(f_l(x) = W_2\, \text{ReLU}(W_1 x)\) 且初始化让 \(\text{Var}(f_l(x)) \approx \text{Var}(x)\),则 \(\text{Var}(x_{l+1}) = \text{Var}(x_l) + \text{Var}(f_l(x_l)) \approx 2\,\text{Var}(x_l)\)。因为 \(f_l\) 对输入尺度是齐次的——\(x\) 大一倍,\(f_l(x)\) 也大一倍。64 层后方差是 \(2^{64}\),标准差 \(2^{32} \approx 4 \times 10^9\)。第九章的 “res-nonorm” 配置实测第 64 块标准差 \(6.0 \times 10^9\),第一步就 NaN。
有 Pre-Norm 时,方差线性增长。 \(f_l(x) = W_2\, \text{ReLU}(W_1\, \text{Norm}(x))\),归一化让 \(f_l\) 的输出方差与 \(x\) 的尺度无关,是一个常数 \(\sigma_f^2\)。于是 \(\text{Var}(x_L) = \text{Var}(x_0) + L \sigma_f^2\)——线性,不是指数。实测 Pre-Norm 配置第 1 块标准差 1.29、第 64 块 1.46,方差从 1.66 到 2.13,几乎可以忽略。
3. GPT-2 的残差分支缩放 1/√(2L)
即使线性增长也可以进一步压平。GPT-2 把每个残差分支最后那个投影矩阵(attention 的 \(W_O\)、FFN 的 down projection)的初始化标准差再乘 \(1 / \sqrt{N}\),\(N = 2L\) 是残差块的总数。推导:\(2L\) 个块各加方差 \(\sigma_f^2\),总和 \(2L\sigma_f^2\);每块缩放 \(1/\sqrt{2L}\) 后方差变成 \(\sigma_f^2 / (2L)\),总和回到 \(\sigma_f^2\)——残差流在最后一层的方差与深度无关。GPT-2 small(\(L = 12\))这个因子是 \(1/\sqrt{24} = 0.20\);Llama-3-70B(\(L = 80\))是 \(1/\sqrt{160} = 0.079\)。
第九章有一个值得注意的结果:”res-nonorm-scaled”(残差 + 这个缩放,但没有归一化)的初始统计量完全正常——各层标准差 1.3 到 1.6,梯度范数均匀在 0.23 左右——但学习率 0.05 与 0.005 下都发散,要降到 0.001 才能训。缩放修好了初始时刻,训练一开始 \(f_l\) 的齐次性又让方差失控。残差与归一化必须同时用:归一化让残差流的增长从指数变成线性,缩放再把线性压平。
六、Pre-Norm 与 Post-Norm
1. 两种放法
归一化放在残差分支之前还是残差相加之后,是两种结构。下图是 Xiong 等 2020 论文里的原图——(a) Post-LN 是 2017 年原始 Transformer 的接法,(b) Pre-LN 是 GPT-2 之后 LLM 的接法;灰色粗箭头是残差流,注意 Layer Norm 在 (a) 里横在残差流上、在 (b) 里只在分支入口:
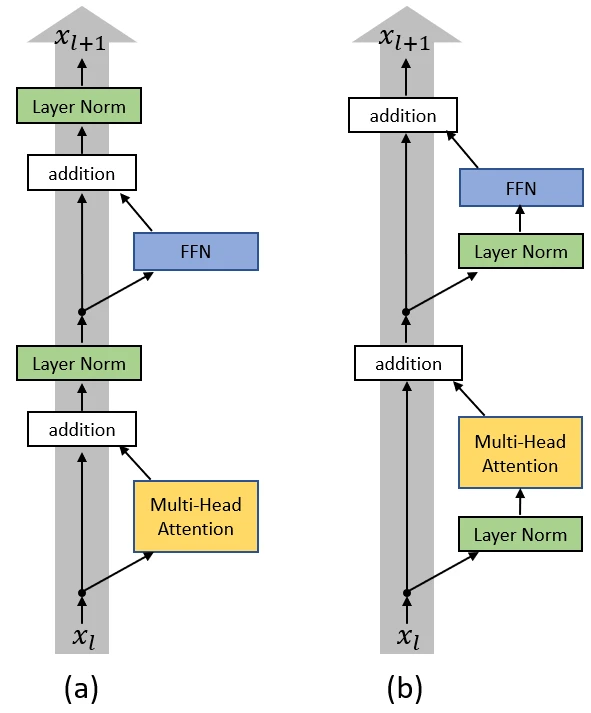
Post-Norm:\(x_{l+1} = \text{Norm}(x_l + f_l(x_l))\)。Pre-Norm:\(x_{l+1} = x_l + f_l(\text{Norm}(x_l))\)。
2. 梯度路径的区别
Pre-Norm 的残差流 \(x_l\) 从头到尾没有被归一化打断,\(\partial x_{l+1} / \partial x_l = I + J\) 的恒等项完好,梯度到每一层的量级相同。Post-Norm 的恒等通路每层要穿过一个 Norm,Norm 的 Jacobian 会按输入的尺度缩放梯度——Xiong 等 2020 证明 Post-Norm 里靠近输出的层梯度大、靠近输入的层梯度小,量级差随深度增长;所以 Post-Norm 必须用 warmup 把初期的大梯度压住,深了仍然难训。
第九章的实测:Post-Norm 配置梯度范数从底层 0.51 到顶层 1.96,差 4 倍;Pre-Norm 是 0.12 到 0.15。训练上,学习率 0.05 时 Pre-Norm 300 步到 91.6%,Post-Norm 停在 8.8%(loss 2.33);学习率 0.005 时 Post-Norm 能训到 64%,Pre-Norm 90%。同一个网络、同一份代码,差别只是 Norm 的位置。
3. 为什么 LLM 选 Pre-Norm
Post-Norm 在能训起来的时候效果略好——残差流每层被归一,表示能力用得更满。但 LLM 的深度(几十到上百层)、规模(一次训练几个月、不能失败)与对大学习率的需求,让稳定性压过了那一点效果。GPT-2 之后的 decoder-only 模型几乎全是 Pre-Norm;一些近期模型(Gemma 2 等)在残差分支的输入与输出各放一个 Norm(”sandwich”),DeepNorm 一类工作则给 Post-Norm 加缩放让它也能深。这些都是在同一条梯度路径上做的取舍。
Pre-Norm 有一个已知的副作用:残差流最后的方差随深度线性增长(第五章),所以最后一层之后要再加一个 Norm(final norm)再送 lm_head——04 系列第五篇的结构图里那个 final RMSNorm 就是它。
七、大模型上的稳定性工具
前六章的三样东西是基础配置。规模上去之后还有一批补丁,各自针对一个具体的失稳来源:
| 工具 | 针对的问题 | 做法 | 出处 / 使用者 |
|---|---|---|---|
| Warmup | 训练初期 Adam 的二阶矩估计不准、更新过大;Post-Norm 初期梯度大 | 学习率从 0 线性升到峰值,几百到几千步 | 下一篇 |
| 梯度裁剪 | 偶发的大梯度把参数打飞 | 全局梯度范数超过阈值(常用 1.0)就等比缩小 | 下一篇 |
| QK-norm | attention logits 随训练增长,softmax 饱和,梯度消失或 loss spike | 对 \(Q\)、\(K\) 各做一次 LayerNorm / RMSNorm 再点积 | Dehghani 等 2023(ViT-22B);Gemma、Qwen3 等 |
| z-loss | lm_head 的 logits 整体漂移,softmax 的归一化项 \(\log Z\) 失控 | loss 加 \(10^{-4} \cdot (\log Z)^2\),把 \(\log Z\) 拉向 0 | PaLM |
| Embedding 缩放 | embedding 输出尺度与残差流不匹配 | embedding 乘 \(\sqrt{d}\)(Gemma)或用更大初始化 | 原始 Transformer 即有 |
| \(\mu\)P | 最优学习率随宽度漂移,小模型调出的超参数在大模型上失效 | 按宽度缩放初始化与学习率,使不同宽度下特征更新量级一致 | Yang 等 2022;被多个开源模型采用 |
| 更小的 \(\beta_2\) | Adam 二阶矩对突变反应慢,梯度突增时更新过大 | \(\beta_2\) 从 0.999 降到 0.95 | 下一篇;几乎所有 LLM |
loss spike——训练中 loss 突然跳高、有时能恢复有时不能——是这些工具共同的敌人。它的来源有数据(一个异常 batch)、有数值(bf16 下的溢出)、有结构(attention logits 增长);排查从看哪一层的梯度范数先跳开始,这是下一章的内容。
八、诊断
训练一个深网络,三条曲线值得从第一步就记录:
| 记什么 | 健康的形状 | 病态与对应的病 | ||||
|---|---|---|---|---|---|---|
| 各层激活的 RMS(或标准差) | 各层同量级,训练中缓慢变化 |
|
||||
| 各层梯度的范数 | 各层同量级(有残差 + Pre-Norm 时几乎相等) |
|
||||
| 更新量与参数的比 $$\ | \Delta W\ | / \ | W\ | $$ | 约 \(10^{-3}\) 量级 | 远大于 → 学习率太大;远小于 → 学习率太小或该层没在学 |
第一条对应第二、五章,第二条对应第三、六章,第三条是下一篇优化器的内容。三条曲线加起来,第一章那张表里的每一种失败都能在几百步之内被定位到具体的层与具体的原因。
九、案例:把 MLP 加深到 64 层——七种接法哪些能训
问题:上一篇的两层 MLP 加深到 64 层会怎样?这是 2010–2015 年整个领域面对的问题(来龙去脉那张表的每一行都是它的一次回答)。这一章在同一份数据(MNIST)、同一个骨架(784 → 256 的输入投影 + 64 个 256 宽的块 + 256 → 10 的输出层)上,只改初始化 / 归一化 / 残差的接法,七种配置各训一遍,看哪些能训、哪些不能、为什么。
思路:先不训,只做一次前向反向,看初始时刻每层的激活多大、梯度多大(第二、三章的方差传播说它们应该保持在 1 附近);再 SGD 训 300 步,两个学习率。前者是”体检”,后者是”结果”——体检不过的,结果一定不好;体检过了的,也不一定能训(plain-kaiming 就是例子)。
1. 代码
在上一篇的 NumPy 基座上加四个类:LayerNorm、RMSNorm(前向反向见第四章的公式)、Sequential、Residual(forward 返回 X + f(X),backward 返回 dY + f.backward(dY)——正是 \(I + J\))。七种配置,全部是 784 → 256 的输入投影 + 64 个块 + 256 → 10 的输出层:
| 配置 | 每个块 | 初始化 |
|---|---|---|
| plain-naive | Linear → ReLU | \(\sigma = 1/\sqrt{256}\)(忘了 ReLU 的因子 2) |
| plain-kaiming | Linear → ReLU | \(\sigma = \sqrt{2/256}\) |
| ln | Linear → LayerNorm → ReLU | Kaiming |
| res-nonorm | \(x + W_2\,\text{ReLU}(W_1 x)\) | Kaiming;\(W_2\) 用 \(1/\sqrt{256}\) |
| res-nonorm-scaled | 同上 | \(W_2\) 再乘 \(1/\sqrt{2L} = 1/\sqrt{128}\) |
| prenorm | \(x + W_2\,\text{ReLU}(W_1\,\text{LN}(x))\),末尾一个 final LN | 同上 |
| postnorm | \(\text{LN}(x + W_2\,\text{ReLU}(W_1 x))\) | 同 res-nonorm |
输入按特征标准化到均值 0、方差 1。初始时刻在一个 256 样本的 batch 上做一次前向反向,记录第 1 / 8 / 16 / 32 / 64 块的激活标准差与对应 Linear 的梯度范数;然后 SGD 训 300 步、batch 128,学习率分别取 0.05 与 0.005。
2. 初始时刻:逐层激活标准差与梯度范数
| 配置 | 激活标准差 @ 块 1 / 8 / 16 / 32 / 64 | 梯度范数 @ 同样深度 |
|---|---|---|
| plain-naive | 1.3 · 0.15 · 1.4e-2 · 4.3e-5 · 7.2e-10 | 4e-10 · 6e-10 · 6e-10 · 4e-10 · 7e-10 |
| plain-kaiming | 1.9 · 2.3 · 3.5 · 2.8 · 3.1 | 1.8 · 6.8 · 13.0 · 9.9 · 10.0 |
| ln | 1.9 · 1.0 · 1.0 · 1.0 · 1.0 | 0.26 · 0.30 · 0.45 · 0.62 · 1.48 |
| res-nonorm | 1.9 · 21 · 320 · 7.0e4 · 6.0e9 | 6e9 · 1e10 · 2e10 · 2e10 · 4e10 |
| res-nonorm-scaled | 1.3 · 1.3 · 1.4 · 1.5 · 1.6 | 0.23 · 0.23 · 0.23 · 0.23 · 0.25 |
| prenorm | 1.3 · 1.3 · 1.3 · 1.4 · 1.5 | 0.14 · 0.16 · 0.14 · 0.13 · 0.12 |
| postnorm | 1.9 · 1.0 · 1.0 · 1.0 · 1.0 | 0.51 · 0.57 · 0.78 · 1.02 · 1.96 |
每一行对应正文的一个论断:plain-naive 是第二章的 \(2^{-32}\);plain-kaiming 前向稳但梯度在层间波动一个量级(第三章);ln 前向严格为 1、梯度仍随深度变化 6 倍(第四章第 5 节);res-nonorm 是第五章的”每层翻倍”,\(6 \times 10^9 \approx 2^{32}\);res-nonorm-scaled 与 prenorm 初始统计几乎一样好;postnorm 梯度顶层是底层的 4 倍(第六章)。
画成曲线(case_02_deep_mlp.py):
对数坐标上两条直线——plain-naive 往下、res-nonorm 往上——就是”每层乘一个固定因子”的指数增长 / 衰减,第二章和第五章推的两个公式画出来就是这两条线的斜率。其余五种前向都贴着 1,但右图的梯度告诉你它们不一样:ln 和 postnorm 从底层到顶层升了 4–6 倍,prenorm 和 res-nonorm-scaled 几乎是水平的。
3. 训练 300 步
| 配置 | lr 0.05:loss @ 1 / 100 / 300 | acc | lr 0.005:loss @ 1 / 100 / 300 | acc |
|---|---|---|---|---|
| plain-naive | 2.303 / 2.301 / 2.305 | 11.7% | 2.303 / 2.302 / 2.303 | 11.7% |
| plain-kaiming | NaN @ step 3 | — | 3.540 / 2.170 / 1.893 | 29.3% |
| ln | 2.463 / 2.328 / 2.328 | 9.6% | 2.463 / 2.269 / 1.562 | 37.2% |
| res-nonorm | NaN @ step 1 | — | NaN @ step 1 | — |
| res-nonorm-scaled | NaN @ step 2 | — | NaN @ step 10 | — |
| prenorm | 2.779 / 0.202 / 0.158 | 91.6% | 2.779 / 0.280 / 0.155 | 90.1% |
| postnorm | 2.751 / 2.552 / 2.326 | 8.8% | 2.751 / 1.818 / 0.982 | 64.3% |
res-nonorm-scaled 要把学习率降到 0.001 才能训(300 步 loss 0.22)——比 prenorm 小 50 倍。七行里只有 prenorm 在两个学习率下都正常,这就是它成为 LLM 默认结构的原因。每种配置 300 步在笔记本 CPU 上 3–7 秒。
曲线比表更直白:同一份数据、同一个骨架、同样的 300 步,Pre-Norm 一条线冲到底,其余六种要么发散(×)、要么贴着 \(\ln 10 = 2.30\) 不动、要么慢得像没训。右图 lr 0.005 里 postnorm 那条慢慢往下的蓝线就是 2017 年原始 Transformer 的处境——能训,但要小学习率加 warmup,Xiong 等 2020 解释了为什么,之后所有 LLM 都换成了左边那条绿线。
落地还差什么:这里的”深”是 64 层 MLP,LLM 是 32–128 层 Transformer,每层多了 attention 和 4 倍宽的 FFN,但结论一条不变:Kaiming 量级初始化 + Pre-Norm + 残差是能训的最低配置。规模再上去,第七章那批补丁(QK-norm、z-loss、\(\mu\)P)各针对一个这里还没出现的失稳来源;而”训之前先看逐层激活 std 和梯度范数”这两条曲线,是任何规模下排查训不动的第一步(第八章)。
4. 值得自己动手的扩展
- 把 LayerNorm 换成 RMSNorm,结果应几乎不变;
- 把深度从 64 改到 16 与 256,看 ln 与 postnorm 在浅时能训、深时不能,prenorm 一直能;
- 给 postnorm 加 100 步线性 warmup(下一篇),看它能否追上 prenorm。
十、本文小结
- 深网络的稳定性问题是连乘问题:前向方差每层乘一个因子、反向梯度是 \(L\) 个 Jacobian 的乘积;因子偏离 1 就指数放大(\(0.9^{128} \approx 10^{-6}\))。
- 初始化让每个因子在初始时刻的期望为 1:\(\text{Var}(y) = n_{in}\sigma_w^2\text{Var}(x)\),ReLU 砍一半,所以 Kaiming 是 \(2/n_{in}\);用错成 \(1/n_{in}\),64 层后信号是 \(2^{-32}\)。LLM 的 0.02 是不随宽度变的常数,靠归一化兜底。
- 归一化在每层把前向方差拉回 1,切断前向的连乘,并带来尺度不变性;LayerNorm 沿特征统计所以适合序列;RMSNorm 去掉均值与 \(\beta\)、效果不变;但它修不了反向——64 层无残差加 LN 仍几乎训不动。
- 残差把 Jacobian 变成 \(I + J\),给梯度一条恒等通路,各层梯度范数变得均匀。代价是残差流方差增长:无归一化时每层翻倍(\(2^{64}\)),Pre-Norm 下线性,再乘 \(1/\sqrt{2L}\) 可压平;缩放只修初始时刻,残差与归一化必须同用。
- Pre-Norm 保住恒等通路,梯度各层同量级、能用大学习率;Post-Norm 顶层梯度是底层的 4 倍,需要 warmup、深了难训。LLM 选 Pre-Norm 加 final norm。
- 规模化之后的补丁——warmup、裁剪、QK-norm、z-loss、\(\mu\)P、\(\beta_2 = 0.95\)——各针对一个具体的失稳来源;诊断看三条曲线:各层激活 RMS、各层梯度范数、更新量 / 参数比。
- 下一篇讲有了稳定的梯度之后怎么用它更新参数:优化器、学习率、warmup 与裁剪的来历。
配套代码:deep-learning-foundations/02_init_norm_residual.py——七种接法的初始化统计与 300 步训练,case_02_deep_mlp.py 把它们画成曲线;dlf/layers.py 里是 LayerNorm / RMSNorm / Residual 的实现与 make_deep_mlp。
十一、自测
-
一个 Linear 层 \(y = Wx\),\(W\) 的元素独立、方差 \(\sigma_w^2\),输入 \(n_{in}\) 维、方差 1。输出的方差是多少?后面接 ReLU 呢?由此 Kaiming 初始化的 \(\sigma_w^2\) 该取多少?
答案
\(\text{Var}(y) = n_{in} \sigma_w^2\);ReLU 把二阶矩砍掉一半,下一层前激活的方差变成 \(n_{in}\sigma_w^2 / 2\);要让它等于 1,\(\sigma_w^2 = 2 / n_{in}\)。
-
每层 Jacobian 的谱范数是 0.95,无残差 100 层,loss 到第一层的梯度大约衰减到多少?加了残差呢?
答案
\(0.95^{100} \approx 0.006\),衰减约 170 倍。加残差后每个因子是 \(I + J\),乘积展开里有一项恒等 \(I\),梯度不再指数衰减(量级接近 1)。
-
LayerNorm、RMSNorm、BatchNorm 各沿哪个维度统计?为什么序列模型不用 BatchNorm?
答案
LayerNorm 与 RMSNorm 沿每个 token 自己的特征维(\(d\));BatchNorm 沿 batch 维对每个特征统计。序列模型里 batch 内序列长度不同、padding 位置多、推理时 batch 为 1,batch 统计量不稳定、训练与推理行为不一致。RMSNorm 比 LayerNorm 少了减均值与 \(\beta\),效果不变。
-
Pre-Norm 与 Post-Norm 的公式各是什么?为什么 Pre-Norm 的残差流方差随深度线性增长,而 LLM 仍然选它?
答案
Post-Norm:\(x_{l+1} = \text{Norm}(x_l + f(x_l))\);Pre-Norm:\(x_{l+1} = x_l + f(\text{Norm}(x_l))\)。Pre-Norm 的残差流从头到尾不被归一化打断,每层加一个方差约为常数的分支,所以线性增长;但这条不被打断的恒等通路正是各层梯度同量级、能用大学习率的原因。副作用用最后的 final norm 处理。
-
训练时看到各层梯度范数从底层到顶层差 4 倍、loss 在前 100 步冲高——最可能是哪种结构、缺了什么?
答案
Post-Norm 的特征(顶层梯度大于底层,Xiong 等 2020);缺 warmup——初期大梯度需要小学习率压住。换 Pre-Norm 或加 warmup。
-
64 层的前向方差是 64 个因子的连乘、反向梯度是 64 个 Jacobian 的连乘,因子偏离 1 就指数放大或消失——初始化用错成 \(1/n_{in}\) 时 64 层后信号是 \(2^{-32}\),Jacobian 谱范数 0.9 时 128 层后梯度是 \(10^{-6}\)。详见第二章、第三章。 ↩
-
初始化(Kaiming 的 \(2/n_{in}\))只保证 \(t = 0\) 时每个因子的期望为 1;归一化在每层之后把前向方差拉回 1、切断前向的连乘,但修不了反向——64 层无残差加 LN 仍几乎训不动;残差把 Jacobian 变成 \(I + J\),给梯度一条恒等通路,各层梯度范数变均匀。缺初始化第一步就爆或消;缺归一化残差流方差每层翻倍(\(2^{64}\));缺残差梯度指数衰减——三样必须同用。Pre-Norm 是当前的摆法:顶层与底层梯度 0.12 到 0.15,Post-Norm 是 0.51 到 1.96。详见第四至六章、第九章。 ↩
系列 《深度学习基础:从反向传播到残差》 第 2 / 7 篇
本文由 arganzheng 创作,采用 CC BY 4.0 许可协议。在保留原文作者、署名以及完整原文链接(https://arganzheng.life/initialization-normalization-and-residual.html)的前提下,欢迎各种形式的转载、翻译或商业引用。
COMMENTS
评论存放在 GitHub Discussions, 用 GitHub 账号登录即可发表,支持 Markdown。 想针对正文某句话说?选中那段文字,点浮出的「评论」即可划线评论;觉得哪里写错了,发表时勾上「同时提交 Issue」。 有人回复你时 GitHub 会按你的通知设置发邮件,不用守在这里。