系列 《深度学习基础:从反向传播到残差》 第 7 / 11 篇 入门
系列总览 — 为什么这样组织、读它需要什么、读完能做什么 · 幻灯片 — 整个系列的精华,一份可分享的 deck
学习地图 — AI 算法工程师学习地图 第 4 / 12 个系列
上一篇:优化器——从 SGD 到 AdamW 与学习率调度下一篇:CNN——从 LeNet 到 ResNet,再到 ViT
L2 经典机器学习系列讲过经典机器学习的第一定律:模型容量超过数据量就会过拟合。一个 160 万参数的网络在 4000 个样本上训练,按这条定律应该背下每一个样本、在测试集上一败涂地。第九章的实验里它做到了前半句——训练错误率 0.0%——却没有做到后半句:测试错误率 14.5%,是所有宽度里最好的。而一个参数只有样本两倍的小网络,测试错误率 43%。
这个现象——参数越多泛化越好,越过某个点之后——在 2017 年前后被系统地记录下来(Zhang 等 2017;Belkin 等 2019),它推翻的不是”过拟合”这个概念,而是”容量”这个度量。本篇讲三件事:为什么深网络在参数远多于样本时不过拟合(隐式正则化与 double descent);显式正则化手段各自在做什么(dropout、weight decay、早停、label smoothing);以及什么时候过拟合会回来——因为它一定会回来,SFT 训几个 epoch 之后模型开始逐字背答案,就是它。全篇的核心问题是:
一个参数量是样本量几百倍的网络为什么不过拟合?1 同一个网络在什么数据规模、多少个 epoch 之后会开始过拟合?2 怎么提前看到?3
一、总览:两个区间
1. 参数 / 数据比决定你在哪个区间
泛化问题的第一步是算一个数:参数量除以训练 token(或样本)数。它把深度学习分成两个区间:
| 场景 | 参数 \(N\) | 数据 \(D\) | \(N / D\) | 区间 |
|---|---|---|---|---|
| 本文实验:MNIST 子集,宽 2048 | 1.6M | 4000 样本 | 407 | 极度过参数化——但不过拟合 |
| Llama-3-8B 预训练 | 8.0B | 15T token | 0.0005 | 数据远多于参数,每个 token 只见一次 |
| Chinchilla 最优 | \(N\) | \(20N\) | 0.05 | 数据仍多于参数 |
| SFT:8B 模型,1 万条指令 | 8.0B | 约 5M token | 1600 | 极度过参数化——会过拟合 |
| 奖励模型:8B,10 万偏好对 | 8.0B | 约 50M token | 160 | 极度过参数化——reward hacking 的来源 |
把五行放到一根对数刻度的数轴上:
LLM 预训练在第二行:每个参数只”分到”两千个 token,模型远远背不下数据,过拟合不是主要风险,所以几乎不用 dropout、只训一个 epoch(第六章)。SFT 与奖励模型在第四、五行:与本文实验同一个区间,参数是数据的几百倍。同一个区间里本文实验不过拟合、SFT 却会——差别在于训练了多久、任务是什么、数据有没有噪声。这就是本文要讲清楚的事。
2. 本文的章节安排
| 章 | 主题 | 内容 |
|---|---|---|
| 二 | 经典视角与它失效的地方 |
|
| 三 | Double descent |
|
| 四 | 隐式正则化 |
|
| 五 | 显式正则化 |
|
| 六 | 为什么 LLM 预训练不用 dropout、只训一个 epoch |
|
| 七 | 过拟合回来的时候 |
|
| 八 | 诊断 |
|
| 九 | 案例:1,000 张图的过拟合与解药 |
|
| 十 | 本文小结 | |
| 十一 | 自测 | 5 道题 |
3. 来龙去脉:一个理论被现实推翻的过程
| 年 | 谁 | 当时的问题 | 怎么解决 | 效果 | 引入或遗留问题 |
|---|---|---|---|---|---|
| 1943 / 1970 |
|
病态的方程组解乱跳 | 给解加一个”小一点”的偏好 | 正则化这个词与 weight decay 的源头(第五章第 1 节,《LLM 时代的经典机器学习(03):逻辑回归与奖励模型——每个分类头的原型》的 Ridge) | 为什么”小一点”的解泛化更好,当时没有理论 |
| 1971–1995 | Vapnik & Chervonenkis | 什么决定一个模型在新数据上的表现 | 统计学习理论:用容量(VC 维)刻画泛化界,容量越大、样本越少,泛化越差 | 第二章的经典预言:模型不能比数据大——统治了几十年的泛化观 | 深网络参数远超样本却泛化得很好,预言在那里失效 |
| 2012 / 2014 |
|
AlexNet 6000 万参数、120 万张图,全连接层严重过拟合 | Dropout:训练时随机丢一半神经元,强迫表示冗余(第五章第 2 节) | 2012–2017 年几乎每个网络都用 | LLM 预训练一个 epoch 背不下数据,反而用不上它(第六章) |
| 2017 | Zhang 等,《Understanding deep learning requires rethinking generalization》 | 深网络参数远多于样本,按 VC 理论应该毫无泛化能力,却泛化得很好 | 用实验证明同一个网络能把随机标签背到 100%(第四章) | 容量不是度量,经典理论对深网络失效——泛化理论被公开动摇 | 那泛化到底随模型大小怎么变,没有解释 |
| 2018–2019 |
|
那泛化到底随模型大小怎么变 | double descent:画出测试误差先降、在插值阈值升到尖峰、再降的曲线(第三章) | “越大越好”在阈值右边成立——泛化随容量的新图景 | 解释的是现象不是机制:SGD 为什么恰好落在泛化好的解上仍无理论 |
| 2020 | GPT-3 | 1750 亿参数、3000 亿 token、一个 epoch | 不靠显式正则化:参数 / 数据比大到根本背不下数据 | 预训练不用 dropout、只训一遍也能泛化(第六章) | 高质量数据总有一天用完 |
| 2023 | Muennighoff 等,《Scaling data-constrained LMs》 | 高质量数据用完了怎么办 | 实测数据重复的边际收益 | 4 个 epoch 以内几乎无损,之后递减(第六章) |
|
这张表讲的是一个理论被现实推翻、再被新现象重建的过程:VC 理论说参数不能比样本多,2017 年的实验说深网络就是这么干的还泛化得很好,2019 年的 double descent 说清了”什么时候会出事”(插值阈值附近)、”什么时候不会”(远超过之后)。今天的结论分两个区间(第一节的数轴):数据主导区间里正则化几乎不需要(LLM 预训练),过参数化区间里需要(SFT、奖励模型、小数据微调)——而后者正是大多数人实际做的事。
二、经典视角与它失效的地方
1. 经典的预言
L2 经典机器学习系列的偏差 - 方差分解说:模型太简单,偏差大(欠拟合);模型太复杂,方差大(过拟合);测试误差随容量呈 U 形,最优点在中间。经典理论里”容量”由参数量(或 VC 维一类的度量)决定,所以规则是:参数量不要超过样本量太多,超过了就加正则化。
2. 现实
第九章的实验:4000 个 MNIST 样本,标签有 20% 被随机替换(制造噪声,让”背下训练集”与”学到规律”能区分),两层 MLP 宽度从 2 扫到 2048,Adam 训 6000 步到收敛:
| 宽度 | 参数量 | 参数 / 样本 | 训练错误率 | 测试错误率 | 测试 loss |
|---|---|---|---|---|---|
| 2 | 1.6K | 0.4 | 54.5% | 60.3% | 1.95 |
| 4 | 3.2K | 0.8 | 26.0% | 42.6% | 2.07 |
| 8 | 6.4K | 1.6 | 3.4% | 43.4% | 5.48 |
| 16 | 12.7K | 3.2 | 0.0% | 35.4% | 4.44 |
| 32 | 25K | 6.4 | 0.0% | 27.3% | 2.55 |
| 64 | 51K | 12.7 | 0.0% | 22.4% | 1.82 |
| 128 | 102K | 25 | 0.0% | 19.3% | 1.35 |
| 256 | 204K | 51 | 0.0% | 16.8% | 1.14 |
| 512 | 407K | 102 | 0.0% | 16.0% | 1.08 |
| 1024 | 814K | 204 | 0.0% | 15.4% | 1.01 |
| 2048 | 1.63M | 407 | 0.0% | 14.5% | 0.95 |
从宽度 16 起训练错误率就是 0——网络把 20% 的错误标签也全部背下来了。经典理论说此后测试误差应该越来越差。实际上:宽度 8 到 16 附近确实有一个尖峰(测试 loss 从 2.07 冲到 5.48),然后一路变好,到 2048 时是全表最好。参数是样本 407 倍的网络,泛化最好。
经典理论没有错,错的是用参数量当容量。”容量”指的是模型能表示多复杂的函数;经典理论假设参数越多能表示的函数越多、就越容易学到花里胡哨的解。但参数量只说了”能表示什么”,没说”训练会挑到哪一个”。一个例子:宽度 2048 的网络能拟合训练集的参数组合有无穷多种,其中有的把 20% 错误标签用极其扭曲的函数硬记下来,有的用一个几乎平滑的函数顺带记住——两者训练误差都是 0,但测试表现天差地别。梯度下降从小的随机初始化出发、一步步走,总是先找到那些平滑的、简单的解,扭曲的解它根本走不到。所以深网络的”有效容量”由训练过程决定:优化器会在所有能拟合训练集的解里挑一个特定的,而这个解的复杂度远低于参数量所允许的。这就是隐式正则化(第四章会展开:为什么梯度下降偏爱简单解、这和 weight decay 有什么区别)。在讲它之前,先看清那个尖峰。
三、Double descent
1. 曲线的三段
上面的表画出来是 Belkin 等 2019 命名的 double descent:
第九章的宽度扫描画出来:
Nakkiran 等 2019 在 CIFAR-10 上的 ResNet-18 画出了同一个形状——下图是他们论文的图 1,横轴是网络宽度,测试误差在”插值阈值”处凸起再下降,而且训练更久(右图)尖峰更明显:
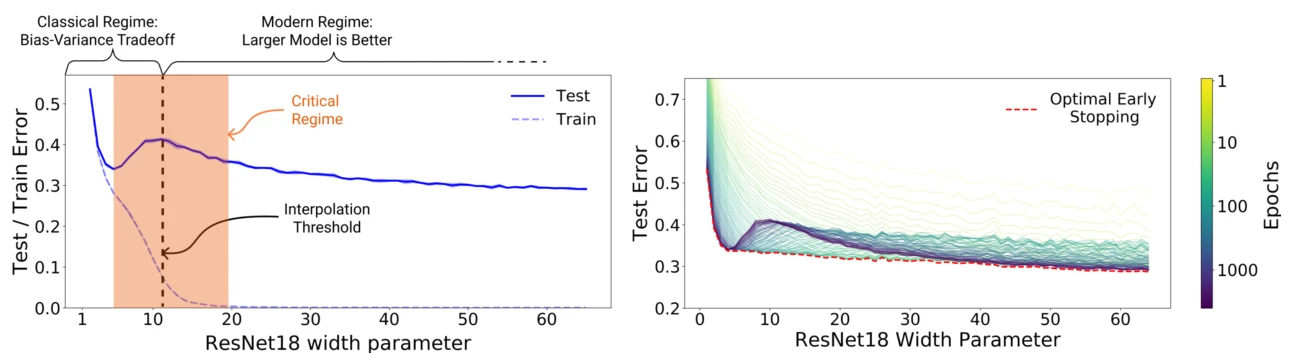
第一段是经典的 U 形(宽度 2 → 4:偏差下降);尖峰在插值阈值——模型刚好能把训练集(含噪声标签)拟合到零误差的地方(宽度 8 → 16);越过阈值后是第二次下降,越宽越好。Nakkiran 等 2019 在 ResNet、Transformer 上都观察到同样的形状,并发现它也随训练时长出现(epoch-wise double descent):训练更久有时先变差再变好。
2. 尖峰为什么出现
在插值阈值上,能拟合全部训练样本的解几乎唯一——参数刚够用,网络没有选择,只能扭曲自己去穿过每一个点,包括 20% 的错误标签。穿过错误标签需要在那些点附近做出剧烈的弯曲,弯曲波及周围的测试样本,测试误差爆炸;测试 loss 比错误率更敏感(5.48),因为那些被扭曲的区域给出了自信而错误的预测。
越过阈值后,能拟合训练集的解变成一个高维的集合,优化器可以从中挑最”平缓”的那个:穿过错误标签的点,但用最小的弯曲,对周围的影响最小。宽度越大,这个集合越大,能找到的解越平缓。这就是第二次下降。
3. 对实践的含义
两条。第一,不要停在插值阈值附近:一个”刚刚好能拟合”的模型往往是最差的选择,要么明显小(接受欠拟合),要么明显大(进入第二次下降)。第二,加数据可能让同一个模型变差:数据量增加会把插值阈值往右推,一个原本在第二次下降区间的模型可能被推回尖峰上(Nakkiran 等的 “more data hurts”)。这两条在小数据微调时都会遇到。
四、隐式正则化
问题:过参数化时训练集对解的约束不够——能拟合训练集的插值解有无穷多个,训练到底会挑到哪一个?答案是:剩下的自由度由优化器填上,它不是任意地填。
1. 优化器的偏好
SGD(以及 Adam)有系统性的偏好:
最小范数解。 对线性模型(以及某些条件下的宽网络),从零初始化出发的梯度下降收敛到所有插值解中范数最小的那个——梯度始终落在数据张成的子空间里,垂直方向的分量从不被更新。范数小意味着函数平缓。
一个能算到底的例子:单样本 \(x = (1, 2)\)、\(y = 5\) 的线性回归,解集是直线 \(w_1 + 2 w_2 = 5\) 上的所有点。平方损失上从零初始化出发的梯度下降,轨迹一直停在 \(x\) 张成的方向上,收敛到 \(w^* = (1, 2)\)——直线上范数最小的点,\(\|w^*\| = \sqrt{5} \approx 2.236\);同样插值的解 \((5, 0)\) 范数是 \(5\)。优化器没有“选择”去最小范数点,是初始化加上梯度方向把它钉在了那里。
平坦极小值。 SGD 的噪声(《深度学习基础(06):优化器——从 SGD 到 AdamW 与学习率调度》「SGD 与它的噪声」中的尺度 \(\eta / \sqrt{B}\))让参数在尖锐的极小值里待不住——一点扰动就跳出去——而在平坦的极小值里能停下。平坦的极小值对参数扰动不敏感,通常也对输入扰动不敏感,泛化更好。这解释了一个反复被观察到的现象:大 batch(噪声小)训出来的模型泛化略差,即使训练 loss 相同;也解释了为什么学习率衰减要留到最后——早期的大噪声是在挑盆地。
先学简单的。 网络在训练早期先拟合低频、简单的模式,晚期才去拟合高频、复杂的(包括噪声标签)。这就是早停有效的原因:在网络开始拟合噪声之前停下。
效果:第二章的表里,参数是样本 407 倍的网络测试错误率 14.5%、全表最好——优化器挑出来的解远比参数量允许的简单。隐式正则化不收任何费用:不用改 loss、不用加约束,它是训练过程自带的。
遗留问题:这些偏好不可控——它们是优化器与超参(学习率、batch、初始化)的性质,换一个优化器、换一组超参,挑到的解就不同;也没有任何机制保证它挑的解“简单”——下面 Zhang 等 2017 的实验说明,只要数据里没有结构可学,网络照样子背下随机标签。
2. 随机标签也能背下来
Zhang 等 2017 做了一个干净的实验:把 CIFAR-10 的标签全部打乱成随机的,标准的 CNN 照样能把训练集拟合到零误差。结论是网络的容量足以记住任何数据,所以容量不是它在真实数据上泛化好的原因。泛化好,是因为真实数据里有结构、优化器先学结构、结构比噪声容易拟合。
这个实验也给出了本篇最有用的一个诊断工具:记忆探针——如果模型能逐字复现训练样本,它在背,不是在学(第七、八章)。
五、显式正则化
隐式正则化是免费的;显式正则化是额外加的约束,每种都可以理解为”把模型拉向某种简单解的先验”。五种常用手段放在一起:
| 方案 | 针对的问题 | 怎么解决 | 效果(第九章实测) | 引入或遗留问题 |
|---|---|---|---|---|
| Weight decay | 参数无约束地涨、函数越走越扭曲 | 给参数一个高斯先验:loss 加 \(\lambda|\theta|^2\),或 AdamW 里解耦衰减 | 测试 loss @300 epoch 从 0.548 压到 0.422(\(\lambda = 0.5\)),改变过拟合的终点 |
|
| Dropout | 神经元共适应、有效容量太大 | 训练时以概率 \(p\) 置零并乘 \(1/(1-p)\) 保持期望 | \(p = 0.5\) 前 10 epoch 与 weight decay 相当(0.39),300 epoch 后反而最差(0.62) |
|
| 早停 | 训练后期网络开始拟合噪声 | 验证 loss 的拐点处停止 | 无正则时最优点在第 10 epoch(测试 loss 0.40),之后涨到 0.55 |
|
| Label smoothing | one-hot 逼着 logit 差走向无穷、模型过度自信 | 正确类目标换成 \(1-\epsilon\),其余类均分 \(\epsilon\) | 改善校准(本章用一条曲线说明机制) | 置信度被人为压低,对蒸馏、奖励模型等下游要小心 |
| 数据增强 | 数据量不足、多样性不够 | 给数据加”这些变换不改变标签”的先验 | CV 里最强的正则化 | LLM 预训练几乎不用:数据够多,语言的标签不变变换难定义 |
1. Weight decay:高斯先验
问题:参数没有约束地涨,拟合出来的函数越来越扭曲。
怎么解决:给参数一个均值 0、方差 \(\sigma^2\) 的高斯先验 \(p(\theta) \propto \exp(-\|\theta\|^2 / 2\sigma^2)\),最大后验估计(L0 数学系列第五篇的 MAP)在负对数似然上多出一项 \(\frac{1}{2\sigma^2}\|\theta\|^2\)——这就是 \(L_2\) 正则,\(\lambda = 1/\sigma^2\)。它说的先验是”参数应该小”,也就是”函数应该平缓”。《深度学习基础(06):优化器——从 SGD 到 AdamW 与学习率调度》的「五、AdamW 与 L2 正则的区别」讨论了它在 Adam 下的正确形式与它在 LLM 里作为”范数平衡点”的含义。
一个数字感受它的力度:AdamW 的解耦衰减是每步把参数乘 \(1 - \eta\lambda\)。\(\eta = 10^{-3}\)、\(\lambda = 0.5\) 时这个因子是 \(0.9995\);如果梯度是零,一个权重 1000 步后收缩到 \(0.9995^{1000} \approx 0.606\)——衰减不依赖 loss,它一直把参数往零点拉。
效果:第九章的实验里,1000 个样本、AdamW \(\lambda = 0.5\),300 个 epoch 后测试 loss 是 0.42,不加是 0.55——weight decay 把训练后期测试 loss 的上升压平了大半。
引入或遗留问题:\(\lambda\) 要自己调;而且在 AdamW 语义下它控制的是参数范数的平衡点,”防过拟合”只是小数据场景下顺带的效果(第六章)。
2. Dropout:期望等价与集成
问题:神经元相互依赖地共同适应——一个特征靠另一个特征在场才有用,换一个数据分布就散架;同时有效容量太大,足以背下训练集。
怎么解决:Dropout(Srivastava 等 2014)训练时以概率 \(p\) 把每个激活置零,并把剩下的乘 \(1 / (1 - p)\)(inverted dropout,让期望不变:\(\mathbb{E}[\tilde a] = (1 - p) \cdot a / (1 - p) = a\));推理时什么都不做。
一个具体例子看乘性缩放:激活 \(h = [2, 4, 6, 8]\)、\(p = 0.5\)、这一步的 mask 是 \([1, 0, 1, 0]\),那么训练时的输出是 \([2, 0, 6, 0] \times 2 = [4, 0, 12, 0]\)——被保留的单元放大一倍,被丢掉的输出零;每个单元的期望不变,推理时既不做 mask 也不做缩放。两种理解:
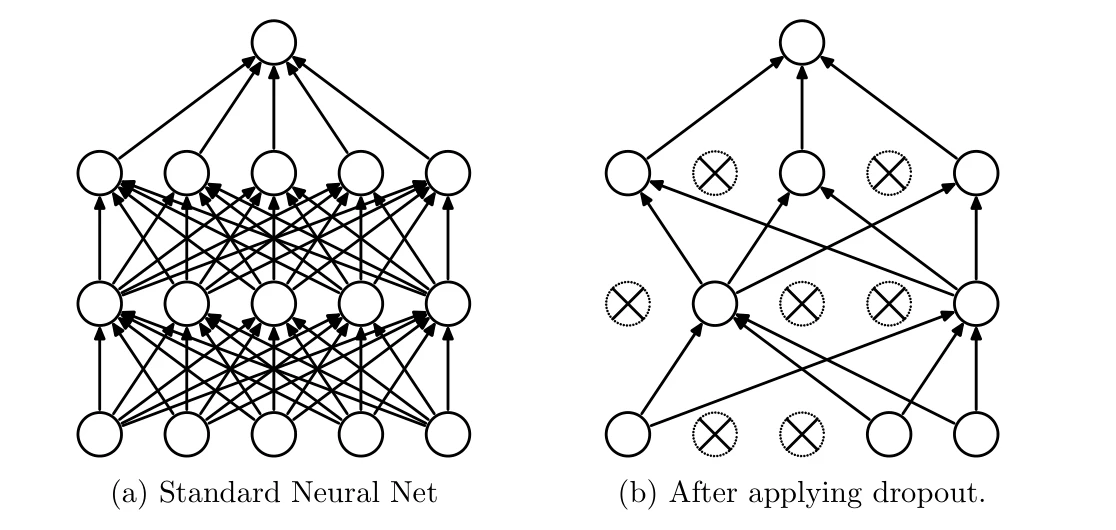
集成视角。 每个 batch 用的是一个随机子网络,\(n\) 个神经元有 \(2^n\) 个子网络,训练在同时训所有子网络的一个加权平均;推理时用完整网络,近似于这 \(2^n\) 个子网络的集成(L2 经典机器学习系列第一篇:集成降方差)。
噪声视角。 Dropout 给激活注入乘性噪声,逼迫每个神经元不依赖特定的其他神经元(防止”共适应”),学到的特征更冗余、更稳健。做过分布式系统的读者会认出这个思路:它和混沌工程随机杀掉节点是同一件事——训练时随机让一部分神经元”宕机”,剩下的必须能独立把任务做完,于是没有任何一个特征能成为单点。区别在于混沌工程验证的是既有系统的冗余,dropout 是在训练过程中逼出冗余;推理时所有神经元都在,相当于一个从未同时演练过的满配集群,inverted dropout 的 \(1/(1-p)\) 缩放就是为了让满配时的输出尺度与演练时一致。
效果:第九章的实验里 \(p = 0.5\) 在前 10 个 epoch 与 weight decay 效果相当(测试 loss 0.39),但训到 300 个 epoch 后反而是最差的(0.62):dropout 拖慢了过拟合的速度,没有改变它的终点。
引入或遗留问题:训练时有效容量变小(每步只有 \((1 - p)\) 的神经元在工作),收敛更慢;对已经有足够数据的场景收益小甚至为负——第六章讲 LLM 为什么不用它。
3. 早停
问题:训练后期网络开始拟合噪声——held-out loss 掉头向上时,训练 loss 还在往下走。
怎么解决:在验证 loss 开始上升时停止训练。对线性模型可以证明它等价于 \(L_2\) 正则,正则强度反比于训练步数 × 学习率(\(\lambda \approx 1 / (\eta t)\));对深网络它是第四章”先学简单的”的直接利用。
效果:第九章里不加正则化时最优停止点在第 10 个 epoch(测试 loss 0.40),之后一路涨到 0.55——停在那里等于白捡一个正则化。
引入或遗留问题:它几乎没有代价,只要求留出验证集并定期评估——这是横切”实验方法论”里最便宜的一条规则;但它只决定何时停,模型本身学到的还是不加约束的解。
4. Label smoothing 与数据增强
Label smoothing(Szegedy 等 2016):
问题:one-hot 标签下交叉熵只有在 logit 差趋于无穷时才到零——训练会一直推着正确类的 logit 往上走,模型对一切判断都过度自信,校准很差。
怎么解决:把 one-hot 换成 \((1 - \epsilon)\) 在正确类、\(\epsilon / (C - 1)\) 均分给其他类,\(\epsilon\) 常取 0.1。算一条曲线看效果:\(C = 10\)、\(\epsilon = 0.1\) 时正确类目标是 \(0.9\)、其余每类 \(0.1 / 9 \approx 0.0111\);设正确类与错误类的 logit 差为 \(g\)(logits 取 \((g, 0, \dots, 0)\)),one-hot 的交叉熵随 \(g \to \infty\) 单调趋 0,而平滑后的 loss 在 \(g^* = \ln(0.9 \cdot 9 / 0.1) = \ln 81 \approx 4.394\) 处取最小值——logit 差再大 loss 反而上升,模型被推回有界的自信。
效果:改善校准——输出的概率更接近真实正确率。
引入或遗留问题:模型的置信度被人为压低,对需要校准概率的下游(蒸馏、奖励模型)要小心。
数据增强(图像的裁剪翻转、文本的回译与同义替换):
问题:数据量不足、多样性不够。
怎么解决:给数据加先验:”这些变换不改变标签”。
效果:CV 里最强的正则化。
引入或遗留问题:在 LLM 预训练里几乎不用——数据够多,且语言的”标签不变的变换”难以定义。
5. 实测:四种配置
1000 个训练样本、宽 512、AdamW \(\eta = 10^{-3}\)、300 个 epoch:
| 配置 | 第 10 epoch 测试 loss | 第 300 epoch 测试 loss | 第 300 epoch 训练 loss | 最优早停点 | 准确率(300 ep) |
|---|---|---|---|---|---|
| 无正则化 | 0.402 | 0.548 | 0.000 | ep 10 | 89.1% |
| weight decay 0.5 | 0.392 | 0.422 | 0.000 | ep 40 | 89.6% |
| dropout 0.5 | 0.391 | 0.617 | 0.000 | ep 10 | 89.5% |
| 两者都加 | 0.386 | 0.421 | 0.000 | ep 10 | 89.8% |
四种配置的准确率都在 89% 上下,几乎没有差别;差别全在测试 loss——它随训练持续上升,而准确率不动。这是过拟合在深网络上最常见的形态:模型没有把更多测试样本判错,而是对判错的那些越来越自信(logits 越来越大)。第八章会把它作为一个诊断信号。
六、为什么 LLM 预训练不用 dropout、只训一个 epoch
1. 数据主导区间:欠拟合的一侧
回到第一章的表:Llama-3-8B 每个参数分到约 1900 个 token。这个区间里模型是欠拟合的——训练 loss 与验证 loss 几乎重合(差在 0.01 nat 量级),加更多数据、更多算力 loss 还会降(这正是 scaling law 描述的)。过拟合不是风险,容量才是瓶颈。任何减少有效容量的正则化(dropout 最典型)都在浪费算力。GPT-2 还用 dropout 0.1;GPT-3 之后的大模型几乎全部去掉;Llama、Qwen、DeepSeek 的 config 里没有 dropout。
Weight decay 保留了下来,但如《深度学习基础(06):优化器——从 SGD 到 AdamW 与学习率调度》所述,它在这里的角色主要是控制参数范数与有效学习率,不是防过拟合。
2. 一个 epoch
数据多到训不完一遍时,多 epoch 没有意义——每个 token 只见一次,也就不存在”背下来”。当数据受限、必须重复时,Muennighoff 等 2023 的实验给出了量化结论:重复到 4 个 epoch 以内,loss 与用同样多的全新数据几乎没有差别;之后收益迅速递减,到几十个 epoch 时重复数据的价值趋近于零。他们据此修正了 scaling law,给出了数据受限下参数与 epoch 的最优分配。当前实践:高质量数据(代码、数学、教科书)重复 2–4 个 epoch 是常见做法,网页数据基本只过一遍。
3. 与本文实验的关系
第一章的表说清了为什么第二章的 MLP 与 LLM 预训练看起来矛盾却不矛盾:前者在过参数化区间,靠隐式正则化不过拟合,但如果训得足够久、数据有噪声,测试 loss 仍会缓慢上升(第五章表里的”无正则化”一行);后者在数据主导区间,根本没到能过拟合的地方。SFT 把一个 8B 的模型放回过参数化区间——下一章。
七、过拟合回来的时候
1. 小语言模型上的三种数据量
第九章训了一个字符级的 MLP 语言模型(上下文 8 个字符,约 12 万参数),语料是 Python 标准库的源码,训练数据分别取 2 万、20 万、200 万字符,每个 epoch 后测 held-out loss,并做一个记忆探针:随机取训练文本里的 200 个位置,给模型 8 个字符的前缀,贪心生成 32 个字符,统计与原文逐字相同的比例。
| 训练字符数 | 参数 / 字符 | held-out loss 最低点 | 最低值 | 此后 | 逐字记忆率 |
|---|---|---|---|---|---|
| 20K | 5.8 | 第 16 epoch | 2.41 |
|
2.5%(8 ep)→ 5.5%(16 ep)→ 10%(40 ep) |
| 200K | 0.58 | 第 8 epoch | 1.61 |
|
≤ 1% |
| 2M | 0.06 | 第 10 epoch 仍在降 | 1.60 | — | 0% |
三行是同一个模型、同一份代码,只有数据量不同:2 万字符时第 16 个 epoch 起 held-out loss 掉头上升、训练 loss 继续降、模型开始逐字背源码;20 万字符时拐点推到第 8 个 epoch、记忆率几乎为零;200 万字符时 10 个 epoch 还没到拐点。把第一行的逐 epoch 数字画出来:
数据每多 10 倍,能安全训练的 epoch 数就多几个,而”背下来”只在参数明显多于数据时发生。
2. SFT
SFT 就在第一行那个区间:8B 模型、几千到几万条指令(几百万 token),参数是 token 的上千倍。典型现象:训练 loss 平滑下降,验证 loss 在第 2–3 个 epoch 后回升,模型对训练集里的问题逐字复述回答、对稍微改写的问题失去泛化。当前实践因此把 SFT 控制在 2–3 个 epoch;数据量大(几十万条以上)时 1–2 个;学习率比预训练小一个量级(《深度学习基础(06):优化器——从 SGD 到 AdamW 与学习率调度》的「峰值学习率的量级」)也是同一个考虑——不要把预训练学到的表示冲掉。检测手段就是上面的记忆探针:拿训练集的 prompt 让模型生成,与训练集的回答比对。
3. 奖励模型
奖励模型是第一章表的最后一行,也是 L2 经典机器学习系列讨论过的 reward hacking 的来源:几万到几十万偏好对训一个 8B 模型,1 个 epoch 之后验证准确率就不再涨、2 个 epoch 后开始降,是常见的经验。它比 SFT 更敏感,因为它的输出是一个标量,”背下来”的方式是记住表面特征(长度、格式、语气)——这些特征在训练集上与偏好相关,被 RL 优化后放大到荒谬。经典解法都适用:更多更多样的数据、早停、集成、正则化(KL 惩罚)。
八、诊断
| 信号 | 看什么 | 含义 |
|---|---|---|
| 训练 / 验证 gap | 两条 loss 曲线的差 |
|
| 验证 loss 的拐点 | held-out loss 从降到升的那个 epoch |
|
| 测试 loss 涨而准确率不变 | 第五章的表 |
|
| 记忆探针 | 给训练样本的前缀,看模型是否逐字复现 |
|
| 参数 / 数据比 | 第一章的表 | 训练开始前就能算出来:比值大于 1 就要准备早停与验证集,大于 100 就要预期几个 epoch 内过拟合 |
最后一条最便宜、也最常被忽略:训练之前先算参数 / 数据比,就知道该不该担心过拟合。预训练不必担心,SFT 与 RM 一定要。
九、案例:1,000 张图的过拟合与解药
问题:前面几章的数字来自三组实验,这一章把它们放在一起说清楚各自在回答什么。三个问题各一个实验:参数比数据多很多倍时会怎样(1,000 张训练图、40 万参数、训 300 个 epoch——第五章的四种配置);模型大小怎么影响泛化(4,000 张、20% 错标签、宽度从 2 扫到 2048——第三章的 double descent);过拟合在语言模型上长什么样(字符级小语言模型、三种数据量——第七章的逐字记忆)。曲线在第三、五章,这里是代码、完整数字和第三组实验。
1. 代码
在系列基座上加两个层:Dropout(inverted,训练 / 推理两种模式)与 Embedding(查表;反向用 np.add.at 把梯度散射回对应的行)。三组实验:
# double descent:4000 样本、20% 标签噪声、宽度扫描、Adam 全 batch 6000 步
for w in [2, 4, 8, 16, 32, 64, 128, 256, 512, 1024, 2048]:
    net = Net([Linear(784, w), ReLU(), Linear(w, 10)])
    ...  # 训到收敛,记录训练 / 测试错误率与测试 loss

# 正则化:1000 样本、宽 512、四种 (wd, dropout) 组合、300 epoch,记录 train / test loss 曲线

# 小语言模型:Embedding(V, 16) → Linear(8*16, 512) → ReLU → Linear(512, V)
# 数据 2 万 / 20 万 / 200 万字符,每 epoch 测 held-out loss 与逐字记忆率
2. 结果
Double descent 与正则化的完整表在第二、五章。小语言模型 2 万字符一组的逐 epoch 数字:
| epoch | 训练 loss | held-out loss | 逐字记忆率(32 字符) |
|---|---|---|---|
| 1 | 3.166 | 3.091 | 0.0% |
| 4 | 2.353 | 2.596 | 0.5% |
| 8 | 1.790 | 2.431 | 2.5% |
| 16 | 1.213 | 2.408 | 5.5% |
| 24 | 0.850 | 2.527 | 5.5% |
| 32 | 0.606 | 2.734 | 7.0% |
| 40 | 0.438 | 2.975 | 10.0% |
三组实验在笔记本 CPU 上共约 6 分钟(double descent 一组最慢,宽度 2048 的全 batch 训练占了大半)。
3. 值得自己动手的扩展
- 把标签噪声从 20% 改成 0% 重跑 double descent,看尖峰是否消失(没有噪声时插值阈值上的解不需要扭曲);
- 固定宽度 64,扫训练步数 100 到 20000,看 epoch-wise double descent;
- 在小语言模型上把参数量放大 10 倍(宽 5120),看 200K 字符那一行的拐点提前到哪里、记忆率升到多少。
十、本文小结
- 先算参数 / 数据比:LLM 预训练是 0.0005(数据主导,欠拟合区间),SFT 与奖励模型是几百到上千(过参数化区间)。两个区间的规则不同。
- 过参数化区间里深网络不过拟合,是因为优化器挑解:最小范数、平坦极小值、先学简单的——隐式正则化。容量不是度量,网络能背下随机标签(Zhang 等 2017)。
- Double descent:测试误差随容量先降、在插值阈值处尖峰(实测宽度 8 处测试 loss 5.48)、再一路下降(宽度 2048 最好,参数是样本的 407 倍)。不要停在阈值附近;加数据可能让同一模型变差。
- 显式正则化各是一种先验:weight decay 是高斯先验(实测把测试 loss 的上升从 0.55 压到 0.42);dropout 是集成 / 噪声(拖慢过拟合,不改变终点);早停利用”先学简单的”(最便宜);label smoothing 改善校准但压低置信度。
- LLM 预训练不用 dropout、只训一个 epoch,因为在数据主导区间里容量是瓶颈;数据受限时重复到 4 个 epoch 以内几乎无损,之后收益递减(Muennighoff 等 2023)。
- 过拟合在 SFT 与奖励模型上回来:小语言模型实验里 2 万字符时第 16 个 epoch 起 held-out loss 回升、逐字记忆率升到 10%;20 万字符拐点在第 8 个 epoch;200 万字符 10 个 epoch 未到拐点。
- 诊断:训练 / 验证 gap、held-out 拐点、测试 loss 涨而准确率不变 = 过度自信、记忆探针。
- 下一篇进入结构史:《深度学习基础(08):CNN——从 LeNet 到 ResNet,再到 ViT》,看卷积网络解决了什么、ResNet 留下了什么、ViT 怎么把图切成 token。
配套代码:deep-learning-foundations/04_regularization.py——dd / reg / lm 三个子实验,完整跑约 15 分钟,--quick 两分钟;字符级语料用的是 Python 自带的标准库源码,不需要下载。第三、五章的曲线由 case_04_regularization_plots.py 画出,第一、三、四、五、七章的概念图与工作实例由 case_04_concept_figures.py 画出(不需要训练)。
十一、自测
-
SFT 一个 8B 模型,1 万条指令约 500 万 token;预训练 Llama-3-8B 用 15T token。两者的参数 / 数据比各是多少、在哪个区间?
答案
SFT:\(8 \times 10^9 / 5 \times 10^6 = 1600\),过参数化区间,会过拟合;预训练:\(8 \times 10^9 / 1.5 \times 10^{13} \approx 0.0005\),数据主导,每个 token 只见一次,过拟合不是主要风险。
-
double descent 曲线的尖峰出现在哪里?为什么在那里加数据可能让同一个模型变差?
答案
在插值阈值——模型刚好能把训练集(含噪声标签)拟合到零误差的容量处。加数据把阈值往右推,一个原本在阈值右侧(已进入第二次下降)的模型可能正好落到新的阈值上。
-
dropout \(p = 0.5\) 训练时把激活乘什么?推理时做什么?为什么 LLM 预训练不用它?
答案
训练时以 0.5 概率置零、剩下的乘 \(1/(1-p) = 2\) 保持期望;推理时什么都不做。预训练在数据主导区间里容量是瓶颈,dropout 减少有效容量、拖慢收敛,而过拟合本来就不是风险。
-
weight decay 对应什么先验?实验里它把测试 loss 的上升从多少压到多少?它改变了过拟合的终点还是速度?
答案
参数上的高斯先验(MAP 视角);从 0.55 压到 0.42;改变了终点——它限制了参数范数,模型能背下的东西变少。相比之下 dropout 只拖慢速度、不改变终点。
-
验证集上 loss 在涨、准确率却不动——发生了什么?该看哪个探针确认?
答案
过度自信:模型对答对的题给出越来越极端的概率,错的题也越来越自信,交叉熵被少数极端错误拉高而 argmax 不变。看校准(预测概率 vs 实际正确率)与记忆探针(逐字复现训练样本的比例)。
-
过参数化时能拟合训练集的解有无数个,优化器(SGD / Adam 从小初始化出发)挑的是最小范数、平坦的、「先学简单的」那一个——隐式正则化;容量不是度量,同一个网络能背下随机标签。实测宽度 2048(参数是样本的 407 倍)的测试 loss 反而最好——double descent 的第二次下降。详见第二至四章。 ↩
-
参数 / 数据比进入几百到上千的区间、且训练足够多个 epoch。小语言模型实验:2 万字符时第 16 个 epoch 起 held-out loss 回升、逐字记忆率升到 10%;20 万字符拐点在第 8 个 epoch;200 万字符 10 个 epoch 未到拐点。LLM 预训练 \(N/D = 0.0005\) 只训一个 epoch,不在这个区间里;SFT 与奖励模型在。详见第六章、第七章。 ↩
-
四条曲线:held-out loss 的拐点、训练 / 验证 gap、测试 loss 涨而准确率不变(过度自信)、记忆探针。早停是最便宜的对策。详见第八章。 ↩
系列 《深度学习基础:从反向传播到残差》 第 7 / 11 篇 入门
系列总览 — 为什么这样组织、读它需要什么、读完能做什么 · 幻灯片 — 整个系列的精华,一份可分享的 deck
学习地图 — AI 算法工程师学习地图 第 4 / 12 个系列
上一篇:优化器——从 SGD 到 AdamW 与学习率调度下一篇:CNN——从 LeNet 到 ResNet,再到 ViT
下一个系列:Transformer 原理与实现:从论文到手搓 GPT-2 进阶 · 5 篇,约 1.2 小时
本文由 arganzheng 创作,采用 CC BY 4.0 许可协议。在保留原文作者、署名以及完整原文链接(https://arganzheng.life/regularization-and-generalization.html)的前提下,欢迎各种形式的转载、翻译或商业引用。
COMMENTS
评论存放在 GitHub Discussions, 用 GitHub 账号登录即可发表,支持 Markdown。 想针对正文某句话说?选中那段文字,点浮出的「评论」即可划线评论;觉得哪里写错了,发表时勾上「同时提交 Issue」。 有人回复你时 GitHub 会按你的通知设置发邮件,不用守在这里。