系列 《深度学习基础:从反向传播到残差》 第 4 / 11 篇 入门
系列总览 — 为什么这样组织、读它需要什么、读完能做什么 · 幻灯片 — 整个系列的精华,一份可分享的 deck
学习地图 — AI 算法工程师学习地图 第 4 / 12 个系列
两层 Linear 中间放一个 ReLU,和把两层直接乘起来,表达能力完全不同。差别不在层数,而在中间那一下非线性。本篇把常见激活函数按这条线串起来:它们怎样让网络学到弯曲的边界,又怎样改变梯度、显存和算子开销。
如果把 100 层 Linear 叠起来,为什么它仍只能表示一个线性 / 仿射变换?1 sigmoid、ReLU、GELU 和 SwiGLU 分别解决了什么问题?2
一、总览:为什么需要非线性
线性层负责混合输入维度;激活函数打破线性,才让层叠起来的网络表示复杂函数。若每层之间没有非线性,任意多层 Linear 都能折叠成一个 Linear(带 bias 时是仿射变换)。
所以层数再多,也只相当于一个 \(W\) 和一个 \(b\)。《深度学习基础(03):反向传播——手推一个两层网络》的「两层网络前向」已经把这个矩阵乘法写出来了;这里沿用结论,不重做推导。
本篇从 sigmoid 与 tanh 的饱和讲起,经 ReLU 及其修补,走到平滑激活,再到现代 FFN 常用的门控变体。最后把曲线、梯度、参数形状和真实训练放在一起对照。
1. 本文的章节安排
| 章 | 主题 | 内容 |
|---|---|---|
| 二 | Sigmoid 与 tanh | 饱和、梯度消失、输出是否以 0 为中心 |
| 三 | ReLU |
|
| 四 | ReLU 的修补 | Leaky ReLU、PReLU、ELU 怎样为负半轴保留梯度 |
| 五 | 平滑激活 | GELU、SiLU 与 GPT-2 使用的 tanh 近似 |
| 六 | GLU 家族 | GLU 与各变体怎样用门控分支筛选值分支 |
| 七 | 成本与融合 | 逐元素读写、kernel fusion、反向所需的保存 |
| 八 | 对照表 | 公式、导数、值域、代价与代表模型 |
| 九 | 案例:深层 MNIST MLP | 初始梯度、固定步数准确率、ReLU 死亡单元 |
| 十 | 本文小结 | |
| 十一 | 自测 | 6 道题 |
2. 名字速查:缩写、全称与读法
激活函数的名字大多是缩写拼起来的:LU 结尾 = Linear Unit(线性单元),前缀说明怎么改;GLU 结尾 = Gated Linear Unit(门控线性单元),前缀说明门用的是哪个函数。读法没有统一标准,下表列英文社区的常见读法。
| 缩写 | 英文全称 | 中文名 | 常见读法 | 一句话 |
|---|---|---|---|---|
| sigmoid | logistic sigmoid | S 形函数 | /ˈsɪɡmɔɪd/,“西格莫伊德” | 压到 \((0,1)\) |
| tanh | hyperbolic tangent | 双曲正切 | /tæntʃ/ “坦曲”,或逐字母 T-A-N-H | 压到 \((-1,1)\) |
| ReLU | Rectified Linear Unit | 修正线性单元 | /ˈrɛl.juː/,“瑞-路” | 负数归零 |
| Leaky ReLU | Leaky Rectified Linear Unit | 带泄漏的 ReLU | “利基 瑞路” | 负半轴留小斜率 |
| PReLU | Parametric ReLU | 参数化 ReLU | “P-瑞路” | 负半轴斜率可学 |
| ELU | Exponential Linear Unit | 指数线性单元 | 逐字母 E-L-U,或 /ˈiː.luː/ | 负半轴用指数 |
| GELU | Gaussian Error Linear Unit | 高斯误差线性单元 | /ˈdʒɛl.uː/,“杰-路” | 乘正态 CDF |
| SiLU | Sigmoid Linear Unit | sigmoid 加权线性单元 | /ˈsaɪ.luː/,“赛-路” | 乘 sigmoid |
| Swish | (不是缩写) | — | /swɪʃ/,“斯威什” | SiLU 加可学 \(\beta\) |
| GLU | Gated Linear Unit | 门控线性单元 | 逐字母 G-L-U,或 /ɡluː/ “glue” | 一支乘另一支的门 |
| ReGLU / GEGLU | ReLU-GLU / GELU-GLU | ReLU 门 / GELU 门的 GLU | “瑞-glue” / “吉-glue” | 门换成 ReLU / GELU |
| SwiGLU | Swish-GLU | Swish 门的 GLU | /ˈswɪɡ.luː/,“斯威-glue” | 门换成 SiLU(Swish,\(\beta=1\)) |
| FFN / MLP | Feed-Forward Network / Multi-Layer Perceptron | 前馈网络 / 多层感知机 | 逐字母读 | 见第六章 |
3. 来龙去脉:从饱和到门控
| 时间 | 激活函数(论文) | 当时的问题 | 怎么解决 | 效果 | 引入或遗留问题 | 主要应用模型 / 场景 |
|---|---|---|---|---|---|---|
| 早期 | Sigmoid / tanh(Rumelhart、Hinton 与 Williams,1986) | 需要可导的非线性让反向传播可用 |
|
|
|
|
| 2010–2012 |
|
sigmoid / tanh 饱和导致深层梯度消失、训练慢 |
|
AlexNet 报告四层 CNN 在 CIFAR-10 达到 25% 训练误差,比 tanh 网络快 6 倍 |
|
|
| 2013–2015 | Leaky ReLU(Maas 等,2013) / PReLU(He 等,2015) / ELU(Clevert 等,2015) | ReLU 死亡单元、输出非零中心 |
|
效果随任务而变,没有统一赢家 |
|
|
| 2016 | GELU(Hendrycks 与 Gimpel,2016) | ReLU 在 0 点硬截断、不光滑 | 用输入大小进行平滑软门控 | 成为 BERT、GPT-2、ViT FFN / MLP 的默认 |
|
BERT、GPT-2、ViT 的 FFN / MLP |
| 2016 | GLU(Dauphin 等,2016) | 卷积语言模型需要像 LSTM 门一样控制信息流 | 用 sigmoid 门控制值分支 | 在 GCNN 上验证门控卷积可行,后来成为 GLU 变体的母版 | 相比不分门控的卷积层多一张投影矩阵 | 门控卷积语言模型(GCNN) |
| 2017 | SiLU(Elfwing 等,2017) / Swish(Ramachandran 等,2017) | 与 GELU 同:ReLU 在 0 点硬截断、不光滑 |
|
Swish 的 \(\beta=1\) 在 Mobile NASNet-A、Inception-ResNet-v2 的 ImageNet top-1 分别提升 0.9、0.6 个百分点 |
|
|
| 2020 | GLU 变体:Bilinear、ReGLU、GEGLU、SwiGLU(Shazeer,2020,《GLU Variants Improve Transformer》) | 在固定参数预算下进一步提升 Transformer FFN 质量 | 把 GLU 的 sigmoid 门分别换成恒等、ReLU、GELU、SiLU,得到四种变体 |
|
|
二、Sigmoid 与 tanh:平滑,但会饱和
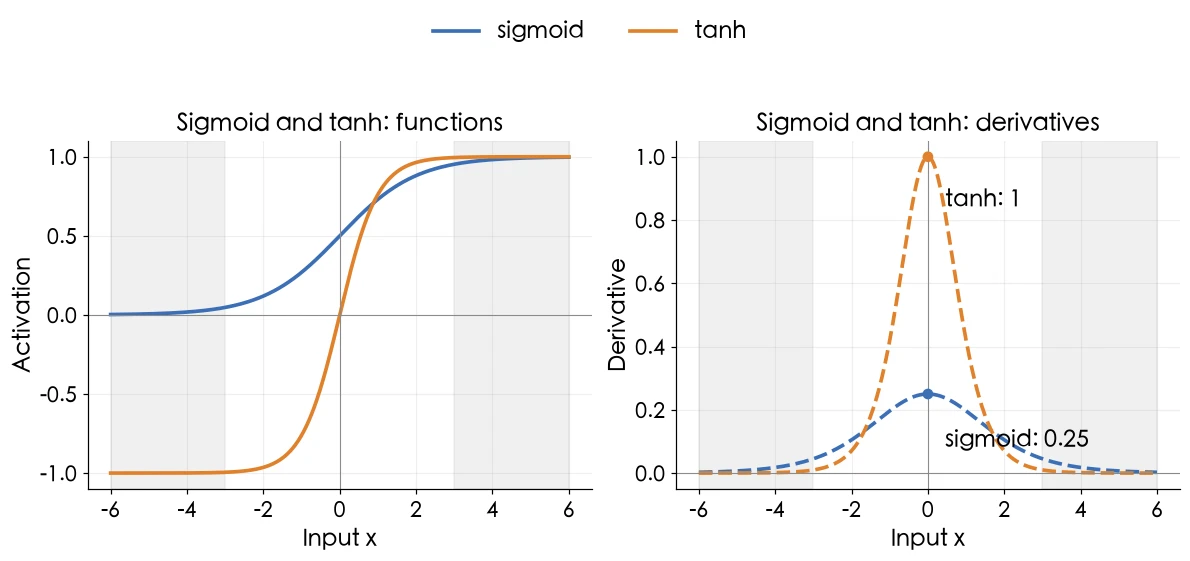
Sigmoid 把任意实数压进 \((0,1)\):
\[\sigma(x) = \frac{1}{1 + e^{-x}}, \qquad \sigma'(x) = \sigma(x)(1-\sigma(x))\]导数最大值出现在 \(x=0\),是 \(0.25\)。输入绝对值很大时,输出靠近 0 或 1,曲线变平,导数也靠近 0;这叫饱和。反向传播把每层导数连乘,若连续十层都在最有利情况下乘上 \(0.25\),梯度也只剩 \(0.25^{10} \approx 9.54 \times 10^{-7}\) 实际值还会乘上权重矩阵的导数因子。
若一个神经元的输入 \(x_i\) 全为正,权重梯度 \(\partial L/\partial w_i=\delta x_i\) 就都与 \(\delta\) 同号。一次更新只能把这组权重整体上移或整体下移,不能在输入维度间灵活调整,优化路径容易 zig-zag;tanh 的零中心输出能缓和这个问题。
zig-zag 指“之字形”折线。以两个权重为例:若最优方向是 \(w_1\) 变大、\(w_2\) 变小,而每一步只能让两者同增或同减,就只好先一起往上走一步、再一起往下走一步,在参数平面里来回折返,像锯齿一样逼近目标,比直线走过去慢得多。
tanh 把输出移到 \((-1,1)\),以 0 为中心:
\[\tanh'(x) = 1-\tanh^2(x)\]它在 0 点的最大导数为 1,但两端同样饱和。中心化改善了输入分布,却没有消除深层反向的连乘问题。
三、ReLU:简单、稀疏,也可能死亡
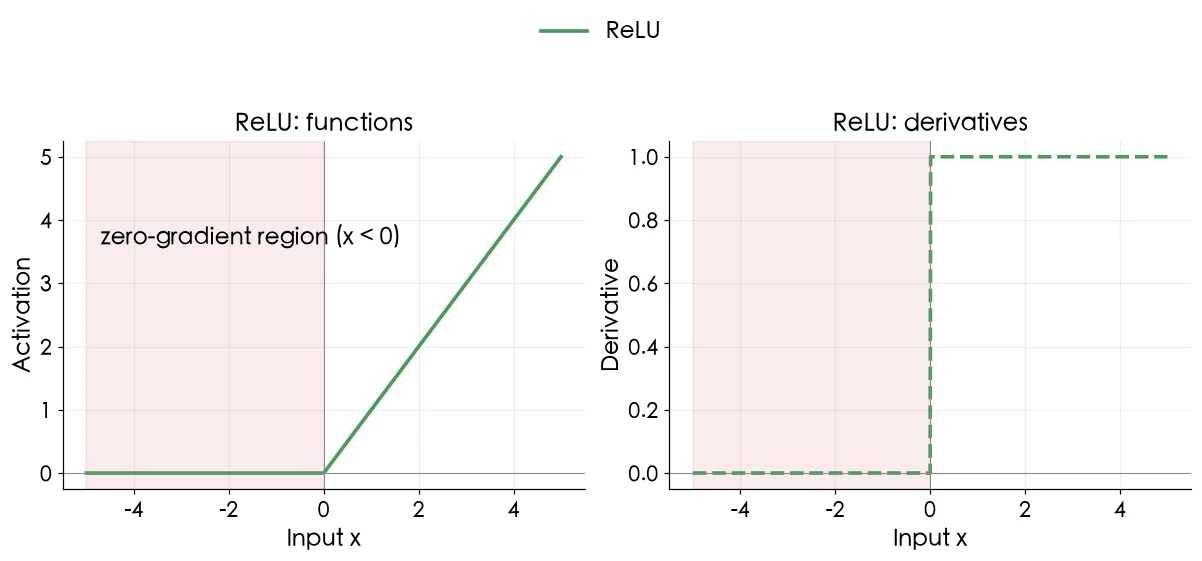
\[\operatorname{ReLU}(x)=\max(0,x), \qquad \operatorname{ReLU}'(x)= \begin{cases} 0 & x<0 \\ 1 & x>0 \end{cases}\]正半轴导数恰好为 1,不会像 sigmoid 那样把梯度再乘一个小于 1 的数。负半轴直接归零,让每个样本只有一部分神经元激活;计算只需比较和取最大值。
代价是负半轴的导数为零。如果某个单元对所有输入的预激活都变成负数,它输出永远为零,反向梯度也为零,参数无法靠梯度自己回来——这就是 dead ReLU。一次过大的更新可能把单元推到这个区域。
ReLU 让对称、零均值的信号有一半落到 0,初始化时需要补回这部分尺度。《深度学习基础(05):训练为什么不稳定——初始化、归一化与残差》的「ReLU 砍掉一半」推导了 Kaiming 初始化里的因子 2;这里不重复推导。
四、ReLU 的修补:负半轴留一点路
- Leaky ReLU:负半轴改为 \(\alpha x\),例如 \(\alpha=0.01\)。它保留一条小梯度,不需要学习额外参数。
- PReLU:把 \(\alpha\) 设成可学习参数,让模型自己选负半轴斜率。
- ELU:负半轴用 \(\alpha(e^x-1)\),输出下界为 \(-\alpha\);它能产生负值,但需要指数运算。
三者都保留了 ReLU 的正半轴直通梯度,又避免负半轴完全没有梯度。现代 Transformer FFN 更常选 GELU 或 SiLU;门控形式见第六章。
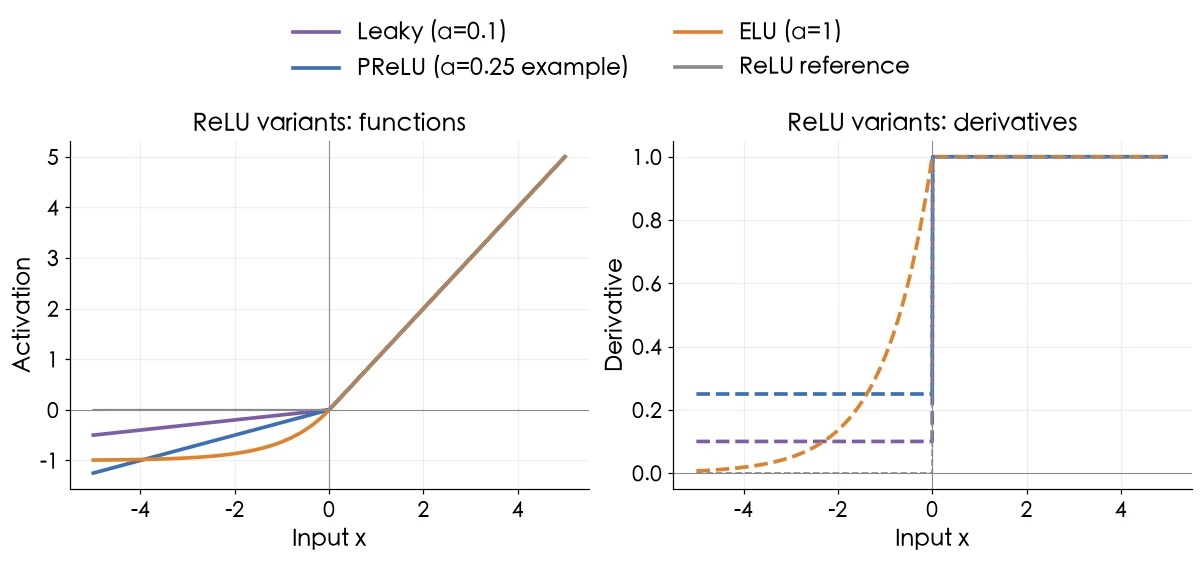
灰色细线是 ReLU 参考。为了看清负半轴,图中 Leaky ReLU 取 \(\alpha=0.1\),PReLU 取初始值 \(\alpha=0.25\),ELU 取 \(\alpha=1\)。
五、平滑激活:GELU 与 SiLU
GELU 用标准正态分布的累积分布函数 \(\Phi\) 给输入做软门控:
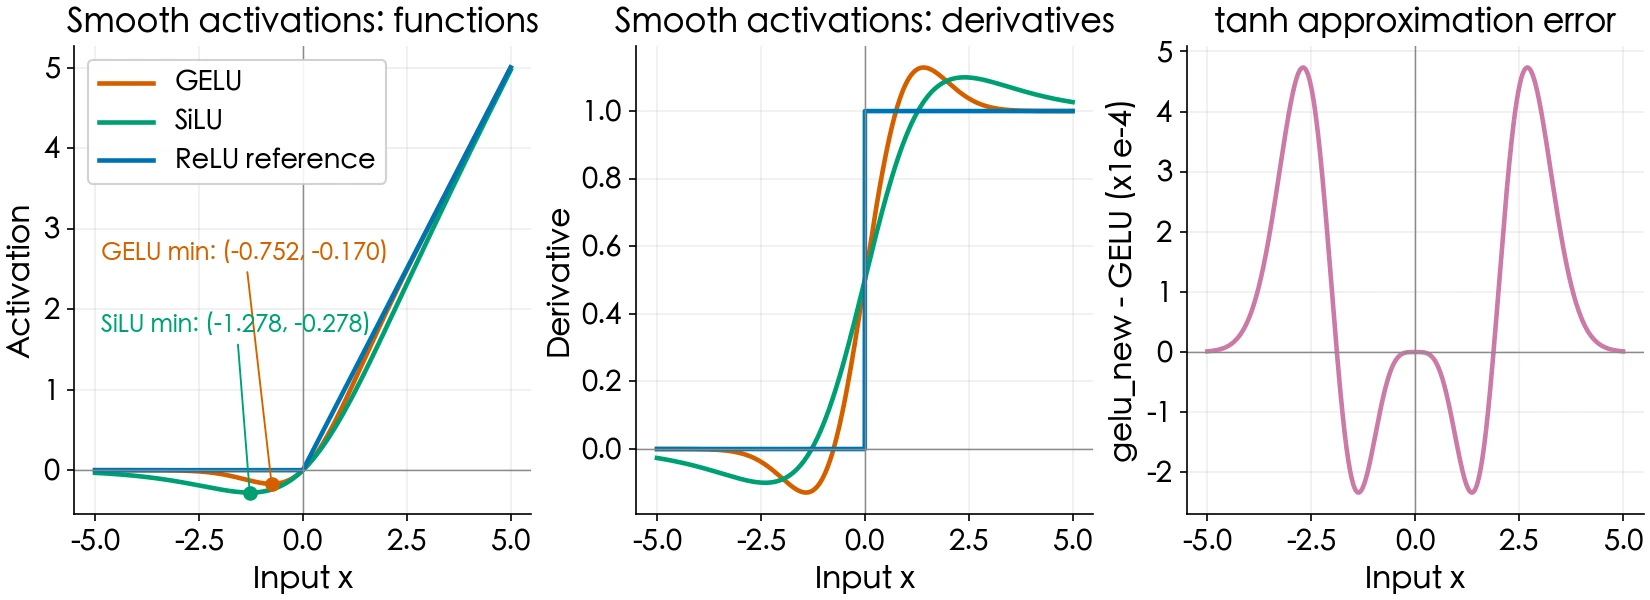
\[\operatorname{GELU}(x)=x\Phi(x)\]可以把它读作“以概率 \(\Phi(x)\) 保留输入 \(x\)”。它不像 ReLU 在 0 处突然折断;负输入大多被压小,正输入大多保留。导数为 \(\operatorname{GELU}'(x)=\Phi(x)+x\phi(x)\) 其中 \(\phi\) 是标准正态密度。GELU 不是单调函数:数值计算的极小点约为 \(x=-0.752\),函数值约 \(-0.170\)。
SiLU(也常叫 Swish,取参数 \(\beta=1\))是
\[\operatorname{SiLU}(x)=x\sigma(x), \qquad \operatorname{SiLU}'(x)=\sigma(x)+x\sigma(x)(1-\sigma(x))\]它在 \(x=-1.278\) 处达到约 \(-0.278\),也会轻微落到 0 以下。两者都平滑地衔接负、正输入;与 ReLU 相比,它们在负半轴保留了连续变化。
GPT-2 配置里的 activation_function 是 gelu_new。这是 GELU 的 tanh 近似:
在 \([-10,10]\) 上取 2,000,001 个等距点,与精确的 \(x\Phi(x)\) 比较,最大绝对误差约 \(4.73\times10^{-4}\)——这个量级在函数图上完全看不出两条曲线的差别,所以右图直接画它们的差。
六、GLU 家族:用一个分支控制另一个分支
1. 先看普通 FFN:它就是一个两层 MLP
MLP(Multi-Layer Perceptron,多层感知机)是“Linear → 激活 → Linear → …”这类全连接网络的统称。FFN(Feed-Forward Network,前馈网络)是 Transformer 里对其中一个子模块的叫法:每个 token 的向量各自过一遍同一个小 MLP,token 之间不交换信息(那是 attention 的事)。代码里这个模块通常就叫 mlp,例如 Hugging Face 的 GPT2MLP、LlamaMLP。
“两层”数的是 Linear 层,中间夹一个激活,也就是一个隐藏层:
\[\operatorname{FFN}(x)=g(xW_1)\,W_2,\qquad x\in\mathbb{R}^{d},\;W_1\in\mathbb{R}^{d\times d_{\mathrm{ff}}},\;W_2\in\mathbb{R}^{d_{\mathrm{ff}}\times d}\]\(W_1\) 升维(GPT-2 是 768 → 3072),\(g\) 是 ReLU 或 GELU,\(W_2\) 再降回 \(d\)。只有一层 Linear 时中间没有激活的位置,按第一章的结论它只是一个仿射变换;所以要有非线性,FFN 至少是两层。
2. 门控:让另一组投影决定“放行多少”
普通 FFN 里,第 \(i\) 个隐藏单元能否通过,只由它自己的预激活决定:\(\operatorname{ReLU}(h_i)\) 看 \(h_i\) 正负。GLU(Gated Linear Unit)把升维这一步拆成两支:
- 值分支 \(xV\):算出“要传的内容”;
- 门分支 \(xW\),过门函数后得到每一维的放行比例;
两支逐元素相乘(\(\odot\)),每一维由门决定传多少。原始 GLU 的门是 sigmoid,输出在 0 到 1 之间,像一排独立的音量旋钮:
\[\operatorname{GLU}(x)=(xV+c)\odot\sigma(xW+b)\]拿一个 3 维的小例子:值分支 \(xV=[2,\,-1,\,3]\),门分支 \(xW=[3,\,-3,\,0]\),则
\[\sigma(xW)\approx[0.95,\,0.05,\,0.50],\qquad xV\odot\sigma(xW)\approx[1.90,\,-0.05,\,1.50]\]第一维几乎全放行,第二维几乎被关掉,第三维放一半。关键在于:门看的是 \(xW\),与内容 \(xV\) 用的是不同的权重,模型可以学“根据输入的哪些特征来决定放行哪一维”,而 ReLU 只能“自己决定自己”。这也是 LSTM 里门的思路。
3. 换掉门函数,就得到各个变体
Shazeer(2020)保持“门 × 值”的结构不变,只把门函数 \(g\) 换掉(并去掉 bias):
\[\begin{aligned} \operatorname{Bilinear}(x)&=(xW)\odot xV \\ \operatorname{ReGLU}(x)&=\operatorname{ReLU}(xW)\odot xV \\ \operatorname{GEGLU}(x)&=\operatorname{GELU}(xW)\odot xV \\ \operatorname{SwiGLU}(x)&=\operatorname{SiLU}(xW)\odot xV \end{aligned}\]| 变体 | 门函数 \(g\) | 名字怎么来 | 代表模型 |
|---|---|---|---|
| GLU | sigmoid | Gated Linear Unit | Dauphin 等的门控卷积语言模型 |
| Bilinear | 恒等(不加门函数) | 两个线性投影相乘 = 双线性 | 论文对照组 |
| ReGLU | ReLU | ReLU + GLU | 论文对照组 |
| GEGLU | GELU | GELU + GLU | T5 v1.1、Gemma(论文写作 GeGLU) |
| SwiGLU | SiLU(Swish,\(\beta=1\)) | Swish + GLU | PaLM、LLaMA、Llama 3、Qwen2.5 |
注意 SiLU 与 sigmoid 不同:SiLU 的输出不限于 \((0,1)\),所以 SwiGLU 的门不再是严格的“比例”,而是一个平滑、可正可负的缩放因子;但“一支决定另一支每一维的大小”这个结构没变。
4. 三张投影矩阵与 2/3 宽度
把门控放进 FFN,再接回降维矩阵,就是现代 LLM 的 FFN:
\[\operatorname{FFN}_{\mathrm{SwiGLU}}(x)=\bigl(\operatorname{SiLU}(xW)\odot xV\bigr)\,W_2\]普通 FFN 的两张矩阵(\(W_1\) 升维、\(W_2\) 降维)变成了三张:门投影 \(W\)、值投影 \(V\)、输出投影 \(W_2\)。本文前面表格里说的“三张矩阵”都指这三张。同三张矩阵在不同代码库里有不同名字:
| 本文记号(Shazeer 2020) | 作用 | 按功能命名 | Llama 官方代码 | Hugging Face |
|---|---|---|---|---|
| \(W\) | 门投影 | \(W_{\text{gate}}\) | w1 |
gate_proj |
| \(V\) | 值投影(升维) | \(W_{\text{up}}\) | w3 |
up_proj |
| \(W_2\) | 输出投影(降维) | \(W_{\text{down}}\) | w2 |
down_proj |
up / down 按的是宽度变化的方向:\(W_{\text{up}}\) 把 \(d\) 升到 \(d_g\),\(W_{\text{down}}\) 再降回 \(d\)。用 PyTorch 写只有几行:
class SwiGLUFFN(nn.Module):
    def __init__(self, d, d_g):
        super().__init__()
        self.gate = nn.Linear(d, d_g, bias=False)  # W:门投影,Llama 3 叫 w1,HF 叫 gate_proj
        self.up   = nn.Linear(d, d_g, bias=False)  # V:值投影,w3 / up_proj
        self.down = nn.Linear(d_g, d, bias=False)  # W2:输出投影,w2 / down_proj

    def forward(self, x):
        return self.down(F.silu(self.gate(x)) * self.up(x))
普通 FFN 的两张矩阵参数量约 \(2dd_{\mathrm{ff}}\);门控 FFN 约 \(3dd_g\)。令门控宽度 \(d_g \approx \frac{2}{3}d_{\mathrm{ff}}\),两者的主要矩阵参数量就接近。以 LLaMA-7B 为例,\(d=4096\),普通 FFN 取 \(d_{\mathrm{ff}}=4d=16384\),\(\frac{2}{3}\times16384\approx10923\),再向上取到 256 的倍数,就是配置里的 11008。
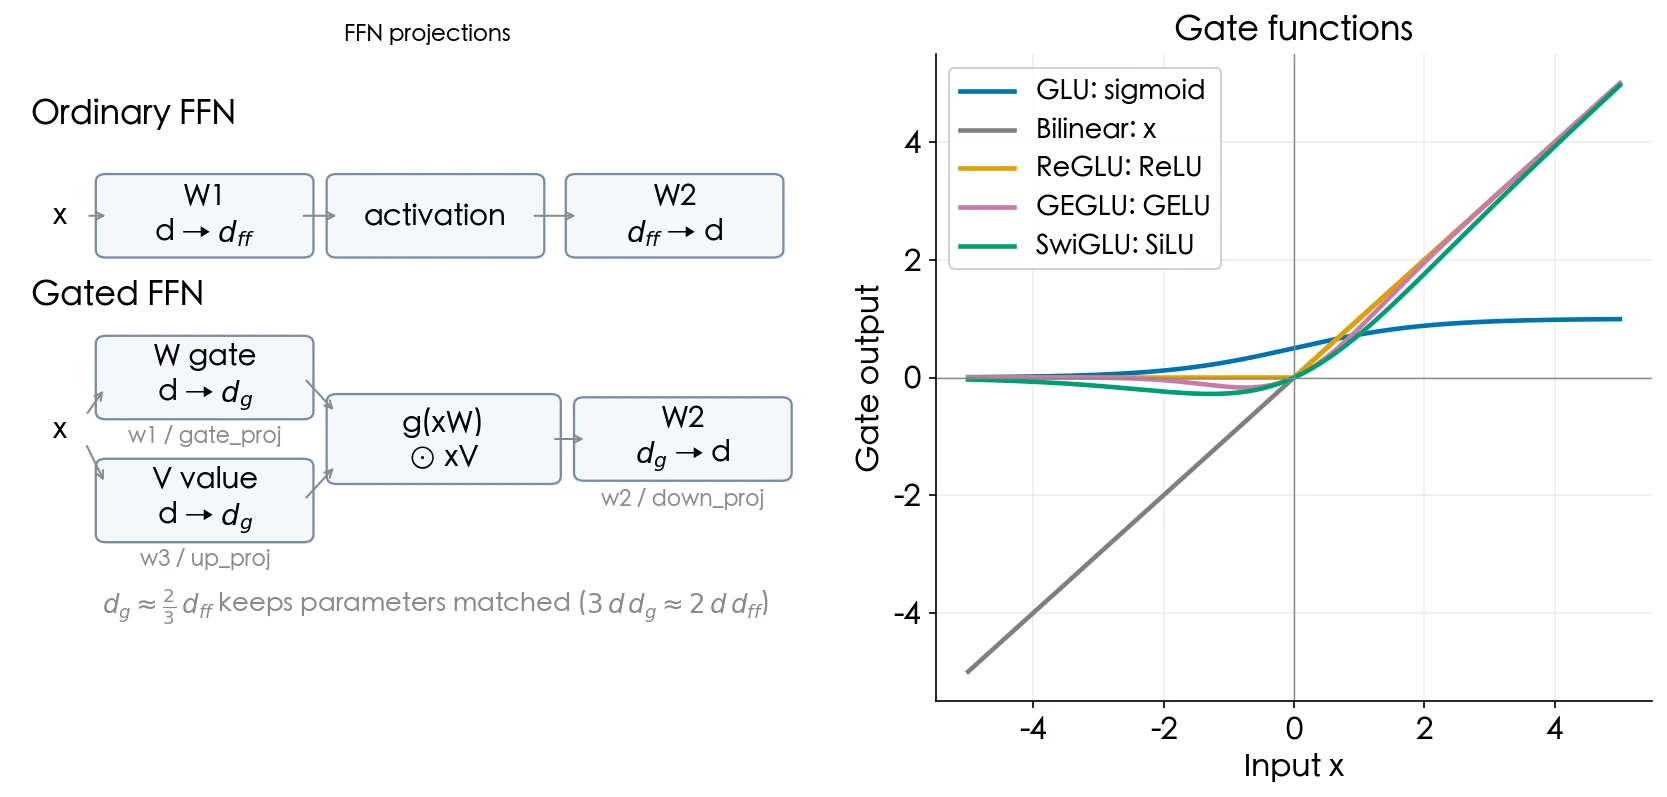
左图对照两种 FFN 的投影结构;右图是五种门函数的曲线。GLU 的 sigmoid 门饱和在 1,Bilinear 的门是一条直线,ReGLU、GEGLU、SwiGLU 在正半轴都近似 \(x\),差别集中在负半轴:ReLU 截成 0,GELU 和 SiLU 平滑地略低于 0。
模型例子能从论文和配置里交叉核对:Llama 3 的官方实现用 SiLU 门控,forward 写作 self.w2(F.silu(self.w1(x)) * self.w3(x));Qwen2.5 技术报告称其 dense 模型使用 SwiGLU,Hugging Face 配置的 hidden_act 为 silu。
PaLM 论文明确采用 SwiGLU,并说明 MLP 因此需要三张矩阵。Gemma 论文称其用 GeGLU。T5 v1.1 配置则把 feed_forward_proj 写作 gated-gelu。
为什么门控更好?Shazeer 的论文只给了实验结果,没有给理论解释。常见的直觉是乘法让 FFN 能表达输入特征之间的二阶交互(\(xW\) 与 \(xV\) 相乘),但这只是解释,不是证明。
这些结构的参数量与 FFN 宽度怎么算,见《现代 LLM 结构(01):从 GPT-2 到 Llama——五处改动与参数量》的「GELU 两矩阵 FFN → SwiGLU 三矩阵」。
七、成本与融合:算得少,不代表花时少
逐元素激活常是访存受限:对一个 BF16 元素,读输入 2 字节、写输出 2 字节;若只做几次算术,计算强度大约只有 1.25 FLOPs/byte。以 \([T,d_{\mathrm{ff}}]=[4096,11008]\) 为例,一次读写约 \(4096\times11008\times4 \approx 180\) MB,按每元素 5 次普通运算估算约 226 MFLOPs。
NVIDIA 的 H100 SXM 数据表列出 BF16 Tensor Core 峰值 1,979 TFLOPS,星号注明该数值使用 sparsity;dense 峰值约为一半,即 989 TFLOPS。除以 3.35 TB/s HBM 带宽,ridge point 约 \(989/3.35=295\) FLOPs/byte。逐元素激活约 1.25 FLOPs/byte,只有 ridge point 的 \(1/236\),说明它更可能受带宽限制。Roofline 的两条上限与 ridge point 见《现代 LLM 结构(02):前向的算量与访存量》「五、Roofline:把 FLOPs 和字节数放到同一张图上」的「算术强度与 ridge point」。
融合把相邻小算子合成一次 kernel,减少 launch 与中间张量读写。常见模式是 bias + GELU,以及 SwiGLU 里的 SiLU + multiply。细节见《GPU Kernel 工程(09):量化与融合 kernel——推理系统的其余部分》的「bias + activation 与 SiLU-and-mul」。
训练时还要反向求梯度,权重梯度需要前向输入,因此激活不能随算完即弃。《深度学习基础(03):反向传播——手推一个两层网络》的「激活为什么要存」解释了保存与 gradient checkpointing 的取舍。
八、常见激活函数对照
导数里的 \(\phi\)、\(\Phi\) 分别是标准正态密度与累积分布;门控行的 \(g\) 表示对应的 ReLU、GELU 或 SiLU。
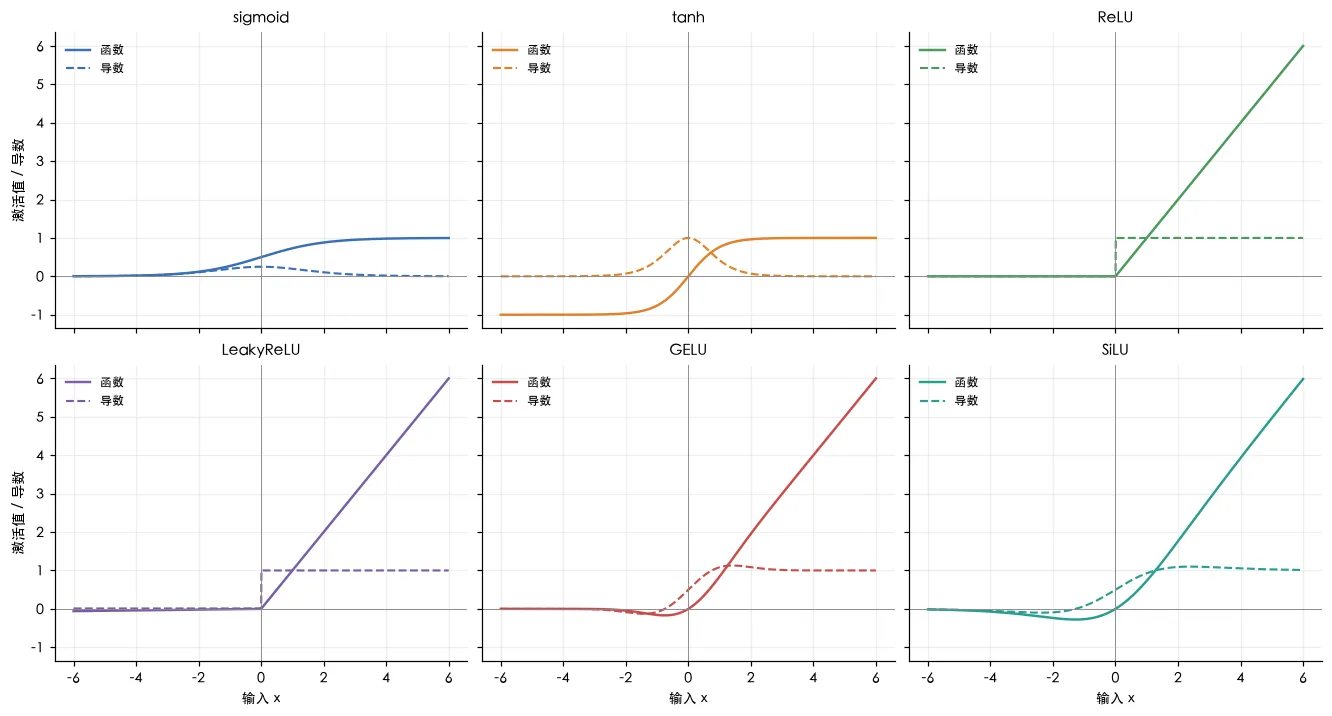
| 函数 | 公式 | 导数 | 值域 | 相对开销 | 代表模型 / 场景 |
|---|---|---|---|---|---|
| Sigmoid | \(\sigma(x)\) | \(\sigma(1-\sigma)\) | \((0,1)\) | 较高:exp | 平滑非线性基线 |
| tanh | \(\tanh(x)\) | \(1-\tanh^2(x)\) | \((-1,1)\) | 较高:exp | 零中心输出对照 |
| ReLU | \(\max(0,x)\) | \(\mathbf{1}_{x>0}\) | \([0,\infty)\) | 最低 | AlexNet |
| Leaky / PReLU | \(x\;(x>0),\;\alpha x\;(x<0)\) | \(1\;(x>0),\;\alpha\;(x<0)\) | \(\mathbb{R}\) | 低 |
|
| ELU | \(x\;(x>0),\;\alpha(e^x-1)\;(x\le0)\) | \(1\;(x>0),\;\alpha e^x\;(x\le0)\) | \((-\alpha,\infty)\) | 中:负侧 exp | — |
| GELU | \(x\Phi(x)\) | \(\Phi(x)+x\phi(x)\) | 约 \([-0.170,\infty)\) | 较高:CDF / tanh 近似 | GPT-2 |
| SiLU | \(x\sigma(x)\) | \(\sigma+x\sigma(1-\sigma)\) | 约 \([-0.278,\infty)\) | 中:sigmoid + 乘法 | SwiGLU 的门 |
| GLU | \(a\odot\sigma(b)\) | \(a'\sigma(b)+ab'\sigma'(b)\) | 取决于值分支 | 门 + 逐元素乘 | Dauphin 等(2016)的门控卷积语言模型 |
| Bilinear / ReGLU / GEGLU / SwiGLU | \(g(xW)\odot xV\) | \(J=W\,\operatorname{diag}(g'(xW)\odot xV)+V\,\operatorname{diag}(g(xW))\) | 取决于门函数与输入 | 三投影 + 门控乘法 |
|
表里的“相对开销”只比较激活与逐元素门控;大模型 FFN 的总耗时还取决于矩阵乘法、融合和硬件。
九、案例:六种激活函数跑同一个深层 MLP
三个随机种子都在 MNIST 上比较同一个 20 层、宽度 256 的 MLP。每种激活使用相同的 Kaiming-normal 初始化、Adam 学习率 \(10^{-3}\)、batch 128 和 250 个更新步;训练子集 12,000 张,测试准确率在标准 MNIST 测试集 10,000 张上计算。
初始梯度范数列保留种子 2026 的结果,取第一与第二十个隐藏 Linear 的权重梯度,在同一批 128 张样本上测量。准确率与 ReLU 死亡率报告三个种子的均值和范围。死亡率定义为:测试集前 1,024 张图中,对所有输入都输出 0 的隐藏单元占比。
| 激活 | 初始第一层梯度范数 | 初始第二十层梯度范数 | 测试准确率:均值[最小–最大] | ReLU 死亡率:均值[最小–最大] |
|---|---|---|---|---|
| sigmoid | \(3.944\times10^{-10}\) | \(1.010\) | 10.64%[10.28–11.35] | — |
| tanh | \(5.015\) | \(1.303\) | 90.48%[89.84–91.20] | — |
| ReLU | \(2.999\) | \(4.811\) | 91.88%[91.16–92.49] | 12.26%[11.41–13.22] |
| LeakyReLU | \(3.182\) | \(4.758\) | 92.02%[91.89–92.15] | — |
| GELU | \(2.722\) | \(1.452\) | 92.22%[91.87–92.48] | — |
| SiLU | \(1.752\) | \(0.9921\) | 92.88%[92.63–93.02] | — |
sigmoid 第一层的梯度只有 \(3.94\times10^{-10}\),第二十层仍约为 \(1.01\)。这是第二章所说导数连乘在训练里的直接表现:梯度传回输入端时几乎消失,准确率均值 10.64%,仍在十分类的随机水平附近。
tanh 的导数在 0 附近约为 1,输出也以 0 为中心;梯度没有像 sigmoid 那样一路缩小,因此这个固定预算下能训练到约 90%。
ReLU 即使用普通学习率 \(10^{-3}\),仍有平均 12.26% 的隐藏单元对这 1,024 张测试图都输出 0。这里的“死亡”是对整批输入都为零,不是某个样本上的稀疏激活。
ReLU、LeakyReLU 与 GELU 的准确率范围重叠,三次运行不足以区分它们。SiLU 的最低值 92.63% 比其他三者的最高值 92.49% 高 0.14 个百分点;这只说明在这组固定设置下超出了观察到的 seed spread,不足以推出普遍的激活函数排名。
一个单神经元例子能看到死亡如何发生:输入为 \([1,2]\),初始权重 \(w=2\)、偏置 \(b=0\)、目标均为 1。过大的 SGD 学习率把参数一步推到负侧;两个输入之后都落在 ReLU 的零梯度区,损失停在非零值。
| 量 | 更新前 | 更新后 |
|---|---|---|
| \(w\) | 2.00 | -2.20 |
| \(b\) | 0.00 | -2.40 |
| 预激活 \(wx+b\) | [2.00, 4.00] | [-4.60, -6.80] |
| 输出 \(\operatorname{ReLU}(wx+b)\) | [2.00, 4.00] | [0.00, 0.00] |
| loss \(\tfrac12\sum(y-1)^2\) | 5.00 | 1.00 |
| 梯度 \((\partial L/\partial w,\ \partial L/\partial b)\) | (7.00, 4.00) | (0, 0) |
十、本文小结
- 没有非线性时,深层线性 / 仿射层仍可折叠成一层;激活函数让网络真正增加表达能力。
- Sigmoid 与 tanh 会饱和;Sigmoid 的最大导数是 0.25,ReLU 正半轴导数为 1,但可能产生死亡单元。
- Leaky ReLU、PReLU、ELU 给负半轴留下梯度;GELU、SiLU 用平滑门控处理输入。
- SwiGLU 等 GLU 变体用门控分支控制值分支,增加一张输入投影矩阵;约 2/3 宽度可维持主要参数预算。
- 激活是低算术强度的逐元素操作,融合可省中间张量流量;反向所需的前向激活仍要保存或重算。
配套代码:case_activation_functions.py——生成曲线并复现六种激活的初始化梯度、三种子固定步数训练与死亡 ReLU 示例。
十一、自测
-
100 层 Linear 之间都没有激活函数时,为什么它们仍可折叠成一层?
答案
矩阵的乘积仍是一个矩阵;若有 bias,多层仿射变换的复合仍是仿射变换。层数增加了参数化方式,却没有增加非线性表达能力。
-
Sigmoid 的导数上限是多少?连续十层都乘这个上限,梯度约剩多少?
答案
\(\sigma'(x)=\sigma(x)(1-\sigma(x))\le0.25\);\(0.25^{10}=9.54\times10^{-7}\),约百万分之一。
-
ReLU 的稀疏激活与 dead ReLU 有什么区别?
答案
稀疏是某个样本上部分单元输出 0;死亡是某个单元对所有输入都输出 0,负半轴导数也为 0,因此不能从当前梯度中恢复。
-
GELU 与 SiLU 的公式分别是什么?它们在负半轴有什么共同点?
答案
GELU 是 \(x\Phi(x)\),SiLU 是 \(x\sigma(x)\)。两者都平滑,不像 ReLU 在零点折断;在一段负输入上函数值略低于 0。
-
SwiGLU 为什么比普通 FFN 多一张投影矩阵?为什么常把隐藏宽度降到约 2/3?
答案
它有门分支、值分支、输出投影三张矩阵;普通 FFN 是两张。令 \(3d d_g \approx 2d d_{\mathrm{ff}}\),得到 \(d_g\approx2d_{\mathrm{ff}}/3\),主要矩阵参数量就接近。
-
为什么融合 bias + GELU 或 SiLU + multiply 可能比单独优化激活函数更重要?
答案
逐元素激活读写量相对运算数大,常受显存带宽与 kernel launch 限制。融合减少中间张量写回与再次读取,也减少一次 launch。
下一篇
激活函数回答了层与层之间怎样引入非线性;接下来要让这些梯度在深网络里不消失、不爆炸。《深度学习基础(05):训练为什么不稳定——初始化、归一化与残差》从方差传播与 ReLU 的因子 2 开始。
-
多层线性变换的矩阵连乘仍是线性变换;加入 bias 后,仿射变换的复合仍然仿射。详见《深度学习基础(03):反向传播——手推一个两层网络》的「两层网络前向」。 ↩
-
Sigmoid / tanh 平滑但会饱和;ReLU 让正半轴梯度直通;GELU 与 SiLU 使用平滑门控;GLU 家族再用一个分支控制另一个分支。本文分别讨论它们的公式、梯度与代价。 ↩
系列 《深度学习基础:从反向传播到残差》 第 4 / 11 篇 入门
系列总览 — 为什么这样组织、读它需要什么、读完能做什么 · 幻灯片 — 整个系列的精华,一份可分享的 deck
学习地图 — AI 算法工程师学习地图 第 4 / 12 个系列
上一篇:反向传播——手推一个两层网络下一篇:训练为什么不稳定——初始化、归一化与残差
下一个系列:Transformer 原理与实现:从论文到手搓 GPT-2 进阶 · 5 篇,约 1.2 小时
本文由 arganzheng 创作,采用 CC BY 4.0 许可协议。在保留原文作者、署名以及完整原文链接(https://arganzheng.life/activation-functions-from-sigmoid-to-swiglu.html)的前提下,欢迎各种形式的转载、翻译或商业引用。
COMMENTS
评论存放在 GitHub Discussions, 用 GitHub 账号登录即可发表,支持 Markdown。 想针对正文某句话说?选中那段文字,点浮出的「评论」即可划线评论;觉得哪里写错了,发表时勾上「同时提交 Issue」。 有人回复你时 GitHub 会按你的通知设置发邮件,不用守在这里。