系列 《深度学习基础:从反向传播到残差》 第 1 / 10 篇 入门
下一篇:反向传播——手推一个两层网络
Transformer 不是突然出现的。它接过了感知机、反向传播、卷积、Embedding、循环网络与 attention 留下的问题。本篇沿时间线看这些结构为什么出现;公式推导和可复现实验放在后续文章。
为什么单层感知机会遇到 XOR?多层网络何时变得可训练?Transformer 又从哪些旧结构中继承了组件?
一、总览:三起两落
神经网络的发展不是平滑上升。感知机带来第一次热潮,能力边界、资金收缩与英国的研究评估共同构成第一次寒冬;反向传播带来第二次兴起,但算力、数据与训练稳定性仍有限;2006 年逐层预训练重燃深层网络研究,随后 GPU、ImageNet 与更可靠的训练方法让深度学习进入第三次兴起。
本文讲历史与动机;感知机、ADALINE 和 XOR 先用小例子建立直觉,反向传播、激活、初始化、优化器和各类结构的推导留给系列后续篇章。
时间线尾部的 GPT-3 来自 Brown 等人 2020 年的论文;ChatGPT 则在 2022 年由 OpenAI 面向公众发布。GPT-3 原论文;ChatGPT 发布说明
| 章 | 主题 | 要回答的问题 |
|---|---|---|
| 一 | 总览:三起两落 | 从 1943 到 2017 的演进时间线、三次兴起与两次寒冬;本文与系列各篇如何分工? |
| 二 | 理论前史(1943–1956) | 逻辑单元、联结学习与人工智能议程如何相遇? |
| 三 | 第一次兴起(1957–1969) | 感知机如何从实验室模型变成可训练机器? |
| 四 | 第一次寒冬(1969–1980) | 线性边界之外的问题是什么,寒冬又为何不能归因于一本书? |
| 五 | 第二次兴起(1980–1995) | 卷积、反向传播与循环网络分别加入了什么归纳偏置? |
| 六 | 第二次寒冬(1995–2006) | 为什么小数据时代的 SVM 更容易训练与分析? |
| 七 | 第三次兴起前夜(2006–2011) | 逐层预训练如何重燃深层网络,又遇到了什么替代方案? |
| 八 | 2012–2017:深度学习成为主流 | 大数据、GPU、共享结构与 attention 如何合流? |
| 九 | 对照表 | 这些结构沿时间先后交换了哪些假设? |
| 十 | 案例:感知机、ADALINE 与 MLP 跑 XOR | 实际训练和表示能力有什么区别? |
| 十一 | 本文小结 | 哪些历史结论值得带走? |
| 十二 | 自测 | 能否解释模型演进的关键转折? |
二、理论前史(1943–1956)
在电子计算机尚未成为日常研究工具时,神经科学家 Warren McCulloch 和数学家 Walter Pitts 先问了一个形式化问题:若把神经元简化成一个“输入达到门槛就放电”的单元,网络能否执行逻辑运算?他们在 1943 年给出二值阈值模型。单元对加权输入求和,超过阈值才输出 1;连接关系和阈值由设计者指定,模型本身没有学习规则。McCulloch–Pitts 原论文
把多个这样的单元按不同连接方式组合,可以构造 AND、OR、NOT 等逻辑功能。它的重要性不在于模拟了真实神经元的全部生理机制,而在于把“神经网络能计算什么”变成了一个可证明的问题。局限也同样清楚:如果权重是手工固定的,系统能否完成任务取决于设计者已经知道怎样连线。
Donald Hebb 在 1949 年的《The Organization of Behavior》中把问题从“网络能表示什么”推向“经验如何改变连接”。他的学习设想把神经元共同活动与突触连接的持久改变联系起来,为后来基于活动相关性的学习规则提供了概念起点。Hebb 原著书目与馆藏记录
1950 年,Alan Turing 没有试图给“思考”下一个抽象定义,而是提出模仿游戏:在文字问答条件下,观察者能否可靠地区分机器与人?这把问题变成了可讨论的行为判据。Turing 原文
六年后,Dartmouth 暑期研讨会提案把学习、语言、抽象与问题求解列成同一个研究计划。提案并不意味着当时已有通用智能机器;它的作用是把分散问题聚合成一个新研究议程。Dartmouth 原始提案
这段前史留下两种不同的工作:形式逻辑模型说明“可以表示”,学习理论追问“怎样从经验调整参数”。感知机把两者接了起来。
三、第一次兴起(1957–1969)
Rosenblatt 在康奈尔航空实验室工作的背景,是把模式识别从人工规定规则转向机器从样例中调整连接。1957 年的技术报告描述了 perceptron 方案;1958 年发表的论文进一步给出概率式的学习理论。Rosenblatt 1957 年报告;1958 年论文
Mark I Perceptron 不只是纸面上的方程。输入端是一块 photocell retina,光信号进入电路后,连接强度由电机驱动的电位器表示;训练时机器按照反馈改变这些电位器。它的硬件和今天的软件张量很不一样,但共同点是让权重成为能被数据修正的状态,而不是预先写死的逻辑连线。Mark I 操作手册(Cornell Aeronautical Laboratory,1960) 记录了这套视网膜输入与电位器机构。
对二值标签,令 \(\hat y\) 为预测、\(y\) 为目标,感知机把分类错误转换成一次有方向的参数更新:
\[w \leftarrow w+\eta(y-\hat y)x,\qquad b\leftarrow b+\eta(y-\hat y).\]更新仅由分类错误触发。Novikoff 后来给出了一个有条件的收敛界:若数据能被间隔 \(\gamma\) 的超平面线性分开,且输入范数不超过 \(R\),感知机误分类次数至多为 \((R/\gamma)^2\)。Novikoff 原论文 这不是“感知机总会收敛”:定理的前提已经排除了 XOR。
Widrow 与 Hoff 的 ADALINE(adaptive linear element)把训练目标放在阈值之前。模型先给出线性输出 \(z=w^\top x+b\),然后才把它变成类别或控制信号;学习则最小化连续输出与目标之间的平方误差。对这个平方误差做梯度下降得到 LMS(least mean squares)更新。Widrow–Hoff 原论文
两种更新规则的差异不只是换了一个名字:感知机看离散分类,犯错才动;ADALINE 看阈值前的数值误差,每一步都沿着梯度调整。线性输出与 LMS 后来成为自适应信号处理的重要工具,Widrow 等人的自适应噪声抵消工作展示了这条路线的应用。自适应噪声抵消原论文 MADALINE 则把多个 ADALINE 单元组合成更复杂的判别器;它增加了组合能力,却仍受早期训练规则与硬件规模限制。
纽约时报 1958 年 7 月 8 日的报道标题是 “New Navy Device Learns By Doing; Psychologist Shows Embryo of Computer Designed to Read and Grow Wiser”。它记录了当时对可学习机器的乐观想象;标题中的“embryo”也提醒我们,媒体报道并不等于机器已经具备通用视觉能力。《纽约时报》原报道
四、第一次寒冬(1969–1980)
XOR 是最小的反例。一个线性阈值单元若在 \(w_1x_1+w_2x_2+b>0\) 时输出 1,四个输入就要求:
\[b\le0,\quad w_1+b>0,\quad w_2+b>0,\quad w_1+w_2+b\le0.\]把中间两式相加,得到 \(w_1+w_2+2b>0\)。再用 \(b\le0\) 可推出 \(w_1+w_2+b>-b\ge0\),与最后一式矛盾;单个线性边界无法表示 XOR。
Minsky 与 Papert 1969 年的《Perceptrons》把感知机能力边界作为几何与计算问题系统分析,而非只给 XOR 一个反例。扩充版专章分别讨论 parity / one-in-a-box predicates 的阶数,以及标题就指出“unbounded order”的 ψ-connected 几何性质。原书扫描件;Parity 专章;ψ-connected 专章
研究热度转弱也不能归结为一本书。受限模型的能力与早期公开预期有差距,硬件与数据条件还不足以扩展规模;资助决策、研究议程和领域内部的竞争也共同作用。英国方面,Lighthill 1973 年报告及其公开讨论对当地 AI 研究资助产生了影响,但它不是所有国家、所有研究路线的唯一原因。Lighthill 原报告与讨论记录
这次低潮留下的真正问题不是“神经网络没有用”,而是怎样让模型同时具备非线性表达能力和可行的训练方法。
五、第二次兴起(1980–1995)
从视觉层级到可训练的深层网络
福岛邦彦的 Neocognitron 把视觉识别设计成层级结构:局部连接提取简单特征,后续层逐步组合它们。论文将其定位为对视觉皮层层级组织的模型;它没有依赖全连接层去记住每个像素组合。Neocognitron 原论文 这条局部感受野路线后来在 CNN 中变成了空间参数共享。
Hopfield 在 1982 年讨论带反馈连接的神经网络与物理系统之间的联系,把网络状态与能量函数关联起来;稳定状态可以作为联想记忆的候选答案。Hopfield 原论文 1985 年,Boltzmann machine 把随机状态和能量模型结合起来,让网络可以用概率分布表达多个可能解释。它的代价是学习需要处理模型分布与数据分布之间的统计差异,训练比一次前向计算昂贵得多。Ackley、Hinton 与 Sejnowski 原论文
真正让多层网络重新进入主线的,是隐藏层能不能被有效训练。Rumelhart、Hinton 与 Williams 1986 年的反向传播论文展示,误差信号可以从输出层沿计算图反向传播,逐层调整内部权重;多层网络因此不必再靠人工指定每个中间特征。Nature 原论文 梯度怎样逐层展开,放在《深度学习基础(02):反向传播——手推一个两层网络》推导。
1987 年 NETtalk 把英文拼写窗口映射到发音符号,展示了网络可以从例子中学到字母串与读音之间的分布式关系,而不是查一张手写发音规则表。NETtalk 原论文扫描件 结果既鼓舞人,也暴露了依赖上下文窗口、训练数据和有限计算资源的边界。
LeCun 等人把反向传播用于手写邮政编码识别:卷积核在空间位置之间共享,局部结构不必为每个像素位置另学一套参数。LeCun 等(1989)原文 视觉网络开始把结构先验写进连接方式中,而不是只靠扩大一个全连接 MLP。
表达能力、序列和梯度的距离
1989 年,Cybenko 证明带 sigmoid 的单隐藏层前馈网络在适当条件下可一致逼近紧集上的连续函数;Hornik、Stinchcombe 与 White 同年给出更一般的逼近结论。Cybenko 原论文;Hornik 等原论文 这里的要点是存在性:某个宽度的网络能够表示目标函数,并不等于训练算法一定找得到那组参数。
XOR 的显式构造只需要两个隐藏单元。令 \(H(z)=1\)(当 \(z\ge0\)),第一层用 OR 与 NAND:
\[h_1=H(x_1+x_2-0.5),\qquad h_2=H(-x_1-x_2+1.5),\]输出层再取二者的 AND:\(\hat y=H(h_1+h_2-1.5)\)。四种输入逐一代入即可得到 XOR。这个手工解说明“能表示”,还没有回答从随机初始化出发怎么“学会”。
Elman 1990 年的简单循环网络把上一时刻的隐藏状态复制到 context units,再作为当前时刻输入,让模型有短期序列记忆。Elman 原论文 对循环网络训练时,反向传播必须沿时间展开;Werbos 对通过时间的反向传播给出了系统讨论。BPTT 原论文
反向传播带来了更长的计算路径,也让梯度在多次连乘后可能变得极小。Hochreiter 1991 年的毕业论文分析了长程依赖训练中的梯度消失与爆炸;Bengio、Simard 与 Frasconi 1994 年进一步分析了长程依赖训练的困难。Hochreiter 1991 年论文;Bengio 等(1994)原论文 LSTM 后来用门控和记忆单元改善这个问题;它为信息提供了一条较容易保留的路径。Hochreiter 与 Schmidhuber(1997)原论文
LeNet-5 将卷积、子采样与分类层组织成可训练的手写文档识别系统,论文展示了用于银行支票上的数字识别。LeNet-5 原论文 这一时期的结构创新已经很丰富,但大规模数据、稳定训练和硬件吞吐还没同时到位。
六、第二次寒冬(1995–2006)
当视觉与语音数据仍以小型任务为主时,支持向量机给研究者一个更容易控制的选择。Cortes 与 Vapnik 的 SVM 用最大间隔分类;核函数把高维特征空间的内积写成原空间的计算,凸目标则让优化能到达全局最优解。SVM 原论文 小样本、手工特征和有限算力的组合,适合这种有明确目标函数与理论分析的路线。更多推导见《支持向量机与核方法》。
深层网络当时难在哪里?sigmoid 的饱和区会使局部导数很小,反向连乘后早期层收到的学习信号减弱;权重初始化的尺度也会影响信号在层间放大还是缩小。网络即使表达能力足够,优化器也未必能有效找到解。激活函数问题见《深度学习基础(03):激活函数——从 sigmoid 到 SwiGLU》;方差传播见《深度学习基础(04):训练为什么不稳定——初始化、归一化与残差》。
与此同时,手工特征、核方法、概率图模型和较小神经网络仍在解决具体问题。把 1995–2006 叫作“所有连接主义研究停止”并不准确;更准确的说法是,通用深层监督网络尚未成为主流工程工具。2004 年,Geoffrey Hinton 在 CIFAR 发起 Neural Computation and Adaptive Perception 项目,后续演变为 Learning in Machines & Brains;CIFAR 自己把这项支持描述为深度学习革命的早期催化因素。CIFAR 项目沿革
七、第三次兴起前夜(2006–2011)
2006 年,Hinton、Osindero 与 Teh 提出深度信念网络的贪心逐层训练:先逐层训练受限玻尔兹曼机,再把学到的参数作为整个深网的初始化。DBN 原论文 RBM 只有可见层和隐藏层两层,层间对称连接、层内无连接,是一种能量模型;对比散度是近似学习该模型的一种方法,这里不推导算法细节。对比散度原论文
同年,Hinton 与 Salakhutdinov 用深层自编码器做降维,并采用逐层预训练帮助优化;Bengio 等人比较了贪心无监督预训练与直接监督训练深网的差异。Science 原论文;Bengio 等原论文 “先预训练、再微调”因此重新进入实践。
这次复兴同时依赖多条基础设施变化。ImageNet 把大规模、按类别整理的图像数据带入视觉识别研究;其作者报告了跨越大量类别的图像数据库与组织方法。ImageNet 原论文 Raina、Madhavan 与 Ng 则把 GPU 用于扩大深度无监督模型:论文摘要报告 DBN 学习在大型模型上比双核 CPU 实现最多快 70 倍,并将一个四层、1 亿自由参数模型的训练时间从数周缩到约一天。ICML 2009 原论文 这些数字说明算力门槛开始移动,但还不能单独证明更深网络就能稳定训练。
ReLU 用 \(\max(0,x)\) 替代饱和的 sigmoid / tanh,在正半轴保留非零导数;Nair 与 Hinton 通过实验展示了它对深层特征学习的帮助。ReLU 原论文 Glorot 与 Bengio 提出按层的输入输出规模设定初始化方差,帮助信号尺度在前向和反向传播中保持得更稳定。原论文 这些改进没有消除深层训练的一切困难,却减少了“模型有表达能力、梯度却到不了前面”的概率。
八、2012–2017:深度学习成为主流
GPU 与 ImageNet:AlexNet 的组合拳
AlexNet 的关键不是单一新层,而是几件事在同一个系统里配合:深卷积网络、ReLU、大规模图像数据、GPU 卷积实现、数据增强和 dropout。Krizhevsky、Sutskever 与 Hinton 报告的模型有 6000 万参数,训练约 5–6 天,使用两块 GTX 580 3GB GPU;训练时使用随机裁剪与翻转等增强,并在全连接层使用 dropout。AlexNet 原论文
论文报告的 ILSVRC-2012 top-5 错误率是 15.3%,第二名为 26.2%。随后语音识别也出现深度网络的规模化结果,Hinton 等人总结了 DNN acoustic modeling 在语音识别中的进展。Hinton 等(2012)原文
结构分支:更深视觉、词向量与生成模型
2013 年的 Word2Vec 把“从上下文预测词”做成了简单而高效的词向量训练方法;它不是词向量研究的起点。Bengio 等人在 2003 年的神经概率语言模型已经把可学习的分布式词表示放进语言预测模型。Bengio 等(2003)原论文;Word2Vec 原论文 这些向量解决的是离散符号输入的表示问题;静态词向量仍让同一词型共享一个上下文无关的表项。细节见《深度学习基础(08):Embedding 与表示学习——从 one-hot 到上下文表示》。
2014 年,Sutskever 等人用编码器—解码器 RNN 处理序列到序列任务;Bahdanau 等人让解码器在每一步对输入状态加权,缓解把整句压进单个固定向量的瓶颈。seq2seq 原论文;Bahdanau attention 原论文 同年,Goodfellow 等人提出生成对抗网络,让生成器和判别器通过对抗目标共同训练。GAN 原论文
视觉网络也沿不同方向加深:VGG 用连续的小卷积核堆叠深度,GoogLeNet 用 Inception 模块组合不同尺度的卷积与池化。VGG 原论文;GoogLeNet 原论文 这些是 CNN 设计空间中的两种选择,不应被写成通向 Transformer 的必经单线。卷积到 ViT 的结构细节见《深度学习基础(07):CNN——从 LeNet 到 ResNet,再到 ViT》。
2015 年的 Batch Normalization 把小批量激活归一化并加入可学习的变换参数,作者报告它可加快训练并允许更高学习率。BN 原论文 同年的 ResNet 把输入通过恒等捷径加到残差变换上,使优化目标变成学习对输入的增量;论文的 ILSVRC-2015 网络最深达到 152 层,提交系统 top-5 错误率为 3.57%。ResNet 原论文
Transformer:把序列位置从串行计算中解放出来
循环网络每个时间步依赖前一状态,训练时难以在同一序列内部完全并行。2017 年,Vaswani 等人提出 Transformer:用 self-attention 直接连接序列中的位置,整个架构不再使用循环或卷积。Transformer 原论文
原论文报告 WMT14 英德任务达到 28.4 BLEU;英法任务的 big 模型达到 41.8 BLEU,并在 8 块 P100 上训练 3.5 天。它说明 attention-only 架构在翻译质量和训练并行度上都具有竞争力,不等于没有成本:标准全注意力仍随序列长度产生平方级计算与内存项。架构细节见《Transformer 原理与实现:从论文到手搓 GPT-2》系列总览。
九、对照表
| 模型 | 年份 | 结构假设 | 参数共享 | 并行度(训练时) | 典型任务 |
|---|---|---|---|---|---|
| McCulloch–Pitts 单元 | 1943 | 阈值逻辑、连接由人设定 | 由电路结构决定 | 高 | 逻辑计算 |
| Hebb 学习思想 | 1949 | 活动相关的连接改变 | 局部突触规则 | 高 | 联结学习 |
| 感知机 | 1957–1958 | 单个线性阈值边界 | 否 | 高 | 二分类 |
| ADALINE / MADALINE | 1960 | 线性输出与平方误差 | 单元间可组合 | 高 | 过滤、判别 |
| Neocognitron / CNN | 1980 起 | 局部感受野与层级特征 | 空间共享 | 高 | 视觉识别 |
| Hopfield / Boltzmann | 1982 / 1985 | 对称反馈、能量或概率状态 | 网络连接共享于状态演化 | 低至中 | 联想记忆、能量建模 |
| MLP / 反向传播 | 1986 | 全连接层与非线性组合 | 否 | 高 | 分类、回归 |
| RNN / LSTM | 1990 / 1997 | 循环状态和时间平移 | 时间共享 | 低,按步串行 | 序列建模 |
| SVM | 1995 | 最大间隔、核化相似度 | 不适用 | 中 | 小样本分类 |
| Embedding | 2003 / 2013 | 离散符号查表为向量 | 同一 token 共享一行 | 高 | 语言表示 |
| DBN / 深层自编码器 | 2006 | 逐层生成或重建 | 层内参数共享 | 中 | 无监督表示学习 |
| seq2seq + attention | 2014 | 状态序列与内容对齐 | 编码器 / 解码器内共享 | 部分并行 | 机器翻译 |
| GAN | 2014 | 生成器与判别器对抗 | 两个网络各自共享 | 中 | 数据生成 |
| ResNet | 2015 | 残差路径近似恒等映射 | 空间共享 | 高 | 大规模视觉识别 |
| Transformer | 2017 | 内容相关的全局注意力 | 位置间共享投影参数 | 序列位置并行 | 翻译、语言建模 |
为什么正文没有把每条结构都等量展开?本文重点追踪后来汇合到 Transformer 的一条主干:MLP 提供可学习的组合,CNN 加入局部性与空间共享,Embedding 提供离散符号的向量接口,RNN 与 attention 处理序列,Transformer 改变了序列计算的依赖方式。它不是整个深度学习谱系的完整目录。
生成分支另有自编码器 / VAE、GAN 与 diffusion;Hopfield 和 Boltzmann 属于能量模型方向;图神经网络则针对图上的邻接关系。这些方向会在总览时间线出现,但不强行塞进主线。VAE 的变分目标见 Kingma 与 Welling 的原论文,diffusion 的去噪生成见 Ho 等人的原论文;站内还可继续读扩散模型系列与多模态系列总览。GAN 在本文按 2014 年原论文定位,不展开其训练细节。VAE 原论文;DDPM 原论文
十、案例:感知机、ADALINE 与 MLP 跑 XOR
实验用 NumPy 固定数据顺序 (0,0),(0,1),(1,0),(1,1)。感知机从零权重和偏置开始、学习率 1,AND 在第 6 轮首次达到零误分;XOR 的每轮误分最少为 3,100 轮内没有零误分。脚本输出权重状态循环 (2, 1),表示第 2 轮首次重复、周期为 1。
ADALINE 用全批量梯度下降、学习率 0.1 训练 500 轮,最终权重为 (0.0000000207, 0.0000000207),偏置 0.4999999754,MSE 为 0.2500000000。最小二乘解为 w=(0,0), b=0.5,四个样本的预测全是 0.5。
两层 MLP 使用 tanh 隐藏层、sigmoid 输出、BCE、学习率 0.5,训练 5000 步。H=2 时 20 个种子有 13 个达到 100% 准确率,最终 BCE 中位数为 0.00130205、最大值为 0.34750613;H=4 时 20 个种子全部达到 100%,中位数为 0.00084360、最大值为 0.00103286。图中 H=4 使用 seed 0。
两层结构能表达 XOR,不意味着每个初始化都能学到它;H=2 的结果直接显示了表示能力与优化结果之间的差别。
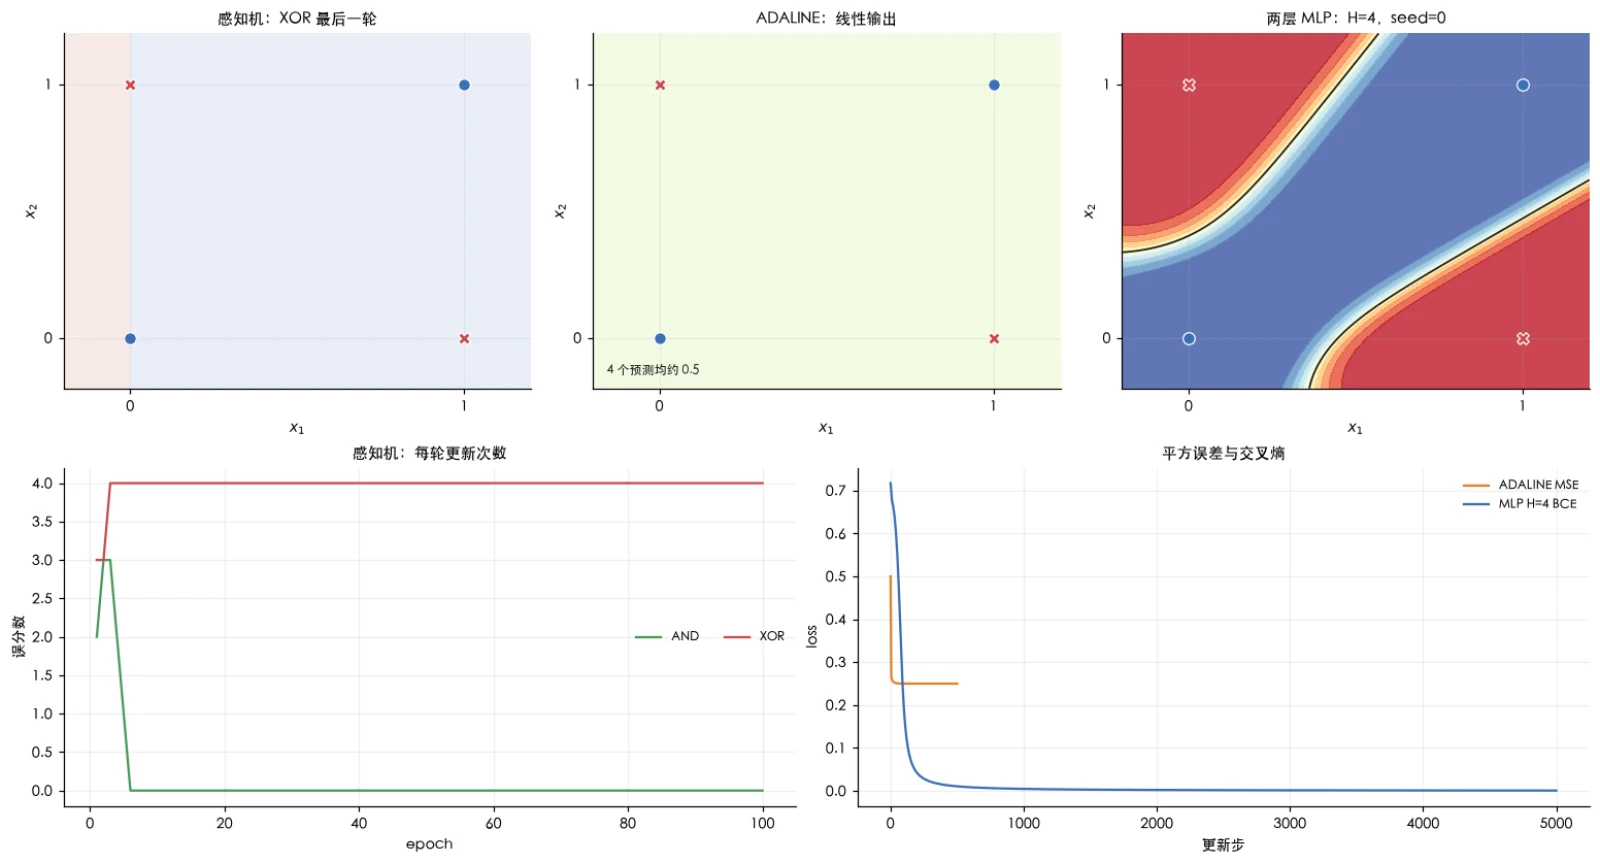
完整输出见 XOR 实验脚本。
十一、本文小结
- 理论模型先说明神经网络能表示逻辑,感知机和 ADALINE 再把“从样例调整权重”变成可运行的学习过程。
- XOR 暴露了单线性边界的表达限制;隐藏层解决表示问题,反向传播与初始化解决一部分优化问题。
- CNN、Embedding、RNN、attention、GAN 与 Transformer 是并行发展的结构分支,不是所有深度学习都通向同一终点。
- 每次兴起都依赖结构、数据、算法与算力共同到位;能表示 ≠ 能学会。
十二、自测
-
McCulloch–Pitts 单元、Hebb 学习思想和感知机分别解决了什么不同问题?
答案
McCulloch–Pitts 形式化阈值逻辑但不学习;Hebb 提出经验可改变连接的联结学习思想;感知机给出根据样例更新分类权重的规则。
-
感知机收敛界 \((R/\gamma)^2\) 有什么前提?为什么它不适用于 XOR?
答案
数据必须被间隔 \(\gamma\) 的超平面线性分开,且输入范数不超过 \(R\);XOR 不线性可分,因此不满足前提。
-
ADALINE 和感知机分别在哪个量上计算误差、何时更新?
答案
感知机看阈值后的类别,犯错才更新;ADALINE 看阈值前的线性输出与目标的平方误差,沿梯度更新。
-
两个隐藏单元怎样构造 XOR?这个构造没有证明什么?
答案
隐藏单元分别计算 OR 与 NAND,输出再做 AND;它证明表示能力,不证明随机初始化的梯度训练一定找到这组参数。
-
SVM 在第二次寒冬为何有吸引力?逐层预训练后来为何不再是常规做法?
答案
SVM 有凸目标、核技巧与间隔理论;ReLU、较好初始化、正则化、GPU 与大规模数据让端到端训练更可行。
-
AlexNet 与 Transformer 分别报告了哪些能说明规模变化的结果?
答案
AlexNet 的 ILSVRC-2012 top-5 错误率为 15.3%,第二名为 26.2%;Transformer 报告 WMT14 英德 28.4 BLEU,并在英法任务以 8 块 P100 训练 big 模型 3.5 天。
下一篇
下一篇是《深度学习基础(02):反向传播——手推一个两层网络》。
系列 《深度学习基础:从反向传播到残差》 第 1 / 10 篇 入门
下一篇:反向传播——手推一个两层网络
本文由 arganzheng 创作,采用 CC BY 4.0 许可协议。在保留原文作者、署名以及完整原文链接(https://arganzheng.life/evolution-of-deep-models-from-perceptron-to-transformer.html)的前提下,欢迎各种形式的转载、翻译或商业引用。
COMMENTS
评论存放在 GitHub Discussions, 用 GitHub 账号登录即可发表,支持 Markdown。 想针对正文某句话说?选中那段文字,点浮出的「评论」即可划线评论;觉得哪里写错了,发表时勾上「同时提交 Issue」。 有人回复你时 GitHub 会按你的通知设置发邮件,不用守在这里。