系列 《多模态:从视觉编码器到扩散模型》 第 7 / 10 篇 进阶
系列总览 — 为什么这样组织、读它需要什么、读完能做什么 · 幻灯片 — 整个系列的精华,一份可分享的 deck
学习地图 — AI 算法工程师学习地图 第 12 / 12 个系列
- 视觉编码器——CLIP、SigLIP 与自监督 ViT
- connector、注入方式与分辨率策略
- VLM 的训练:数据、阶段与评测
- 从波形到 token——mel 谱、Whisper 与神经 codec
- 语音理解、语音生成与全双工
- DDPM——加噪、去噪与「预测噪声」
- score matching、flow matching 与 classifier-free guidance
- Latent diffusion、DiT 与文生图配方
- 自回归图像生成与统一模型
- 系列总结与通关自测
上篇用 DDPM 的语言把扩散模型讲了一遍:加噪、猜噪声、逐步去噪、DDIM 跳步。这一篇讲另外两种看同一件事的方式——score matching(网络学的其实是”概率密度上升最快的方向”)与 flow matching(网络学的是”从噪声到数据的速度场”,SD3 与 FLUX 用的就是它)——它们的推导与记号完全不同,读起来像三个东西,实际上训练的是同一个网络、只是参数化不同;看清它们在哪一步汇合,读任何一篇扩散论文都不会再迷路。然后讲两个所有文生图模型都依赖的技术:噪声调度(哪些噪声水平该多学)与 classifier-free guidance(\(w = 7.5\) 到底在做什么)。
全篇继续用上篇那个二维的两个月牙 toy:分数场可以画成箭头图、flow matching 的轨迹可以画成线、CFG 的效果可以画成点——每个概念都有一张能看的图和一组能验算的数。
本篇要回答的核心问题是:
DDPM、score matching、flow matching 为什么是同一件事?1 CFG 的 \(w = 7.5\) 在数学上意味着什么?2
一、总览:三种视角、一个网络
上篇从 DDPM 出发,网络学的是加进去的噪声。这一篇换两个角度看同一个网络:score(分数)告诉我,往哪个方向移动会让当前样本更像数据;velocity(速度)告诉我,沿着一条从噪声到数据的路径该往哪走。classifier-free guidance(无分类器引导,CFG)则用 prompt 把这条去噪路径往条件样本的方向推。
1. 一张对照表
| 视角 | 提出 | 前向过程 | 网络学什么 | 训练损失 | 采样 |
|---|---|---|---|---|---|
| DDPM(去噪,上篇) | Sohl-Dickstein 2015;Ho 等 2020 | 离散 \(T\) 步高斯加噪的马尔可夫链 | 噪声 \(\epsilon_\theta(x_t, t)\) | \(\lVert \epsilon - \epsilon_\theta \rVert^2\)(ELBO 的简化) | \(T\) 步逐步去噪(随机);DDIM 确定性、可跳步 |
| Score SDE(分数) | Song 等 2021 | 连续时间 SDE \(dx = f\,dt + g\,dw\) | 分数 \(s_\theta(x_t, t) \approx \nabla_x \log p_t(x)\) | 去噪分数匹配 \(\lVert s_\theta - \nabla \log p_t(x_t \mid x_0) \rVert^2\) | 反向 SDE 或概率流 ODE,任意数值求解器 |
| Flow matching(流) | Lipman 等 2023;Liu 等 2023(rectified flow) | 直线插值 \(x_t = (1-t) x_0 + t\, \epsilon\) | 速度 \(v_\theta(x_t, t)\) | \(\lVert (\epsilon - x_0) - v_\theta \rVert^2\) | ODE \(dx/dt = v_\theta\),Euler 几十步 |
三行的网络输入都是(带噪样本,时间),输出都是一个与样本同形状的向量场。噪声 \(\epsilon\)、分数 \(s\)、速度 \(v\) 之间是线性变换(第三章给出公式)——训练其中一个就能算出另外两个。差别在:训练时对不同时间步的加权不同、采样时的路径不同(曲线 vs 直线)。
2. DDPM、score matching、flow matching 为什么是同一件事
三者在高斯加噪路径下是同一件事,因为它们都在学同一个对象——每个噪声水平 \(t\) 下带噪数据分布 \(p_t(x)\) 的分数 \(\nabla_x \log p_t(x)\)——的不同参数化。DDPM 学的噪声 \(\epsilon\) 与分数的关系是 \(s = -\epsilon / \sigma_t\)(Tweedie 公式的推论,第二章);flow matching 学的速度 \(v\) 是 \(\epsilon\) 与 \(x_0\) 的差,也可以用分数表达。三种损失在换元后只差一个与 \(t\) 有关的权重(一般 coupling / 非高斯路径的 flow matching 不在此列)。它们的采样都是解同一个概率流 ODE(或对应的 SDE),只是 flow matching 选择的前向过程让 ODE 的轨迹更容易拉直,因而少步数就够。
CFG 的 \(w = 7.5\) 意味着每一步用的分数被换成了 \((1-w)\,s_\emptyset + w\,s_c\)——在每个噪声水平上,它是”\(p_t(x \mid c)^{w} / p_t(x)^{w-1}\) 归一化”这个锐化分布的分数:条件 \(c\) 下比无条件更可能的区域被放大 \(w\) 次幂,其他区域被压掉。要说清一点:这个锐化是逐噪声层的,把每一层都锐化之后再一路采到 \(t = 0\),终点分布不等于把干净数据分布 \(p_0(x \mid c)\) 锐化——”先加噪再锐化”与”先锐化再加噪”不交换(第五章给一个一维高斯反例,Bradley & Nakkiran 2024 的结论)。”CFG 采样 \(p(x\mid c)^w/p(x)^{w-1}\)“是一个好用的直觉,不是采样定理。\(w = 1\) 是原条件分布;\(w = 7.5\) 让样本强烈偏向”最典型地符合 \(c\)“的模式——保真度与文本一致性上升、多样性下降、颜色饱和度过高(over-saturation)。它是一个有意的分布改变,与 《高效推理与压缩(01):解码策略、采样与约束生成》的低温采样是同类操作。第五章展开。
把输出换成分数或速度时,公式里会用到哪些量,容易一眼看混。我把上篇的噪声参数化、Tweedie 估计和直线路径的速度放在一张图里。一般的高斯路径写成 \(x_t = \alpha_t x_0 + \sigma_t \epsilon\);速度 \(v = \epsilon - x_0\) 则特指 flow matching 的线性路径 \(\alpha_t = 1-t,\ \sigma_t=t\)。
3. 本文的章节安排
本文按”换一种语言 → 再换一种语言 → 两个工程技术”组织:先把上篇的噪声预测器翻译成”分数”(第二章),再翻译成”速度场”(第三章),每次翻译都在 toy 上验证是同一个东西;然后讲调度(第四章)与 CFG(第五章)。
| 章 | 主题 | 内容 |
|---|---|---|
| 二 | score matching |
|
| 三 | flow matching |
|
| 四 | 噪声调度与时间步采样 |
|
| 五 | classifier-free guidance |
|
| 六 | 成本 |
|
| 七 | 动手(建议) | CIFAR-10 上 DDPM vs flow matching;配套代码 |
| 八 | 本文小结 | |
| 九 | 自测 | 7 道题 |
二、score matching:分数的视角
1. 分数
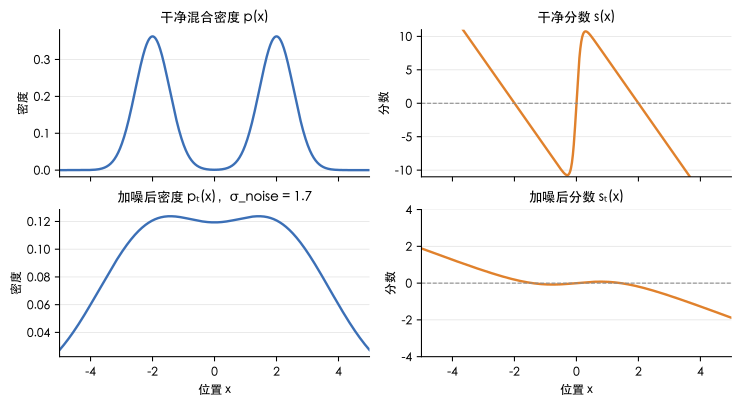
先看一维的分数。设数据来自两个高斯峰,一个在左、一个在右。\(p(x)\) 是这两个峰叠起来的密度;\(s(x) = \frac{d}{dx}\log p(x)\) 的正负号表示密度往哪边升高,绝对值表示升高得有多快。离峰很远时,箭头通常指向所在一侧最近的峰,离峰越远,分数的绝对值通常越大;到峰顶时,曲线斜率为零,分数也为零。两峰之间的谷底也是驻点,分数同样为零,但它是局部最小值,左右两侧的箭头会从谷底分别指向两边的峰。
图中的具体混合分布是:
\[p_0(x)=\frac{1}{2}\mathcal N(x;-2,0.55^2) +\frac{1}{2}\mathcal N(x;2,0.55^2)\]两个分量等权,峰分别在 \(-2\) 和 \(2\)。在左峰左边,例如 \(x=-3\),密度往右升,分数为正;在右峰右边,例如 \(x=3\),密度往左升,分数为负。两个峰顶和中间的谷底都给出零分数,但含义不同:峰顶是局部最大,谷底是局部最小。只看分数是否为零,不能判断一个点是不是高概率样本;还要看周围密度如何变化。
下方把这个分布再与标准差为 \(1.7\) 的高斯噪声卷积。每个峰会从标准差 \(0.55\) 展宽到 \(\sqrt{0.55^2+1.7^2}\),两个峰因此大幅重叠,谷底变浅。噪声并没有把数据变成另一种目标;它只是把原本稀疏、断开的区域填平,让附近的分数变化更连续。二维图里也能看到同一个过程:噪声大时箭头比较平滑,噪声小时才开始贴合月牙的轮廓。
更一般地,分布 \(p(x)\) 的分数写作 \(s(x)=\nabla_x\log p(x)\),也就是对数密度的梯度;梯度指向函数上升最快的方向(《LLM 时代的经典机器学习(03):逻辑回归与奖励模型——每个分类头的原型》)。到了二维,分数就是一个向量,每个位置都有一个箭头,箭头长度表示密度上升的快慢。上篇训好的 DDPM 模型可以直接画成这样的箭头图(第 2 节会说明为什么它就是分数):
怎么读:每个网格点画的是网络在那里算出的分数向量。噪声大(\(t = 600\))时,带噪分布接近一个大高斯,分数就是”指向原点”;噪声小(\(t = 80\))时,分数精确地指向月牙。采样就是顺着箭头走——知道分数就能采样:Langevin 动力学 \(x \leftarrow x + \frac{\delta}{2} \nabla_x \log p(x) + \sqrt{\delta}\, z\) 反复迭代收敛到 \(p\)。分数不需要归一化常数(\(\nabla \log(p / Z) = \nabla \log p\)),这是它相对于直接建模密度的优势。
直接估计干净数据的分数有个麻烦:图片大多落在很薄的低维流形附近,流形外的密度接近零,梯度既难从有限样本学出来,也可能数值不稳定。给数据加高斯噪声,相当于用高斯核把原分布平滑开:
\[p_\sigma(x) = \int p(x_0)\,\mathcal{N}(x; x_0, \sigma^2 I)\,dx_0\]平滑后,原来互不相连的高密度区域之间有了连续的过渡,分数在更大的空间范围内可估计。大噪声时,分数先告诉我数据大致在哪;噪声变小时,它再补上局部细节。反向采样每一步都要查询当前噪声水平的分数,所以网络要学一整族 \(p_t\) 的分数,而不是只学干净分布的一个向量场。这就是为什么分数匹配要把时间步或噪声尺度作为网络输入。
2. 去噪分数匹配
怎么学 \(\nabla_x \log p_\sigma(x)\)?训练数据给我一对干净样本和加噪样本,所以可以直接写出条件分布。沿用一般高斯路径 \(x_t = \alpha_t x_0 + \sigma_t \epsilon\),给定 \(x_0\) 后,\(x_t\) 是均值为 \(\alpha_t x_0\)、方差为 \(\sigma_t^2 I\) 的高斯。对这个高斯求分数只要对它的 log-density 求导:
\[\begin{aligned} \nabla_{x_t}\log p(x_t\mid x_0) &= -\frac{x_t-\alpha_t x_0}{\sigma_t^2} = -\frac{\epsilon}{\sigma_t},\\ \epsilon_\theta=-\sigma_t s_\theta &\quad\Longrightarrow\quad \mathcal L_{\rm DSM} = \mathbb E\left\lVert s_\theta+\frac{\epsilon}{\sigma_t}\right\rVert^2 = \mathbb E\frac{\lVert\epsilon_\theta-\epsilon\rVert^2}{\sigma_t^2}. \end{aligned}\]所以噪声目标就是条件高斯分数乘上 \(-\sigma_t\)。DSM 与噪声 MSE 还差一个随时间步变化的权重 \(1/\sigma_t^2\)。因此,DSM 与 DDPM 的 \(\epsilon\)-loss 目标可线性换算,各时间步的权重却不一定相同。Vincent 2011 的去噪分数匹配写成:
\[\mathbb{E}_{x_0, \tilde x \sim \mathcal{N}(x_0, \sigma^2 I)} \big\lVert s_\theta(\tilde x, \sigma) - \nabla_{\tilde x} \log \mathcal{N}(\tilde x; x_0, \sigma^2 I) \big\rVert^2\]即让网络匹配条件分布 \(p(\tilde x \mid x_0)\) 的分数。这个目标可计算,因为 \(x_0\) 是训练样本、噪声也是我们自己抽的。网络看见 \(\tilde x\) 时并不知道具体是哪一个 \(x_0\),所以 MSE 的最优输出是所有可能 \(x_0\) 对应条件分数的平均;对条件分布积分后,这个平均正好是边缘分布 \(p_\sigma\) 的分数。换句话说,训练时用的是已知的条件分数,学到的却是我们真正需要的带噪数据分数。回到加性噪声记号:
\[s_\theta(\tilde x, \sigma) \approx -\frac{\epsilon}{\sigma} \quad \Longleftrightarrow \quad \epsilon_\theta = -\sigma\, s_\theta\]去噪分数匹配就是噪声预测,差一个 \(-\sigma\) 的因子。DDPM 的 \(\epsilon_\theta\) 学的正是 \(-\sqrt{1 - \bar\alpha_t}\, \nabla_{x_t} \log p_t(x_t)\);若把 DSM 与噪声 MSE 直接比较,还要注意前面那项随 \(t\) 变化的权重。
3. Tweedie 公式
同一件事的另一种说法。Tweedie(Efron 2011):对高斯噪声污染的观测 \(\tilde x = x_0 + \sigma \epsilon\),
\[\mathbb{E}[x_0 \mid \tilde x] = \tilde x + \sigma^2 \nabla_{\tilde x} \log p_\sigma(\tilde x)\]后验均值等于观测加 \(\sigma^2\) 倍的分数——”最好的去噪结果 = 带噪点沿分数方向走 \(\sigma^2\) 那么远”。用 toy 验算(\(t = 300\),DDPM 的记号里 \(x_t = \sqrt{\bar\alpha_t} x_0 + \sigma_t \epsilon\),所以走完还要除以 \(\sqrt{\bar\alpha_t}\)):
在一般路径 \(x_t=\alpha_t x_0+\sigma_t\epsilon\) 下,对应的去噪估计是 \(\hat x_0=(x_t+\sigma_t^2 s_\theta)/\alpha_t\)。若网络预测噪声,代入 \(s_\theta=-\epsilon_\theta/\sigma_t\),就得到 \(\hat x_0=(x_t-\sigma_t\epsilon_\theta)/\alpha_t\)。这正是上篇 DDPM 采样循环里每一步用来估计干净图像的量;Tweedie 解释了这一步为什么能从分数算出来。
分母 \(\alpha_t\) 来自观测坐标的缩放。令 \(y=x_t/\alpha_t\),它就变成 \(y=x_0+(\sigma_t/\alpha_t)\epsilon\)。在 \(y\) 上套用加性高斯噪声的 Tweedie 公式,再用链式法则换回 \(x_t\):
\[\mathbb E[x_0\mid x_t] =y+\frac{\sigma_t^2}{\alpha_t^2}\nabla_y\log p_y(y) =\frac{x_t+\sigma_t^2\nabla_{x_t}\log p_t(x_t)}{\alpha_t}.\]如果 \(\alpha_t=1\),坐标没有缩放,这个结果就退回 \(\tilde x+\sigma^2s\)。在 DDPM 里,信号系数随时间变化,所以不能漏掉最后的除法。
真实 x_0 = [-0.45 -0.17],带噪 x_t = [ 0.81 -1.31],x_t + σ²·s 再除以 √ᾱ = [ 0.53 -0.85]
从 \((0.81, -1.31)\) 出发沿分数走一步到 \((0.53, -0.85)\)——朝 \(x_0\) 的方向去了,但没有到 \(x_0\):Tweedie 给的是后验均值,即”所有可能产生这个 \(x_t\) 的 \(x_0\) 的平均”,一个带噪点可能来自月牙上的一段而不是一个点,平均落在它们中间。这正是上篇 \(t = 50\) 的 MSE 降不到 0 的原因。它把三样东西连起来:去噪(估 \(\mathbb{E}[x_0 \mid \tilde x]\))、分数、噪声预测(\(\mathbb{E}[x_0 \mid \tilde x] = \tilde x - \sigma \mathbb{E}[\epsilon \mid \tilde x]\))。一个最优的去噪器自动给出分数,反之亦然。这是”为什么去噪等于学分布”的最短回答。
4. SDE 与概率流 ODE
Song 等 2021 把离散的加噪链推广为连续时间 SDE:
\[dx = f(x, t)\, dt + g(t)\, dw\]可以把它看成 DDPM 的连续极限:每一步变得无限小,漂移项 \(f\,dt\) 负责确定性的缩放,布朗运动增量 \(g\,dw\) 负责这一步新加的随机噪声。对 VP(variance preserving)路径,参数选成让信号与噪声总方差保持在同一尺度。
DDPM 对应 VP(variance preserving)SDE:\(f = -\frac{1}{2}\beta(t) x\),\(g = \sqrt{\beta(t)}\);Song & Ermon 的 NCSN 对应 VE(variance exploding)SDE。Anderson 1982 的结果:这个 SDE 有一个时间反向的 SDE
\[dx = \big[f(x, t) - g(t)^2 \nabla_x \log p_t(x)\big] dt + g(t)\, d\bar w\]沿反向时间从 \(x_T\sim p_T\) 积分到 \(x_0\) 时,漂移里多出一项由分数决定的修正;每一步还会继续抽新的布朗噪声 \(d\bar w\)。分数告诉反向漂移该往哪走,随机项则让同一个起点仍有多条可能轨迹。反向 SDE 只需要网络估计的分数,不需要知道真实密度本身。
更进一步,存在一个确定性的 ODE 与这个 SDE 有相同的边缘分布 \(p_t\):
\[\frac{dx}{dt} = f(x, t) - \frac{1}{2} g(t)^2 \nabla_x \log p_t(x)\]这是probability-flow ODE(概率流 ODE)。它没有每一步新抽的随机噪声;给定初始噪声和求解器,轨迹是确定的,但每个时刻的整体样本分布仍与反向 SDE 相同。DDIM 的 \(\eta=0\) 可以看作这一概率流的一种离散化。确定性轨迹可以交给数值 ODE 求解器,不限于固定步长的 Euler;Heun、DPM-Solver 等方法利用了更高阶信息或 ODE 结构,可能用更少的网络调用达到相近误差。
相同边缘分布不表示同一张图沿两种方法会走同一条路。反向 SDE 每一步都加入新随机量,同一初始点可以得到不同轨迹;ODE 没有这项噪声,同一起点和同一求解器对应确定的轨迹。Heun 这类高阶方法还可能在一个时间区间里多次查询网络,所以时间表上的“步数”不总等于实际前向次数。
用 ODE 采样时,我会按这个顺序做:
- 选求解器和一组时间点,例如 Euler、Heun 或 DPM-Solver。
- 从终端噪声分布抽一个 \(x_T\)。
- 每一步把当前 \(x_t,t\)(以及条件 \(c\))送进网络;若网络输出的是 \(\epsilon\) 或 \(v\),先换成求解器需要的分数或速度。
- 用求解器更新到下一个时间点,直到回到数据端。采样路径和少步数结果见第三章第 3 节。
至此三种视角汇合了两种:DDPM 的噪声预测 = 分数的负 \(\sigma\) 倍;DDPM 的采样 = 反向 SDE 的离散化;DDIM = 概率流 ODE 的离散化。
三、flow matching:直线的视角
1. 从 ODE 直接出发
既然采样最终是解一个 ODE \(dx/dt = v(x, t)\),为什么不直接学速度场 \(v\)?这是 flow matching(Lipman 等 2023)与 rectified flow(Liu 等 2023)的出发点。定义一条从数据 \(x_0\) 到噪声 \(x_1 = \epsilon\) 的路径(注意这里 \(t = 0\) 是数据、\(t = 1\) 是噪声,与 DDPM 的记号相反——这是 SD3 / FLUX 的约定),最简单的路径是直线:
\[x_t = (1 - t)\, x_0 + t\, \epsilon, \qquad \frac{dx_t}{dt} = \epsilon - x_0\]给定 \((x_0, \epsilon)\) 这一对,路径上每一点的速度是常数 \(\epsilon - x_0\)。条件流匹配的损失:
\[\mathcal{L}_{CFM} = \mathbb{E}_{t \sim U[0,1],\ x_0,\ \epsilon} \big\lVert v_\theta(x_t, t) - (\epsilon - x_0) \big\rVert^2\]读法:随机抽一个数据点 \(x_0\)、一个噪声点 \(\epsilon\)、一个时刻 \(t\),在两点连线的 \(t\) 处取 \(x_t\),让网络在 \((x_t, t)\) 输出这条线的方向 \(\epsilon - x_0\)。代码与上篇的 ddpm_loss 几乎一样,只是 \(x_t\) 的算法与目标换了:
def fm_loss(model, x0):
    t = torch.rand(len(x0))                                                    # ① t ~ U[0, 1](0 = 数据,1 = 噪声)
    eps = torch.randn_like(x0)
    xt = (1 - t)[:, None] * x0 + t[:, None] * eps                              # ② 直线插值
    return ((model(xt, t) - (eps - x0)) ** 2).mean()                           # ③ 让网络猜速度 ε − x_0

@torch.no_grad()
def euler_sample(model, n, steps):
    x = torch.randn(n, 2)
    for i in range(steps):
        t = 1 - i / steps
        x = x - model(x, torch.full((n,), t)) / steps                          # ④ 沿速度反方向走一小步:x_{t−Δ} = x_t − v·Δ
    return x
Lipman 等证明:这个只用”配对的条件速度”的损失,与匹配边缘速度场(把所有经过 \(x_t\) 的配对平均)的损失有相同的梯度——所以 \(v_\theta\) 学到的是边缘速度场,解 \(dx/dt = v_\theta\) 从 \(\epsilon\) 到 \(t = 0\) 就得到数据分布的样本。推导的结构与去噪分数匹配(条件分数的期望 = 边缘分数)完全平行。toy 上训 12000 步(loss 稳定在 1.17——这个数不会到 0:给定 \(x_t\),\(\epsilon - x_0\) 本身就有随机性,网络只能给出平均),Euler 20 步采样得到的点离真实数据 0.017——与上篇 DDPM 1000 步的 0.021 同量级。
2. 与 DDPM 的换算
直线路径 \(x_t = (1 - t) x_0 + t \epsilon\) 与 DDPM 的 \(x_t = \sqrt{\bar\alpha_t} x_0 + \sqrt{1 - \bar\alpha_t}\, \epsilon\) 是同一族(\(x_t = a_t x_0 + b_t \epsilon\))中的两个成员:DDPM 是方差保持(\(a_t^2 + b_t^2 = 1\),圆弧),flow matching 是 \(a_t + b_t = 1\)(直线)。在任何这样的路径上,\(\epsilon\)、\(x_0\)、分数 \(s\) 都由 \(x_t\) 与其中一个线性决定;速度是路径的时间导数 \(v = \dot a_t x_0 + \dot b_t \epsilon\)——只有直线路径(\(a_t = 1-t\)、\(b_t = t\))上才是 \(v = \epsilon - x_0\),方差保持的圆弧路径上 \(v\)-prediction 的 \(v = \sqrt{\bar\alpha_t}\,\epsilon - \sqrt{1-\bar\alpha_t}\,x_0\) 是另一个量(差一个角度导数因子):
\[\epsilon = x_t + (1 - t)\, v, \qquad x_0 = x_t - t\, v, \qquad s = -\frac{\epsilon}{t} = -\frac{x_t + (1-t) v}{t}\]前两项可以直接从线性路径解出来。把 \(\epsilon=x_0+v\) 代入 \(x_t=(1-t)x_0+t\epsilon\),得到 \(x_t=x_0+tv\),所以 \(x_0=x_t-tv\);再代回 \(\epsilon=x_0+v\),就是 \(\epsilon=x_t+(1-t)v\)。分数关系随后由 \(s=-\epsilon/\sigma_t\) 和 \(\sigma_t=t\) 得到。
(直线路径下 \(\sigma_t = t\)。)所以 flow matching 的 \(v\)-预测与 DDPM 的 \(\epsilon\)-预测学的是同一个信息,训练损失只差一个与 \(t\) 有关的权重(\(\lVert v - v_\theta \rVert^2 = \lVert \epsilon - \epsilon_\theta \rVert^2 / (1-t)^2\) 一类)。Kingma & Gao 2023 把这些损失统一成”加权的 ELBO”——在高斯路径(\(x_t = a_t x_0 + b_t \epsilon\)、噪声与数据独立配对)这个前提下,不同方法的差别归结为对不同噪声水平的加权、坐标 / 时间的重参数化与端点的选择。前提要记住:一般的 flow matching 允许非高斯路径与非独立 coupling(例如 OT 配对的 reflow),那些不在”同一个分数的不同参数化”之列。这是核心问题前半的答案。
3. 为什么直线让步数少
采样是解 ODE。ODE 的轨迹越直,Euler 法一步走得越远、误差越小——一条直线一步就能走完,一条弯路必须分很多小段。flow matching 的条件路径是直线,但边缘速度场(多条直线的平均)不一定直——训练时 \(x_0\) 与 \(\epsilon\) 是随机配对的,两条相交的直线在交点处方向不同,网络只能输出它们的平均,轨迹就在那里拐弯。toy 上把 12 个噪声起点的轨迹画出来,用”弦长 / 路径长”量直线度(1 = 完全直):
同一批 12 个噪声起点:DDIM(DDPM 模型)轨迹的直线度 0.74,flow matching 轨迹 0.49(1 = 完全直)
flow matching 的轨迹比 DDIM 的还弯——随机配对的代价。Rectified flow 的 reflow 操作修的就是它:用训好的模型从噪声生成样本,得到新的 \((\epsilon, x_0)\) 配对——它们由 ODE 轨迹连接、彼此不相交——在这些固定的配对上重训一轮:
reflow 一轮后同一批起点的轨迹直线度 1.00
直线度直接换成采样步数。三个模型(DDPM 用 DDIM 采样、flow matching 用 Euler、reflow 后用 Euler)在 1 / 2 / 5 / 20 步下:
| 步数 | DDIM | flow matching | flow matching + reflow |
|---|---|---|---|
| 1 | 3.715(散成一片) | 0.290(缩成一个点) | 0.030 |
| 2 | 0.168 | 0.112 | 0.025 |
| 5 | 0.099 | 0.041 | 0.023 |
| 20 | 0.033 | 0.017 | 0.020 |
reflow 后一步就生成出两个月牙(0.030),而 DDIM 一步是灾难、flow matching 一步全缩到均值——这就是”轨迹直 = 步数少”的全部含义。每轮 reflow 让边缘轨迹更直,几轮后可以 1–2 步采样。SD3 与 FLUX 没有做 reflow,但直线参数化本身已经让它们在 20–30 步达到 DDPM 50 步的质量(上表 5 步一列:0.041 vs 0.099),且更容易做后续的步数蒸馏(下一篇)。
另一个实用的好处:直线路径下 \(t\) 的语义直接——\(t = 0.5\) 就是”一半数据一半噪声”——调度设计更直观(第四章)。
步数很少时,积分器只在少数位置观察速度场。长时间间隔中的轨迹弯曲和局部误差来不及修正。增加步数通常会改善数值积分,但网络调用也会线性增加。reflow 从训练阶段降低轨迹弯曲;蒸馏直接训练少步学生。
四、噪声调度与时间步采样
1. 调度决定”什么噪声水平被学得多”
调度是 \(t \mapsto (a_t, b_t)\)(\(x_t = a_t x_0 + b_t \epsilon\) 里信号与噪声的系数)或等价地 \(t \mapsto \text{SNR}(t) = a_t^2 / b_t^2\)(信噪比)。它与训练时 \(t\) 的采样分布一起决定每个噪声水平在训练里出现的频率——即网络在哪些噪声水平上学得好。
- DDPM linear(\(\beta_t\) 线性):SNR 在中间下降太快,很多步浪费在几乎纯噪声的区域。
- cosine(Nichol & Dhariwal 2021):\(\bar\alpha_t = \cos^2(\frac{t/T + s}{1 + s} \cdot \frac{\pi}{2})\),SNR 下降更均匀,在小数据集上提升明显。
- 零终端 SNR(Lin 等 2024):Stable Diffusion 的 scaled-linear 调度(\(\beta\) 从 \(0.00085\) 到 \(0.012\) 按 \(\sqrt{\beta}\) 线性)在 \(t = T\) 处 \(\bar\alpha_T \approx 0.0047 \ne 0\)(DDPM 原版 linear \(10^{-4} \to 0.02\) 是 \(4 \times 10^{-5}\),两个调度别混)——训练时最噪的样本仍含一点信号,但采样从纯噪声开始,训练与采样不一致;表现是生成的图片平均亮度总是中等(不能生成很暗或很亮的图)。修正:把调度缩放到 \(\bar\alpha_T = 0\),改用 \(v\)-prediction——在 \(\bar\alpha_T = 0\) 处 \(x_T = \epsilon\),\(\epsilon\) 目标仍有定义但等于输入本身、从它换算 \(x_0\) 要除以 0,网络学不到任何东西;\(x_0\)-prediction 也能用,\(v\) 是在两端都表现好的选择——采样从真正的纯噪声开始。
- EDM(Karras 等 2022):在 \(\sigma\) 空间用对数正态分布采样噪声水平,配合网络输入输出的预处理(preconditioning),是很多后续工作的调度基线。
2. 时间步采样:logit-normal
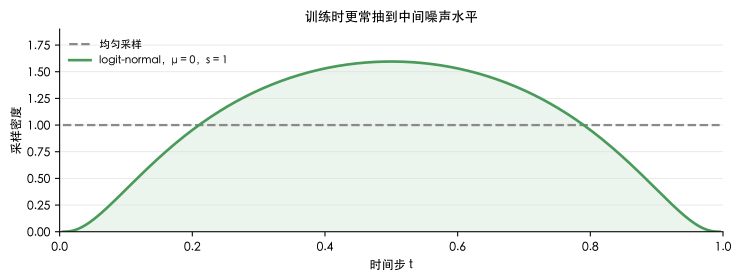
flow matching 的 \(t\sim U[0,1]\) 会让每个等宽时间区间被抽到的概率相同。logit-normal 先抽一个正态数,再用 sigmoid 把它压到 \(0\) 和 \(1\) 之间:
\[u\sim\mathcal N(\mu,s^2),\qquad t=\operatorname{sigmoid}(u),\qquad p(t)=\frac{1}{s\,t(1-t)}\, \phi\!\left(\frac{\operatorname{logit}(t)-\mu}{s}\right)\]这里的 \(p(t)\) 是变量变换后的密度,因子 \(1/[t(1-t)]\) 是 Jacobian。以 \(\mu=0,s=1\) 为例,密度在 \(t=0.5\) 附近高于均匀分布,在两端更低。中间的样本同时保留结构和噪声,模型要判断哪些结构该留下、哪些噪声该去掉。SD3 在 rectified-flow 训练中报告了这种采样优于均匀采样和若干备选方案(Esser 等,2024,SD3 论文)。
参数 \(\mu\) 移动 log-odds 时间里的采样重心,\(s\) 控制分布宽度。\(\mu=0\) 时,密度关于 \(0.5\) 对称。减小 \(s\) 会把抽样集中到中段,增大 \(s\) 会提高两端的概率。靠近数据端时,输入接近干净样本;靠近噪声端时,结构很弱。中段同时保留结构和噪声,模型要分辨两者各自的贡献。
3. 分辨率与调度的耦合
图像分辨率变高时,新增像素不等于新增独立信息。相邻像素和 latent patch 往往相关,局部轮廓、颜色块会跨多个位置延续。我用这个现象理解调度 shift:相同时间步在高分辨率输入里可能留下更多可利用的空间结构。
SD3 的做法是按分辨率平移时间步:
\[t_{\rm new}=\frac{\alpha t}{1+(\alpha-1)t},\qquad \alpha=\sqrt{m/n}\]\(m,n\) 分别是目标与基准分辨率的 token 数。以 \(256^2\) 到 \(1024^2\) 为例,token 数比是 \(16\),公式给出 \(\alpha=4\)。当 \(\alpha>1\) 时,中间时间点会移向更大的 \(t\),在线性 flow path 上也就是更多噪声。SD3 根据人评结果采用 \(\alpha=3\)。FLUX 也使用分辨率相关的 shift,并在采样时动态调整。更早的 Simple Diffusion(Hoogeboom 等,2023)研究了同类的高分辨率调度缩放。分辨率改变后,训练和采样使用的噪声时间分布也要重新校准。
代入基准时间 \(t=0.5\)、\(\alpha=4\),得到 \(t_{\rm new}=0.8\)。在线性路径上,同一索引对应更靠近噪声端的样本。高分辨率输入的局部相关性可能让相同强度的噪声仍留下更多轮廓,因此有些配方会把时间步往噪声端平移。
五、classifier-free guidance
1. 从 classifier guidance 到 classifier-free
条件生成要采样 \(p(x \mid c)\)(\(c\) 是文本)。贝叶斯:\(\nabla_x \log p(x \mid c) = \nabla_x \log p(x) + \nabla_x \log p(c \mid x)\)——条件分数 = 无条件分数 + 分类器的梯度。Dhariwal & Nichol 2021 的 classifier guidance:训一个在带噪图片上的分类器 \(p_\phi(c \mid x_t)\),采样时把它的梯度放大 \(w\) 倍加到分数上:\(\tilde s = s + w \nabla \log p_\phi(c \mid x_t)\)。\(w > 1\) 让样本更”像 \(c\)“,FID 显著改善。缺点是要额外训一个能看噪声图的分类器。
classifier-free guidance(Ho & Salimans 2022):不训分类器,而是让同一个扩散模型同时学条件与无条件——训练时以 10–20% 的概率把 \(c\) 替换为空条件 \(\emptyset\)(条件 dropout)。采样时两次前向:
\[\tilde\epsilon_\theta(x_t, c) = \epsilon_\theta(x_t, \emptyset) + w \big(\epsilon_\theta(x_t, c) - \epsilon_\theta(x_t, \emptyset)\big)\]推导:由贝叶斯 \(\nabla \log p(c \mid x) = \nabla \log p(x \mid c) - \nabla \log p(x)\),用两个分数的差替代分类器梯度,代入 classifier guidance 的公式:\(\tilde s = s_\emptyset + w(s_c - s_\emptyset)\),再用 \(\epsilon = -\sigma s\) 换成噪声。\(w = 1\) 是纯条件采样;\(w = 0\) 是无条件;\(w > 1\) 是外推——沿”从无条件指向有条件”的方向走过头。
在 toy 上做一遍:条件 \(c\) 是”上面的月牙 / 下面的月牙”(两类),训练时 15% 的样本把 \(c\) 换成 \(\emptyset\),采样时每步两次前向:
c = torch.where(torch.rand(len(y)) < 0.15, torch.full_like(y, 2), y)          # 训练:15% 的概率把条件换成 ∅(编号 2)

v_c, v_0 = model(x, t, cc), model(x, t, nul)                                  # 采样:有条件、无条件各算一次
v = v_0 + w * (v_c - v_0)                                                      # CFG:沿「有条件 − 无条件」的方向外推 w 倍
指定”类 0”,扫 \(w\):
w = 0:条件「类 0」的 1500 个样本里落在类 0 一侧的 59.9%,样本坐标的标准差 0.827
w = 1:95.1%,标准差 0.602
w = 2:99.6%,标准差 0.459
w = 4:100.0%,标准差 0.354
w = 8:100.0%,标准差 0.417
\(w = 0\) 时是无条件采样,两个月牙各占一半。\(w = 1\) 时是纯条件采样,95% 落在目标月牙,5% 落错边。\(w = 2\) 时几乎全对,仍覆盖整条弧。\(w = 4\) 时样本挤到月牙中段,多样性开始下降(标准差 0.60 → 0.35)。\(w = 8\) 时样本被推到数据之外,甩出离群点。文生图里的过饱和也是这种外推过头:样本落到训练分布之外。
2. 它在采样什么分布
把 \(\tilde s = (1 - w) s_\emptyset + w\, s_c\) 看成某个分布的分数:
\[\tilde p(x \mid c) \propto p(x)^{1 - w}\, p(x \mid c)^{w} = p(x) \left(\frac{p(x \mid c)}{p(x)}\right)^{w} \propto p(x)\, p(c \mid x)^{w}\]即 \(p(x \mid c)^w / p(x)^{w-1}\) 归一化——在每一个噪声水平 \(t\) 上。\(w = 7.5\)(SD 1.x 的默认)意味着分类器项 \(p_t(c \mid x_t)\) 被升到 7.5 次幂:一个区域在条件下比无条件下可能 2 倍,被放大到 \(2^{7.5} \approx 180\) 倍;可能 0.5 倍的区域被压到 \(1/180\)。每一层都被锐化到”最典型地符合 \(c\)“的模式上。它与 《高效推理与压缩(01):解码策略、采样与约束生成》的低温采样是同一类操作(温度 \(1/w\) 作用在 \(p(c \mid x)\) 上),带来同样的权衡:保真度与一致性上升、多样性下降。
但这里有一个很多教程都写错的地方:逐层锐化之后采到底,终点不是 \(p_0(x\mid c)^w / p_0(x)^{w-1}\)。原因是”锐化”与”加噪”不交换——先把干净分布锐化再加噪,与先加噪再锐化每一层,得到的不是同一族分布,而 CFG 做的是后者。一维高斯就能看出来(CPU 验证):无条件 \(p_0 = \mathcal N(0, 4)\)、有条件 \(p_0^c = \mathcal N(0, 1)\)、\(w = 2\)。若终点真是幂分布,方差应为 \(1/(2/1 - 1/4) = 4/7 \approx 0.571\);而用精确分数(不是网络近似)跑 CFG 的概率流 ODE,终点方差是 \(1/4\)——差了两倍多。所以”采样幂分布”只对每个噪声层成立、对最终样本是一个近似直觉,且即便分数完全精确也不成立(Bradley & Nakkiran 2024 对 DDPM / DDIM 都给了证明);网络不精确只是第二层误差。实践中 \(w\) 的效果——更贴 prompt、更少样、过饱和——是经验事实,不依赖这个错误的”定理”。
3. 副作用与修正
\(w\) 越大,条件方向的外推越远。文生图里,颜色会过浓,亮部或暗部会被压死。局部对比也会变强。继续增大时,物体边缘可能出现光晕或不自然纹理,画面也会偏向训练分布外的“典型 prompt 样本”。同一个 prompt 换随机种子后,构图和细节也可能趋同。
- 过饱和与过曝:\(w\) 大时,\(\tilde\epsilon\) 的范数可能超出训练分布。反复更新会让预测的 \(\hat x_0\) 越出合理像素范围,造成颜色饱和、对比过强。动态阈值(Imagen)在每一步按 \(\hat x_0\) 绝对值的高分位数确定缩放范围。它先裁剪极端值,再缩回正常区间,避免少数值拉坏整张图的亮度范围。CFG rescale(Lin 等,2024)比较 guided 与 conditional 噪声预测的标准差,再把前者缩回后者附近,保留引导方向并限制幅度。
- 多样性坍缩:同一 prompt 的种子更容易收敛到类似构图,细节变化变少。区间 guidance(Kynkäänniemi 等,2024)只在中间噪声区间使用较强 guidance,两端退回 \(w=1\)。这样,大噪声阶段能留下更多整体布局;小噪声阶段也不容易把局部纹理反复推向同一种样式。自适应 \(w\) 根据时间步或当前预测幅度逐步调小 guidance,避免固定的大权重从头到尾作用在采样上。
- 两倍成本:常规 CFG 每步分别计算条件和无条件预测。CFG 蒸馏(Meng 等,2023)用教师的两次预测训练学生。学生一次前向就能近似 \(\tilde\epsilon\),并把 \(w\) 作为输入条件。FLUX.1-dev 与 schnell 都使用 guidance distillation,推理时只需一次前向。
- 负 prompt:把空条件 \(\emptyset\) 换成一段“不想要的描述”\(c^-\),\(\tilde\epsilon = \epsilon(c^-) + w(\epsilon(c) - \epsilon(c^-))\)。这样模型沿着远离负 prompt、靠近正 prompt 的方向外推;它并不是从结果里逐字删除负 prompt 提到的物体,也不能保证绝对排除它们。
4. guidance scale 的典型值
SD 1.x / 2.x:7.5;SDXL:5–7;SD3:3.5–7(rectified flow 下常用的 \(w\) 较小);FLUX.1-dev(蒸馏):3.5;Imagen:使用动态阈值时可到 10+。这些数是各模型家族的经验起点;不同实现的 \(w\) 定义和采样配置有差异,数值不能直接横向比较。
六、成本
1. 训练
每个训练样本一次前向 + 反向,在一个随机的 \(t\) 上。网络是 U-Net 或 DiT(下一篇),一次前向的 FLOPs 由输入的空间尺寸决定:SD 1.5 的 U-Net(860M)在 \(64^2 \times 4\) 的 latent 上约 0.8 TFLOPs 前向;DiT-XL/2(675M)在 \(32^2 \times 4\)(\(256^2\) 图)上约 0.12 TFLOPs,在 \(64^2\)(\(512^2\))上约 0.5。训练 SD 1.5 的公开数字:约 15 万 A100 小时(LAION-2B 子集,几个 epoch);DiT-XL/2 \(256^2\) 7M 步 × batch 256 = 18 亿样本。扩散模型每个样本只在一个 \(t\) 上算——比语言模型”每个 token 都算 loss”的样本效率低,需要更多 epoch。
2. 采样
先把网络的一次前向记成 \(F\),采样器实际调用网络 \(N\) 次,那么不带 CFG 的采样量约为 \(N F\)。每一步普通 CFG 要得到有条件和无条件两个预测,约为 \(2NF\);有些实现把两份输入沿 batch 维拼起来,一次调用 U-Net,但 batch 变成两倍,计算量仍大致相同,只是可能少一些调用开销。批处理不会把两份预测变成一次预测。
所以一张图的主要成本可以先粗算成:
\[\text{采样 FLOPs}\ \approx\ \text{采样步数}\times \begin{cases} 1 & \text{无 CFG 或已蒸馏}\\ 2 & \text{每步常规 CFG} \end{cases} \times F\]实际估算时,我会数网络被查询几次,而不是只数时间表上有几个点。Euler 通常每个区间查一次;Heun 这类高阶方法可能在区间内多查一次来修正方向。CFG 又让每次查询包含条件和无条件两份输入。把两份输入拼成 batch=2 可以减少调用开销,但模型仍要算两份数据,FLOPs 不会因此减半。硬件利用率会影响真实耗时,所以这个公式适合做同配置下的成本比较,不等于精确秒数。
SD 1.5:50 步 × 2 × 0.8 = 80 TFLOPs,A100 上约 2–3 秒;SDXL(2.6B U-Net,\(128^2\) latent):约 5 倍。若换用 guidance distillation,可以省掉每步第二份预测;少步蒸馏和更高阶 ODE solver 则减少网络调用次数。这两种优化分别减少“每步算几次”和“总共走几步”,细节留给后续的蒸馏章节。
与 LLM 对比:生成 1000 个 token 的 7B LLM 是 \(2 \times 7B \times 1000 = 14\) TFLOPs 的算力但 memory-bound、约 20–30 秒;一张 SD 图是它的 5 倍 FLOPs 却只要 3 秒——扩散模型的每步是一次大 batch 的 GEMM(整张图的所有 patch 并行),compute-bound、没有 KV cache、没有自回归的串行。这是扩散模型服务与 LLM 服务形态不同的根源,下一篇展开。
七、动手(建议)
CIFAR-10(\(32^2\))上从零训两个小模型(同一个 U-Net,约 35M 参数,diffusers 的 UNet2DModel 或自写),一张 24 GB 卡各几小时:
- DDPM(上篇动手节)与 flow matching:直线路径,\(v\)-prediction,\(t \sim U[0,1]\) 与 logit-normal 两种;采样用 Euler 50 / 20 / 10 / 5 步。
- 各训 20 万步 batch 128;用
torch-fidelity或clean-fid算 FID(对 10K 样本)。 - 加一个条件版本(类别标签,条件 dropout 10%),扫 \(w \in \{1, 2, 4, 8\}\),看 FID 与 Inception Score(或按类的多样性)的权衡;对 \(w = 8\) 看像素值的分布是否溢出。
- 对 flow matching 模型做一轮 reflow(用它生成 5 万对 (噪声, 样本),在固定配对上再训 5 万步),比 1 / 2 / 4 步的 FID。
该看的:flow matching 10 步与 DDIM 10 步的 FID 差;reflow 后 2 步的 FID 是否接近原模型 20 步;logit-normal 是否优于均匀;\(w\) 增大时 FID 先降后升、多样性单调降。不引用任何未跑过的数字。
配套代码:本文全部 toy 数字与四张图由 multimodal/07_flow_score_cfg_toy.py 产生(score / flow / steps / cfg 四个子实验;需要先跑上篇的 06_ddpm_toy.py train 得到 DDPM 模型),CPU 一两分钟。
八、本文小结
| 项 | 公式 | 备注 |
|---|---|---|
| 分数 | \(s = \nabla \log p_t\),指向密度上升最快的方向;DSM 目标 \(-\epsilon/\sigma\) | 一维混合高斯先看峰与谷;加噪让稀疏区域的分数更平滑 |
| 参数化 | \(s=-\epsilon/\sigma_t\);\(\hat x_0=(x_t+\sigma_t^2s)/\alpha_t\);线性路径 \(v=\epsilon-x_0\) | 不同输出可线性换算;速度公式依赖直线路径 |
| Tweedie | \(\mathbb{E}[x_0 \mid x_t] = (x_t + \sigma_t^2 s)/\alpha_t\) | DDPM 采样循环里的 \(\hat x_0\) 是沿分数修正后的后验均值 |
| SDE / ODE | 反向 SDE \(dx = [f - g^2 s] dt + g\, d\bar w\);概率流 ODE \(dx = [f - \frac{1}{2} g^2 s] dt\) | 边缘分布相同;ODE 确定,可用数值求解器 |
| flow matching | \(x_t = (1-t) x_0 + t \epsilon\),\(\mathcal{L} = \lVert v_\theta - (\epsilon - x_0) \rVert^2\) | 条件速度的期望 = 边缘速度;与 \(\epsilon\) 线性换算 |
| 统一 | 所有损失 = 加权 ELBO,差别只在噪声水平的权重与路径形状 | Kingma & Gao 2023 |
| 直线 | 随机配对 → 边缘轨迹弯(toy 直线度 0.49);reflow 在 ODE 配对上重训 → 1.00,一步采样 0.030 | SD3 / FLUX 20–30 步;5 步时 FM 0.041 vs DDIM 0.099 |
| 调度 |
|
logit-normal 增加中段采样;resolution shift 是经验校准 |
| CFG | \(\tilde\epsilon = \epsilon_\emptyset + w(\epsilon_c - \epsilon_\emptyset)\);每个噪声层 \(\propto p_t(x) p_t(c \mid x)^w\),终点不是 \(p_0\) 的幂分布 | toy:\(w\) 1 → 4 命中 95% → 100%、标准差 0.60 → 0.35;\(w = 8\) 甩出分布外 |
| 修正 |
|
分别控制数值范围、guidance 时间区间与前向次数 |
| 成本 |
|
常规 CFG 每步两份预测;蒸馏可改成一份 |
九、自测
-
噪声预测 \(\epsilon_\theta\)、分数 \(s = \nabla \log p_t\)、flow matching 的速度 \(v\) 三者怎么互相换算?
答案
\(\epsilon = -\sigma_t s\)(去噪分数匹配 = 噪声预测);线性插值路径 \(x_t = (1 - t) x_0 + t\epsilon\) 下 \(v = \epsilon - x_0\),与 \(\epsilon\)、\(x_0\) 线性相关。三个视角在高斯路径下训的是同一个网络、不同的参数化(一般路径上 \(v = \dot a_t x_0 + \dot b_t\epsilon\),直线时才是 \(\epsilon - x_0\))。
-
flow matching 的每条训练路径都是直线,为什么学出来的采样轨迹会弯?reflow 做了什么?
答案
训练时 \(x_0\) 与 \(\epsilon\) 随机配对,不同配对的直线互相交叉,网络在交点只能输出它们的平均速度,轨迹就拐弯(toy 直线度 0.49)。reflow 用训好的模型生成 (噪声, 样本) 配对——它们由 ODE 轨迹连接、不相交——在这些固定配对上重训,轨迹变直(1.00),一步就能采样。
-
CFG \(w = 7.5\) 在数学上做了什么?为什么不是 \(w = 1\)?
答案
\(\hat\epsilon = \epsilon(\varnothing) + w[\epsilon(c) - \epsilon(\varnothing)]\),在每个噪声层上等价于用 \(p_t(x)\, p_t(c \mid x)^w\) 的分数——把条件似然的幂放大 \(w\) 倍,让样本更”像 prompt”(终点分布不是 \(p_0\) 的幂分布,第五章 §2 的高斯反例);\(w = 1\) 是原始条件分布,多样但贴合度低(toy 上 5% 落错月牙);7.5 是贴合与多样、饱和之间的经验点。代价是每步两次前向。
-
toy 上 \(w = 8\) 的样本被甩到数据之外,对应文生图里的什么现象?怎么修?
答案
过饱和 / 过曝:\(\tilde\epsilon\) 的范数超出训练分布,像素被推出 \([-1, 1]\)。修法:动态阈值(按分位数裁剪 \(\hat x_0\) 再缩放)、CFG rescale(把 \(\tilde\epsilon\) 的标准差缩回 \(\epsilon_c\) 的)、区间 guidance(只在中间噪声水平用 \(w > 1\))。
-
Tweedie 公式说最优去噪器给出 \(\mathbb{E}[x_0 \mid x_t]\)。为什么一步去噪不能直接得到干净的图、要走几十步?
答案
后验均值是”所有可能产生 \(x_t\) 的 \(x_0\) 的平均”,噪声大时可能的 \(x_0\) 很多,平均是一张模糊的图(toy 上落在月牙的中间)。每一步只朝均值走一小段、再让下一步在更低的噪声水平上重新估计,逐步细化才得到清晰的样本——直线度高的模型(reflow 后)例外,因为它的一步就是整条路。
-
为什么 score matching 不只学习干净数据的分数?DSM 训练时又为什么不需要知道边缘分布 \(p_t\)?
答案
干净样本集中在低维流形附近,流形外的密度极低,分数难以从有限数据估计;加噪把分布平滑开,采样时则需要网络在每个噪声水平都给出分数。训练时给定 \(x_0\) 和人为采样的噪声,就能算出条件高斯分数 \(-\epsilon/\sigma_t\);MSE 的最优预测是这些条件分数在给定 \(x_t\) 下的平均,等于边缘分数。
-
概率流 ODE 与反向 SDE 的采样有什么区别?若用普通 CFG 采样 \(N\) 步,网络大约要做多少次前向?
答案
反向 SDE 每一步仍抽新的随机噪声;概率流 ODE 不加新噪声,给定初始点后轨迹确定,但两者每个时刻的边缘分布相同。普通 CFG 每步要分别算无条件和有条件预测,所以约为 \(2N\) 次前向;若把两份输入拼进一个 batch,调用次数可能少一些,但算术量仍接近两份预测。
-
三者学的是同一个对象——每个噪声水平下带噪数据分布的分数 \(\nabla_x \log p_t(x)\)——的三种线性参数化:DDPM 的噪声 \(\epsilon = -\sigma s\)(Tweedie 公式),flow matching 的速度 \(v = \epsilon - x_0\) 也由 \(x_t\) 与 \(\epsilon\) 线性决定;在高斯路径的前提下三种训练损失换元后只差一个与噪声水平有关的权重(加权的 ELBO);三者的采样都是解同一个概率流 ODE(或反向 SDE),DDIM 是它的一种离散化,flow matching 的直线参数化让轨迹容易拉直(reflow)、Euler 法少步就够。详见第二章、第三章。 ↩
-
每个噪声层上用的分数对应 \(\propto p_t(x)\, p_t(c \mid x)^{7.5}\)——把「这张图有多符合文本」这一项升到 7.5 次幂(终点样本的分布不是干净分布的这个幂,只是逐层的直觉),分布被锐化到最典型地符合文本的模式上:一致性与保真度上升、多样性下降(toy:\(w\) 从 1 到 4,标准差 0.60 → 0.35)、外推过头落到分布之外导致过饱和(toy 的 \(w = 8\)),需要动态阈值或 rescale 修正,且每步要两次前向(除非蒸馏掉)。详见第五章。 ↩
系列 《多模态:从视觉编码器到扩散模型》 第 7 / 10 篇 进阶
系列总览 — 为什么这样组织、读它需要什么、读完能做什么 · 幻灯片 — 整个系列的精华,一份可分享的 deck
学习地图 — AI 算法工程师学习地图 第 12 / 12 个系列
- 视觉编码器——CLIP、SigLIP 与自监督 ViT
- connector、注入方式与分辨率策略
- VLM 的训练:数据、阶段与评测
- 从波形到 token——mel 谱、Whisper 与神经 codec
- 语音理解、语音生成与全双工
- DDPM——加噪、去噪与「预测噪声」
- score matching、flow matching 与 classifier-free guidance
- Latent diffusion、DiT 与文生图配方
- 自回归图像生成与统一模型
- 系列总结与通关自测
上一篇:DDPM——加噪、去噪与「预测噪声」下一篇:Latent diffusion、DiT 与文生图配方
去 Series 挑下一个系列
本文由 arganzheng 创作,采用 CC BY 4.0 许可协议。在保留原文作者、署名以及完整原文链接(https://arganzheng.life/score-matching-flow-matching-and-classifier-free-guidance.html)的前提下,欢迎各种形式的转载、翻译或商业引用。
COMMENTS
评论存放在 GitHub Discussions, 用 GitHub 账号登录即可发表,支持 Markdown。 想针对正文某句话说?选中那段文字,点浮出的「评论」即可划线评论;觉得哪里写错了,发表时勾上「同时提交 Issue」。 有人回复你时 GitHub 会按你的通知设置发邮件,不用守在这里。