系列 《现代 LLM 结构:从 GPT-2 到今天的演进》 第 5 / 11 篇 进阶
系列总览 — 为什么这样组织、读它需要什么、读完能做什么 · 幻灯片 — 整个系列的精华,一份可分享的 deck
学习地图 — AI-Infra 工程师学习地图 第 5 / 14 个系列 · AI 算法工程师学习地图 第 6 / 12 个系列
本篇在系列中的位置。 现代 LLM 结构系列的第五篇。《位置编码与外推》讲了位置能不能外推,《Attention 变体与 KV cache》讲了 KV cache 的账,本篇先算长上下文下 KV cache、prefill 与中间量各涨成什么函数,再比较线性 attention、SSM 与混合架构如何改变历史信息的保存方式。完整地图见总纲。
《位置编码与外推》回答了模型凭什么知道一个 token 在第几个位置、为什么用 8K 训练的 RoPE 模型不能直接推理 32K。但即使位置编码完全没问题,上下文长度 \(s\) 仍然受另一组限制:它同时进入 KV cache 的一次项和 attention 算量的二次项。Llama-3-70B 在 128K 上下文下,每个 token 花在 attention 上的算量(344 GFLOPs)已经超过了花在全部权重上的算量(141 GFLOPs)。这些限制与位置怎么编码无关,改变它们要改 attention “看哪些 token”。
本篇要回答的核心问题是:
一、总览:一个线性项、一个二次项、一个中间量
上下文长度 \(s\) 进入三样东西:要一直留在显存里的 KV cache、prefill 时 attention 的算量、attention 内部的分数矩阵。三者随 \(s\) 增长的函数不同,能改写它们的结构手段不同,落到推理系统上的指标也不同。下图一列画一项:
%%{init: {"flowchart": {"wrappingWidth": 250}}}%%
%% 图:上下文长度 s 进入的三项成本,各自被哪些结构手段改写、落到哪个系统指标
flowchart TB
    S["<b>一个上下文长 s 的请求</b><br/>full attention:每个 token 看前面全部 token"]
    S --> KV["<b>线性项:KV cache(第二章)</b><br/>每请求 $$b \cdot L \cdot s$$ 字节<br/>Llama-3-70B 128K:40 GiB"]
    S --> PF["<b>二次项:prefill 的 attention(第二章)</b><br/>$$4dL \cdot s^2/2$$ FLOPs<br/>Llama-3-8B 128K:4.5 PFLOP,占 prefill 的 70%"]
    S --> MID["<b>中间量:s × s 的 logits(第二章)</b><br/>128K 单头 32 GiB,不能物化"]
    KV --> KVR["<b>谁改写线性项</b><br/>• 滑窗、sink + 滑窗:s 换成 min(s, W)(第三章)<br/>• 全局 / 局部交错:系数乘 1/k(第三章)<br/>• MLA:系数减 57 倍,阶不变(第三章)<br/>• 线性 attention、SSM:换成固定大小的状态(第四章)<br/>• 块稀疏:一般不减(第三章)"]
    PF --> PFR["<b>谁改写二次项</b><br/>• 滑窗:$$s^2$$ 变成 $$sW$$(第三章)<br/>• 交错、混合架构:系数变成 full 层占比(第三、四章)<br/>• 块稀疏:乘稀疏度 ρ(第三章)<br/>• 线性层的分块形式:对 s 线性(第四章)"]
    MID --> FA["<b>FlashAttention(第二章)</b><br/>分块 online softmax,logits 只在 SRAM 里存一个块"]
    KVR --> CONC["<b>并发数(第五章)</b><br/>显存预算 ÷ 每请求 KV"]
    PFR --> TTFT["<b>TTFT 与调度(第五章)</b><br/>• prefill 时间是 TTFT 的下界<br/>• chunked prefill:不让长请求独占 GPU<br/>• 序列并行:单请求切到多卡"]
- 一个上下文长 s 的请求:基线是 full attention,每个 token 都看前面全部 token;下面三项都是这个前提下的函数,改「看哪些 token」就改了函数。
- 线性项:KV cache:每个 token 在每一层留下一份 K、V,每请求 \(b \cdot L \cdot s\) 字节(\(b\) 是每层每 token 的 KV 字节数)。Llama-3-8B 128K 是 16 GiB,Llama-3-70B 是 40 GiB(第二章第 3 节)。
- 二次项:prefill 的 attention:prefill 对 \(s\) 个 token 各看一遍前文,合计 \(4dL \cdot s^2/2\) FLOPs。Llama-3-8B 的每 token attention 算量在约 28.6K 处超过权重算量;128K prefill 共 6.5 PFLOP,其中 4.5 PFLOP 是这一项(第二章第 1 节、第 2 节)。
- 中间量:s × s 的 logits:\(QK^\top\) 的分数矩阵,128K 时单头 32 GiB、32 头 1 TiB。它不计入 FLOPs,也不在 KV cache 里,但写不进显存(第二章第 4 节)。
- 谁改写线性项:滑窗与 sink + 滑窗把 \(s\) 换成 \(\min(s, W)\),改的是阶;全局 / 局部交错与 MLA 只改系数;块稀疏要留着全部块供挑选,一般不减(第三章)。线性 attention 与 SSM 不再逐 token 保存 K、V,换成每层固定大小的递归状态(第四章第 1 节)。
- 谁改写二次项:滑窗把整段 prefill 的 attention 从 \(s^2\) 变成 \(sW\);交错与混合架构不改阶,系数变成 full attention 层的占比;块稀疏乘上保留比例 \(\rho\)(第三章第 5 节)。线性层的分块形式每 token 算量与 \(s\) 无关(第四章第 3 节)。
- FlashAttention:把 softmax 拆成分块的 online softmax,分数矩阵一次只有一个块,留在 SRAM 里,不写回 HBM。这一项靠 kernel 的写法解决,与模型结构无关(第二章第 4 节)。
- 并发数:一张卡放下权重后剩余的显存除以每请求 KV,就是并发上限;H100 上的 Llama-3-8B,8K 上下文 59 个请求,128K 只有 3 个(第五章)。
- TTFT 与调度:prefill 时间是首 token 延迟的下界(8B、128K、单卡约 11 s);chunked prefill 让这 11 s 不被一个请求独占,序列并行把单个请求切到多卡(第五章)。
图里的几样东西产生的时机、存放的位置、存活的时间各不相同,后面各章反复用到:
| 对象 | 什么时候算出来 | 存在哪里 | 活多久 | 随 \(s\) 怎么长 |
|---|---|---|---|---|
| full attention 层的 K、V | 每个 token 经过这一层时算一次:prefill 一次算 \(s\) 个,decode 每步 1 个 | HBM 里的 KV cache,每请求一份 | 到请求结束 | 线性,\(b \cdot L \cdot s\) |
| 滑窗 / 局部层的 K、V | 同上 | KV cache 里 \(W\) 个槽的环形缓冲区 | 到 \(W\) 个 token 之后被新写入覆盖 | 到 \(W\) 封顶 |
| attention 的 logits 与 softmax 概率 | 每次运行 attention kernel 时 | FlashAttention 下按块留在 SRAM,不写回 HBM | 这一块算完即丢 | 若物化是 \(s^2\);分块后与 \(s\) 无关 |
| 线性层的递归状态 \(S\) | decode 每个 token 更新一次;prefill 的分块形式每块更新一次 | HBM,每层每头一个 \(d_k \times d_v\) 的矩阵,每请求一份 | 到请求结束;原地更新,旧状态不保留 | 不长 |
| 分块形式的块内 \(C \times C\) 矩阵 | 训练、prefill 处理每一块时 | kernel 的临时缓冲 | 这一块算完即丢 | 不长,由块长 \(C\) 决定 |
| 每层的 hidden state | 前向经过每一层时 | 激活值;prefill 时是 \(s \times d\) | 推理时下一层算完即可释放 | 线性;Llama-3-70B 128K 每层 2 GiB |
1. 本文的思路
先把 full attention 下长上下文的三项成本算出来(第二章),再看四类结构手段各自把哪一项从什么函数改成什么函数(第三章),再比较递归状态与混合 attention(第四章),最后落到推理系统上:并发数、TTFT、chunked prefill 与序列并行(第五章)。
本篇只算成本,不等于长上下文只影响成本。 效果是另一笔账,而且通常先于成本撞墙:标称 128K 甚至 1M 的模型,在 RULER 一类需要跨越全文聚合、推理的评测上,有效长度常常只有标称的一半甚至更短;”大海捞针”满分不代表装得下,它只测精确取回一条信息。效果下降的来源有三个,分别在别处讨论:
- 位置方案在训练长度之外的相位分布没被覆盖,或像 ALiBi 那样带局部性先验,远处的信息取不准。见《位置编码与外推》。
- softmax 把一个固定的注意力预算摊到更多 token 上,无关 token 越多、每个相关 token 分到的权重越小,再加上”中间丢失”的位置偏置。这是 attention 机制本身的性质,sink 与稀疏 attention(第三章)部分是对它的回应。
- 训练数据里真正长的样本很少,长上下文能力要靠继续预训练阶段的长度课程与数据配比专门训出来。见《预训练:从 tokenizer 到训练配方》系列《训练配方与稳定性》的「长上下文继续预训练」一章。
所以”这个模型支持 128K”要分两句读:成本上装得下(本篇算的),效果上用得好(上面三处决定);两句都成立才是真的 128K。
2. 数字基线
模型与《Attention 变体与 KV cache》相同:Llama-3-8B、Llama-3-70B、DeepSeek-V3;硬件以 H100 SXM 为准(BF16 dense 989 TFLOPS,3.35 TB/s,80 GB)。所有 FLOPs 与字节数都是理论下界,不是实测。
3. 本文的章节安排
| 章 | 主题 | 内容 |
|---|---|---|
| 二 | 长上下文的成本 | attention 算量与权重算量的交叉点(图)、128K prefill 的 11 秒、KV cache 线性项、s² 的 logits |
| 三 | 缩短成本的结构手段 | sliding window、全局/局部交错、attention sink、稀疏 attention;每种手段改成了什么函数 |
| 四 | 换掉 attention:线性 attention、SSM 与混合架构 | 递归状态、delta rule、同一个算式的三种算法(递归 / 并行 / 分块)、已发表层比例、Qwen3-Next 配置内存算例 |
| 五 | 对 Infra 的影响汇总 | 五处影响的汇总表、并发数、TTFT、chunked prefill、序列并行 |
| 六 | 实践 | llm_cost.py 上下文长度扫描 |
| 七 | 本文小结 | |
| 八 | 自测 | 6 道题 |
二、长上下文的成本
位置编码决定了模型能不能处理长上下文;这一章算它要花多少。《前向的算量与访存量》的两个基本公式重新写在这里:矩阵乘 \([m, k] \times [k, n]\) 是 \(2mkn\) FLOPs,因此每参数每 token 2 FLOPs;attention 对上下文 \(s\) 的部分,每层每 token \(QK^\top\) 与 \(PV\) 各 \(2 \cdot n_h \cdot d_{head} \cdot s = 2ds\),合计 \(4ds\)。
1. 每 token 的 attention 算量与权重算量的交叉点
Llama-3-8B 的权重 GEMM 部分每 token \(2 \times (8.03 - 0.53)\text{B} \approx 15.0\) GFLOPs(embedding 查表不算 GEMM,lm_head 算)。attention 部分每层 \(4 \times 4096 \times s = 16384\,s\),32 层 \(0.524 \times 10^6 \cdot s\) FLOPs:
| 上下文 s | Llama-3-8B attention/token | Llama-3-8B 占比 | Llama-3-70B attention/token | Llama-3-70B 占比 |
|---|---|---|---|---|
| 8192 | 4.3 GFLOPs | 22.2% | 21.5 GFLOPs | 13.2% |
| 32768 | 17.2 GFLOPs | 53.4% | 85.9 GFLOPs | 37.9% |
| 131072 | 68.7 GFLOPs | 82.1% | 343.6 GFLOPs | 70.9% |
| 权重部分 | 15.0 GFLOPs | 141 GFLOPs |
把表里的两项画成 \(s\) 的函数,权重项是一条水平线,attention 项是一条过原点的直线:
Llama-3-70B 在 128K 下:\(4 \times 8192 \times 131072 \times 80 \approx 344\) GFLOPs,是权重 141 GFLOPs 的 2.4 倍。交叉点(attention 等于权重)在 8B 约 28.6K、70B 约 53.8K——超过这个长度,模型每生成一个 token 的主要算量就不再是”跑一遍权重”,而是”看一遍上下文”。
这个交叉点对 decode 的 Roofline 判断有直接影响。《前向的算量与访存量》的「decode 权重 GEMM 的算术强度 ≈ B」一节的结论是 decode 时权重 GEMM 的算术强度约等于 batch 大小 \(B\)(BF16),\(B = 1\) 时距 H100 的 ridge point 295 差两个数量级,是 memory-bound。attention 对 KV cache 的读取也是 memory-bound 的,而且它不随 batch 摊薄——每个请求有自己的 KV cache,\(B\) 个请求就读 \(B\) 份。上下文 8K、batch 64 时 8B 模型每步要读 \(128\,\text{KiB} \times 8192 \times 64 = 64\) GiB 的 KV cache,是权重(16 GB)的四倍。长上下文下 decode 的瓶颈从”读权重”变成”读 KV cache”。
2. prefill 的二次项:一个 128K 请求的 11 秒
prefill 要对 \(s\) 个 token 各算一遍。权重项与 \(s\) 成正比,attention 项与 \(s^2\) 成正比(利用因果掩码,只算下三角,取 \(s^2/2\)):
\[\text{FLOPs}_{prefill}(s) = 2N_{gemm} \cdot s + 4dL \cdot \frac{s^2}{2}\]Llama-3-8B、\(s = 131072\):
\[\underbrace{15.0 \times 10^9 \times 131072}_{\approx 2.0\ \text{PFLOP}} + \underbrace{0.524 \times 10^6 \times \frac{131072^2}{2}}_{\approx 4.5\ \text{PFLOP}} \approx 6.5\ \text{PFLOP}\]H100 BF16 989 TFLOPS,按 60% MFU 算 593 TFLOPS,\(6.5 \times 10^{15} / 593 \times 10^{12} \approx 11\) s。同一个模型 8K 的 prefill 约 0.14 PFLOP、0.24 s;128K 是 8K 的 16 倍长度、46 倍算量、46 倍时间。二次项已经占了 70%。
对 70B,128K prefill 约 41 PFLOP(权重 18.5 + attention 22.5),单卡 60% MFU 要 69 s;即便 8 卡 TP 完美线性,也接近 9 s。这就是 TTFT(time to first token)在长上下文下的量级:不是调度问题,是算量问题(60% 是经验效率,按峰值算的物理下界是 6.6 s / 41 s;《前向的算量与访存量》的「时间下界」一章说明了两者的区别)。
3. KV cache 的线性项
《Attention 变体与 KV cache》的「KV cache 的大小公式」一节给出:每 token 的 KV cache 字节数为 \(2 \cdot L \cdot n_{kv} \cdot d_{head} \cdot \text{bytes}\)。
| 模型 | bytes/token | 8K | 32K | 128K |
|---|---|---|---|---|
| Llama-3-8B | 128 KiB | 1.0 GiB | 4.0 GiB | 16 GiB |
| Llama-3-70B | 320 KiB | 2.5 GiB | 10.0 GiB | 40 GiB |
| DeepSeek-V3 (MLA) | 68.6 KiB | 0.54 GiB | 2.1 GiB | 8.6 GiB |
Llama-3-8B 一个 128K 请求的 KV cache 是它权重(16.06 GB)的大小;70B 一个 128K 请求 40 GiB,是单张 H100 一半的显存。对 Infra 来说,长上下文的 KV cache 意味着并发数的上限:H100 放下 8B 权重后剩约 64 GB(59.5 GiB),8K 上下文可以放 59 个请求的 KV,128K 只能放 3 个。
4. 中间量:s² 的 logits 矩阵
还有一项不在 FLOPs 和 KV cache 里,但在实现上更致命:attention 分数矩阵 \(QK^\top\) 本身是 \(s \times s\)。128K 时单个 head 的 logits 就是 \(131072^2 \times 2\,\text{B} = 32\) GiB(BF16),32 个 head 就是 1 TiB。它不可能物化。FlashAttention(Dao 等 2022)把 softmax 拆成分块的 online softmax,logits 只在 SRAM 里存一个块,从来不写回 HBM——长上下文可行的前提不是显存大,而是 attention kernel 从不物化 \(s \times s\)。同样,训练时 attention 的中间激活如果物化,反向传播也需要它,这是 FlashAttention 对长上下文训练的意义。
三、缩短成本的结构手段
上面的成本函数是 full attention 的:每个 token 看所有前面的 token。改变”看哪些”就改变了函数形式。
1. sliding window attention
Mistral 7B(Jiang 等 2023)让每个 token 只看前面 \(W = 4096\) 个 token。attention 算量从 \(4dLs\) 变成 \(4dL \cdot \min(s, W)\),KV cache 从 \(s\) 个 token 变成 \(\min(s, W)\) 个——两者都从 \(O(s)\) 变成 \(O(W)\),即常数。Mistral 7B 的每 token KV cache 与 Llama-3-8B 相同(32 层、8 个 KV 头、\(d_{head} = 128\),128 KiB),但上限是 \(4096 \times 128\,\text{KiB} = 512\) MiB,无论输入多长;attention 算量上限 \(4 \times 4096 \times 4096 \times 32 \approx 2.1\) GFLOPs/token,约为权重(7.24B 参数,GEMM 部分 14.2 GFLOPs)的 15%。
实现上 KV cache 变成一个环形缓冲区(rolling buffer),位置 \(n\) 的 K、V 写到槽 \(n \bmod W\),第 \(W + 1\) 个 token 覆盖第 1 个。以 \(W = 4\) 为例,位置 3 到 6 依次写入时:
| 写入的 token 位置 \(n\) | 写到槽 \(n \bmod 4\) | 写入后槽 0 / 1 / 2 / 3 里存的位置 | 这个 token 的 query 能看到的位置 |
|---|---|---|---|
| 3 | 3 | 0 / 1 / 2 / 3 | 0–3 |
| 4 | 0 | 4 / 1 / 2 / 3 | 1–4 |
| 5 | 1 | 4 / 5 / 2 / 3 | 2–5 |
| 6 | 2 | 4 / 5 / 6 / 3 | 3–6 |
缓冲区大小固定为 4 个槽,槽里的顺序不再等于位置顺序(写完位置 6 后是 4、5、6、3),所以每个槽要记住自己存的是哪个位置,RoPE 已经在写入前乘进 K 里了,attention 本身不关心槽的顺序。vLLM 对 sliding window 模型的 block 分配也是这个思路,只是以 block 为单位:窗口外的整块归还给块池。
Java 经验参照:定长环形缓冲区
这就是容量固定的环形缓冲区(LMAX Disruptor 的 RingBuffer、日志框架里的定长异步队列):序号一直递增,槽下标是「序号 mod 容量」,写满后新元素覆盖最旧的槽,内存占用与写入总量无关。对得上的还有一点:槽里的物理顺序不等于逻辑顺序,读的一方要靠序号判断新旧。对不上的地方是读法:队列的消费者按序号顺序取,attention 每一步把 \(W\) 个槽全部读一遍做加权和。
代价是信息只能通过层间传递向远处流动:第 \(\ell\) 层的 token 能间接看到 \(\ell \cdot W\) 之内的信息(每层扩一个窗口),32 层理论上是 131072,但每一跳都有损。事实上 Mistral 7B 自 v0.2 起(模型卡写明 No Sliding-Window Attention)和 Mixtral 都取消了滑窗,回到 full attention,说明纯滑窗在长程精确检索任务上有代价。
2. 全局层与局部层交错
Gemma 2(2024)把两种层交错排列:奇数层用 \(W = 4096\) 的局部 attention,偶数层用 full attention,1:1 交错。这是一个折中:一半的层保留了远距离精确取回的能力,另一半的 KV cache 与算量被封顶。
KV cache 变成:
\[\text{KV}(s) = \frac{L}{2} \cdot b \cdot \min(s, W) + \frac{L}{2} \cdot b \cdot s\]其中 \(b\) 是每层每 token 的 KV 字节数。\(s \gg W\) 时约为 full attention 的一半。attention 算量同理,\(s \gg W\) 时约减半。它没有改变函数的阶(仍然 \(O(s)\) 的 KV 与 \(O(s^2)\) 的 prefill),只是把系数减半;如果全局层占 \(1/k\),系数就变成 \(1/k\)。这类设计在 2024–2025 年成为长上下文模型的常见选择,局部与全局层的比例从 1:1 到 5:1 不等。
用一个公开配置把公式算一遍。Gemma-3-27B(2025-03)共 62 层,其中 10 层 full attention、52 层窗口 1024 的局部 attention(约 5:1);每层每 token 的 KV 是 \(2 \times 16 \times 128 \times 2\,\text{B} = 8\) KiB。一个 128K(131,072 token)请求:
| 层的类型 | 层数 | 每层存多少个 token 的 KV | KV |
|---|---|---|---|
| 若全部是 full attention(对照) | 62 | 131,072 | \(62 \times 8\,\text{KiB} \times 131072\) = 62 GiB |
| full attention 层 | 10 | 131,072 | \(10 \times 8\,\text{KiB} \times 131072\) = 10 GiB |
| 局部层(\(W = 1024\)) | 52 | 1,024 | \(52 \times 8\,\text{KiB} \times 1024\) = 416 MiB |
| 交错后合计 | 62 | 约 10.4 GiB |
交错后约为对照的 1/6,几乎全部来自 10 层 full attention;52 层局部层合起来不到半 GiB,再长的上下文也不会让它们变大。这正是公式里 \(s/k\) 那一项:\(s \gg W\) 时系数由全局层占比决定(这里 10/62)。
3. attention sink 与 StreamingLLM
StreamingLLM(Xiao 等 2023)观察到一个现象:在 full attention 训练的模型里,大量的 attention 分数会集中到序列最开头的几个 token 上,无论那几个 token 是什么内容——它们是 softmax 的”泄洪口”(attention sink):当一个 query 与所有 key 都不相关时,softmax 仍然要把概率分配出去,模型学会了把这些概率倒进开头几个 token。
这解释了为什么朴素的滑窗(丢掉最早的 token)会让 full attention 训练的模型崩溃:sink 被丢了,softmax 的概率没地方去。StreamingLLM 的做法是永远保留开头 4 个 token 的 K、V,再加一个滑动窗口。KV cache 是 \(b \cdot L \cdot (4 + \min(s, W))\),与滑窗同阶。它使一个 full attention 训练的模型可以在不微调的情况下处理无限长的流式输入——但代价与滑窗一样,窗口之外的信息丢失了,它是”流式稳定”而非”长上下文理解”。
对位置编码有一个细节:保留 sink 并滑动窗口后,位置用的是cache 内的相对位置(sink 是 0–3,窗口内从 4 开始连续编号),而不是原始文本中的位置;否则 RoPE 的相对距离会超过训练长度,回到《位置编码与外推》的「为什么外推失败」一节讲的问题。以 \(W = 6\)、当前正在生成第 10003 个 token 为例,cache 里的内容与它们用的 RoPE 位置是:
新 token 与最早的窗口 token(t9997)之间的相对距离在 RoPE 看来是 \(10 - 4 = 6\)——这一项本来就是 \(10003 - 9997 = 6\),窗口内的相对距离重编号前后不变;真正被改变的是 sink 与新 token 的距离:原文里是 10003,重编号后是 10。所有相对距离都被控制在 \(W + 4\) 之内,永远不会超出训练长度。这是 sink + 滑窗特有的处理;普通滑窗(不保留 sink)不需要重编号,用原始位置即可——窗口内的相对差值本来就 \(\le W\)。
4. 稀疏 attention 的形态
更一般的做法是让每个 query 只看上下文中的一个子集,子集的选法有多种:
- 块稀疏(block-sparse):把 K、V 按块(例如 64 个 token)分组,每个 query 块只看部分 key 块——固定模式(局部块 + 若干全局块,如 Longformer、BigBird)或按块的粗粒度分数动态选(top-k 块)。稀疏度 \(\rho\)(保留的块占比)下算量约为 \(4dLs \cdot \rho\);KV cache 通常不减(需要保留所有块以便选择),除非配合淘汰策略。
- DeepSeek 的 NSA(Native Sparse Attention,Yuan 等 2025)一类:把上下文压成粗粒度的块表示、按块选 top-k 精细 attention、再加一个滑窗,三路结果加权,并在训练时就使用这种结构,让 kernel 形态对齐硬件的块粒度。这一类方法的算量是 \(O(s \cdot k_{blocks} \cdot B_{size})\) 加压缩部分,接近线性。
三种可见范围画在同一个 16-token 的因果 score 矩阵上(行是 query,列是 key,深色格子表示要算的分数):
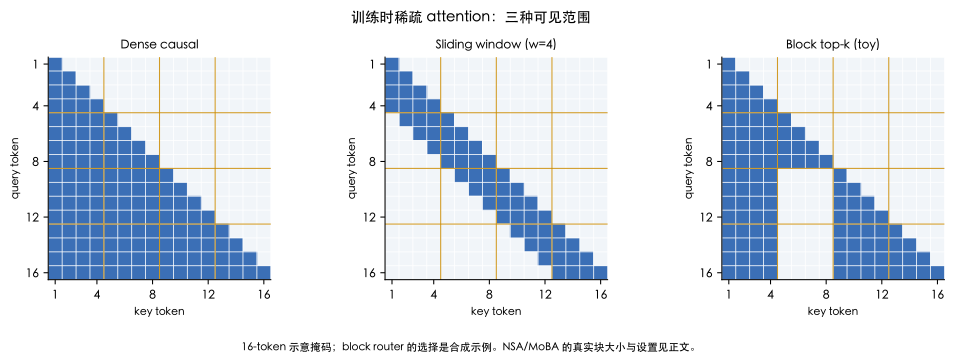
dense causal 是整个下三角,深色格子数随 \(s\) 平方增长;滑窗是一条宽 \(W\) 的对角带,每行最多 \(W\) 格;block top-k 以 4×4 的块为单位,每个 query 块只算自己的对角块加选中的少数 key 块(图里第 2–4 个 query 块都选了第 1 块,第 4 块还选了第 3 块;这是合成的选择,真实模型由 query 与块摘要的打分决定)。sink + 滑窗相当于在滑窗那条带的左边再固定加上第 1 列的几格。
这里只提形态,不展开。关键在于任何稀疏方法的实现都要处理索引与不规则访存——被选中的 K、V 块散落在 HBM 中,kernel 要 gather,这与 dense attention “顺序读一整段”是完全不同的访存模式,也是稀疏 attention 的理论算量节省常常兑现不到实测的原因。
5. 对比:每种手段把成本改成了什么函数
以每层每 token 的 KV 字节 \(b\)、模型层数 \(L\)、上下文 \(s\)、窗口 \(W\)、全局层占比 \(1/k\)、稀疏度 \(\rho\) 表示:
| 手段 | KV cache(每请求) | attention 算量(每 token) |
|---|---|---|
| full attention | \(b \cdot L \cdot s\) | \(4dL \cdot s\) |
| sliding window (\(W\)) | \(b \cdot L \cdot \min(s, W)\) | \(4dL \cdot \min(s, W)\) |
| 全局/局部交错 (\(1/k\)) | \(b \cdot L \cdot [\, s/k + (1 - 1/k)\min(s, W) \,]\) | \(4dL \cdot [\, s/k + (1 - 1/k)\min(s, W) \,]\) |
| sink + window | \(b \cdot L \cdot (4 + \min(s, W))\) | \(4dL \cdot (4 + \min(s, W))\) |
| 块稀疏(保留 \(\rho\)) | \(b \cdot L \cdot s\)(一般不减) | \(4dL \cdot s \cdot \rho\) + 选择开销 |
| MLA(DeepSeek-V3) | \((d_c + d_h^R) \cdot 2\,\text{B} \cdot L \cdot s\)(系数减 57 倍) | 与 full attention 同阶(吸收后 FLOPs 更高) |
| 线性 attention(第四章) | 每层每头一个 \(d_k \times d_v\) 的状态,与 \(s\) 无关 | 递归形式 \(O(d_k d_v)\)、分块形式 \(O(C\,(d_k + d_v) + d_k d_v)\),都与 \(s\) 无关 |
值得注意的是 MLA 那一行:它减的是 KV cache 的系数(从 3.81 MiB 到 68.6 KiB),不改变它对 \(s\) 的线性依赖,也不减少 attention 算量;而滑窗改的是阶(从 \(s\) 到常数),但丢信息。两者正交,可以叠加。
四、换掉 attention:线性 attention、SSM 与混合架构
前几节仍以 attention 为出发点:改变可见范围,压缩 K/V 表示,或避免物化中间矩阵。另一条路线则不保存每个过去 token 的完整 K/V,而是把历史递归地写进固定大小的状态。它换掉了 full attention 的信息访问方式,不是把 full attention 的 KV 系数再压小一点。
1. KV cache 与递归状态
Full attention 的每个新 token 都要把 K、V 加入 cache;有 \(L\) 层、每层 \(n_{kv}\) 个 KV heads、head dim 为 \(d_h\)、每个数 \(b\) 字节时:
\[\text{KV}_{\text{full}}(T)=2 L n_{kv} d_h b\,T=O(T)\]线性 attention 则把 key 与 value 的外积累加成一个每头状态 \(S_t \in \mathbb{R}^{d_k \times d_v}\),生成时只需更新并读取它:
\[S_t=S_{t-1}+\phi(k_t)v_t^\top,\qquad o_t=\phi(q_t)^\top S_t\]这里 \(\phi\) 是使递归形式成立的特征映射;状态矩阵大小是 \(d_k d_v\),不随已读 token 数增加。实际模型还可能保存卷积状态、门控量与实现所需的临时缓冲区,不能把这一个矩阵当成完整运行显存。
Java 经验参照:保留全部事件与只留聚合值
KV cache 相当于把每条事件都留在一个 List 里:内存随条数线性增长,之后任何查询都能重新扫一遍、取回任意一条。线性 attention 的状态相当于 stream.reduce 的累加器:每来一条就并进一个固定大小的聚合值,内存不变,但并进去之后单条事件取不回来,只能问聚合值答得出的问题。\(S_t = S_{t-1} + \phi(k_t)v_t^\top\) 就是一次 fold。混合架构每隔几层保留一层 full attention,等于聚合值之外仍留着一份明细。
2. Mamba 与 delta rule
Mamba把 selective state space model(选择性状态空间模型)用于序列建模:离散状态的更新参数依赖当前输入,使模型能够选择性地保留或遗忘历史;推理时维护固定长度状态,而不是逐 token 的全量 KV。它的线性序列处理形态不代表任意远处的信息都能像 full attention 一样逐项精确读取。
Gated Delta Networks把 delta rule 的“用新观测修正状态”与门控遗忘结合起来;Qwen3-Next 使用 Gated DeltaNet 作为混合架构中的线性 attention。线性状态让缓存不随上下文线性增长,但状态是对历史的压缩,精确检索与长程信息保真需要用具体任务评估,不能只看复杂度阶。
第 1 节的线性 attention 每步只往状态上加一项。Gated DeltaNet 的一步写成更新式是:
\[u_t=\beta_t\,\big(v_t-\alpha_t S_{t-1}^\top k_t\big),\qquad S_t=\alpha_t S_{t-1}+k_t u_t^\top\]其中 \(\alpha_t\)、\(\beta_t\) 是由当前 token 算出的两个 0 到 1 之间的门。这一步做三件事:
- 遗忘:\(\alpha_t\) 把旧状态整体乘小。
- 读出旧值:\(S_{t-1}^\top k_t\) 是状态里 \(k_t\) 这个方向上已经存着的 value。
- 只写差额:写入的 \(u_t\) 是「新值减旧值」的 \(\beta_t\) 倍,不是 \(v_t\) 本身。
取 \(\alpha_t = \beta_t = 1\)、\(k_t\) 为单位向量,更新后再用 \(k_t\) 去读,读到的恰好是 \(v_t\):旧值被改写了。第 1 节的加法形式做不到这一点,它只会把新旧两个 value 叠在一起。
3. 同一个算式的三种算法:递归、并行、分块
递归状态一次只吃一个 token,那一个 128K 的 prompt 要串行更新 131,072 步吗?3
不用。递归式只是三种等价算法中的一种,RetNet 把它们并列写了出来。下面用 4 个 token 手算一遍,取第 1 节的加法形式,\(d_k = 2\)、\(d_v = 1\),\(\phi\) 为恒等映射:
| token | \(k_t\) | \(v_t\) | \(q_t\) |
|---|---|---|---|
| 1 | (1, 0) | 2 | (1, 0) |
| 2 | (0, 1) | 3 | (1, 1) |
| 3 | (1, 1) | 1 | (0, 1) |
| 4 | (1, 0) | 4 | (1, 1) |
1、递归形式:一步一个 token。 按 \(S_t = S_{t-1} + k_t v_t\) 更新,再读 \(o_t = q_t^\top S_t\):
| \(t\) | 加上的 \(k_t v_t\) | \(S_t\) | \(o_t\) |
|---|---|---|---|
| 1 | (2, 0) | (2, 0) | 2 |
| 2 | (0, 3) | (2, 3) | 5 |
| 3 | (1, 1) | (3, 4) | 4 |
| 4 | (4, 0) | (7, 4) | 11 |
串行 4 步,任何时刻只存一个 \(S\)。decode 用的就是这种形式。
2、并行形式:把递归展开成一次矩阵乘。 把 \(S_t\) 逐步代回去,得到 \(o_t = \sum_{j \le t} (q_t^\top k_j)\,v_j\),写成矩阵是:
\[O=\operatorname{tril}(QK^\top)\,V\]图中间的 4 × 4 矩阵就是 \(\operatorname{tril}(QK^\top)\),每行乘 \(v = (2, 3, 1, 4)\) 得 (2, 5, 4, 11),与递归形式逐项相同。它没有串行步骤,但中间量是 \(T \times T\):这就是去掉 softmax 的 full attention,算量回到 \(O(T^2)\)。
3、分块形式:块内用并行,块间用递归。 把序列切成长 \(C\) 的块,第 \(c\) 块的 \(Q\)、\(K\)、\(V\) 记作 \(Q_{[c]}\)、\(K_{[c]}\)、\(V_{[c]}\),\(S_{[c]}\) 是这一块结束时的状态:
\[O_{[c]}=Q_{[c]}\,S_{[c-1]}+\operatorname{tril}\big(Q_{[c]}K_{[c]}^\top\big)\,V_{[c]},\qquad S_{[c]}=S_{[c-1]}+K_{[c]}^\top V_{[c]}\]图右取 \(C = 2\):
| 块 | 进入时的状态 | 块间项 \(Q_{[c]} S_{[c-1]}\) | 块内项 | 输出 | 结束时的状态 |
|---|---|---|---|---|---|
| 块 1(token 1、2) | (0, 0) | (0, 0) | (2, 5) | (2, 5) | (2, 3) |
| 块 2(token 3、4) | (2, 3) | (3, 5) | (1, 6) | (4, 11) | (7, 4) |
图右下角那个 2 × 2 的矩形是块 2 对块 1 的全部依赖。分块形式没有逐项算它,只读了一个状态 \(S_2 = (2, 3)\)。序列再长,每多一个块也只多算一个 \(C \times C\) 的三角和一次状态读写。
三种形式的成本如下,\(C = 1\) 时分块退化成递归,\(C = T\) 时退化成并行:
| 形式 | 串行步数 | 每 token 算量 | 中间量 | 用在哪 |
|---|---|---|---|---|
| 递归 | \(T\) | \(O(d_k d_v)\) | 一个状态 | decode |
| 并行 | 1 | \(O(T\,(d_k + d_v))\) | \(T \times T\) | 短序列 |
| 分块 | \(T / C\) | \(O(C\,(d_k + d_v) + d_k d_v)\) | 每块 \(C \times C\),块间一个状态 | 训练、prefill |
取中间值的理由在硬件。递归形式每步是逐元素的小运算,用不上 GPU 的矩阵乘单元,128K 的 prompt 要串行 131,072 步。分块后块内全是矩阵乘,串行的只剩块间那条状态链,\(C = 64\) 时是 2,048 步。GLA 讨论了这种面向 GPU 的分块实现;开源库 flash-linear-attention 的 Gated DeltaNet 分块算子默认取 \(C = 64\)。
delta rule 的分块多两步。 加法形式里每个 token 写入状态的是 \(v_t\) 本身,同一块内谁先写谁后写互不影响,块内可以直接并行。上一节的 delta rule 写入的是 \(u_t\),它依赖 \(S_{t-1}\):同一块里前面 token 的写入,会改变后面 token 读到的旧值。把这层依赖展开,块内的 \(u\) 满足一个 \(C \times C\) 的下三角方程组(\(i\)、\(j\) 是块内序号,\(\gamma_i = \prod_{j \le i} \alpha_j\) 是块内累计衰减):
\[u_i=\beta_i\Big(v_i-\gamma_i\,S_{[c-1]}^\top k_i-\sum_{j<i}\frac{\gamma_i}{\gamma_j}\,(k_j^\top k_i)\,u_j\Big)\]多出来的两步是:
- 算块内 \(KK^\top\) 的下三角,即上式里的 \(k_j^\top k_i\)。
- 解一次 \(C \times C\) 的三角方程组,得到整块的 \(u\)。
之后用 \(u\) 取代 \(v\)、乘上衰减因子,就回到上面的分块公式。DeltaNet 的并行化论文给出了完整推导。这两步都是 \(C \times C\) 的小矩阵运算,「块内并行、块间一条状态链」的结构不变。
4. 混合架构的已发表层比例
不少模型并非在“全层 full attention”和“全层线性 attention”之间二选一,而是周期性保留 full-attention 层:
| 模型 | 线性 / SSM 层 : full-attention 层 | 结构与来源 |
|---|---|---|
| Jamba | 7 : 1 | Mamba 与 Transformer attention 交错;技术报告 |
| MiniMax-01 | 7 : 1 | Lightning Attention 与 softmax attention 混合;论文 |
| Qwen3-Next | 3 : 1 | Gated DeltaNet 与 gated attention;官方说明 |
| Kimi Linear | 3 : 1 | KDA 与 MLA/full attention 混合;论文 |
比例是论文或官方配置中报告的层级配比,不代表不同模型的状态大小、质量或速度可以直接等同。MiniMax 后续在 M2 选择 full attention;官方解释强调,纸面上的高效 attention 不必然在复杂生产系统中胜过 full attention。
5. Qwen3-Next:128K 与 1M 的每序列状态估算
用官方 Qwen3-Next-80B-A3B-Instruct 配置估算单个序列的推理状态。配置给出 48 层、full_attention_interval = 4,即 12 层 full attention 与 36 层线性层;full-attention 的 num_key_value_heads = 2、head_dim = 256,线性状态字段为 32 个 value heads、key/value head dim 都是 128,权重 dtype 为 BF16(2 bytes)。这里仅计 KV 与线性 attention 的递归矩阵状态,不计卷积状态、权重、临时激活、框架与 allocator 开销。
对照组假设 48 层全部使用配置中的 full-attention KV 维度。每 token 的 KV 为:
\[b_{\text{KV}}=2 \times L_{\text{full}} \times n_{kv} \times d_h \times 2\text{ bytes}\]Qwen3-Next 混合配置:\(2 \times 12 \times 2 \times 256 \times 2 = 24{,}576\) bytes = 24 KiB/token;全层 attention 对照:\(2 \times 48 \times 2 \times 256 \times 2 = 98{,}304\) bytes = 96 KiB/token。
每个线性层的矩阵状态按 \(n_v d_k d_v \times 2\) bytes 估算,36 层合计:
\[36 \times 32 \times 128 \times 128 \times 2 =37{,}748{,}736\text{ bytes}=36\text{ MiB}\]| 上下文 | 全 48 层 attention KV | Qwen3-Next 12 层 full KV | 线性层矩阵状态 | 混合结构合计 |
|---|---|---|---|---|
| 128K(131,072) | 12 GiB | 3 GiB | 36 MiB | 3.04 GiB |
| 1M(1,048,576) | 96 GiB | 24 GiB | 36 MiB | 24.04 GiB |
1M 这一行只是按 24 KiB/token 线性外推;该配置的 max_position_embeddings 是 262,144,表格不表示模型配置支持 1M 上下文。递归状态不会随 \(T\) 变长,但长程信息被压进有限维状态,精确检索质量与 full attention 不等价。
prefill 的算量也分成两部分。36 层线性层走分块形式,每 token 算量与 \(s\) 无关,整段 prefill 对 \(s\) 是线性的。二次项只剩 12 层 full attention:第二章的二次项系数是 \(4dL\),这里 \(L\) 从 48 变成 12,是全层 attention 对照的 1/4。混合结构降低的是二次项的系数,阶没有变。
五、对 Infra 的影响汇总
把前几章的成本落到系统上,长上下文带来的影响集中在五处。先列成一张表,数字取 128K 的请求、H100、BF16:
| 影响 | Llama-3-8B | Llama-3-70B | 受影响的系统指标 | 应对 |
|---|---|---|---|---|
| 线性项:每请求 KV cache | 16 GiB | 40 GiB | 并发数上限 |
|
| 二次项:prefill 算量 | 6.5 PFLOP,attention 占 70% | 41 PFLOP,attention 占 55% | 每个长请求占用的算力 |
|
| TTFT(单卡,60% MFU) | 约 11 s | 约 69 s(单卡等效) | 首 token 延迟的下界 | 多卡并行处理同一个请求 |
| 一次性 prefill 独占 GPU | 约 11 s | 约 69 s(单卡等效) | 其他请求的 token 间延迟 | chunked prefill |
| 单请求的显存 | KV 16 GiB,每层 hidden state 1 GiB | KV 40 GiB,每层 hidden state 2 GiB | 单请求能否运行 | 序列并行(Ring Attention) |
线性项:KV cache 决定并发数。 每请求 KV cache \(= b \cdot L \cdot s\),Llama-3-70B 在 128K 是 40 GiB。给定显存预算,最大并发数与上下文长度成反比;这也是 PagedAttention(vLLM)按 block 而不是按最大长度预分配 KV 的原因——大多数请求用不满 128K,但只要允许 128K,静态分配就得按 128K 留。GQA(8B/70B 的 8 个 KV 头)与 MLA(DeepSeek-V3 的 68.6 KiB/token)是从模型结构上减这一项的系数。
二次项:prefill 算量。 128K 的 prefill 在 8B 上是 6.5 PFLOP、11 s,其中 attention 占 70%。这一项无法靠 batch 摊薄,因为它本身就是 compute-bound 的(算术强度远高于 ridge point)。减少它只能靠减少算量本身:滑窗、交错、稀疏,或者 prefix caching(同一个 system prompt 的 KV 只算一次)。
TTFT:单请求的算量下界。 用户感知的首 token 延迟至少等于 prefill 时间。一个 128K 请求在单卡 8B 上的 TTFT 按峰值算至少 6.6 s、按 60% MFU 经验估约 11 s,要压到 1 s 以内需要 7–11 张卡并行处理同一个请求——这是序列并行的动机之一。
chunked prefill 的必要性。 如果调度器让一个 128K 请求一次性 prefill,它会独占 GPU 约 11 s,期间所有正在 decode 的请求全部停顿——它们的 token 间延迟从几十毫秒跳到 11 s。chunked prefill(Sarathi,Agrawal 等 2023,其后续系统是 Sarathi-Serve;vLLM 默认启用,SGLang 默认也切块,但把 prefill 块与 decode 混进同一个 batch 的 enable_mixed_chunk 默认关闭)把长 prefill 切成若干个 chunk(例如每次 2K–8K token),每个调度步里让一个 prefill chunk 与若干 decode 请求拼成一个 batch。decode 请求的 KV 读取是 memory-bound、prefill chunk 是 compute-bound,两者拼在一起恰好能同时用满带宽与算力。代价是长请求自己的 TTFT 略微变长,换来其他请求的延迟稳定。两种调度下同一段时间内 GPU 上发生的事对比如下(P = 128K 请求的 prefill,D = 已在 decode 的请求各出一个 token):
序列并行 / context parallel 的动机。 当单个请求的 KV cache(70B 的 40 GiB)或激活(128K 时每层的 hidden state 就是 \(131072 \times 8192 \times 2\,\text{B} = 2\) GiB)放不进一张卡、或 TTFT 要求单请求必须由多卡并行时,就需要把序列维度切到多张卡上。TP 切的是 head 维度(《Attention 变体与 KV cache》的「GQA 与张量并行的边界」一节),每张卡仍要处理全部 \(s\) 个 token;序列并行切的是 token 维度,每张卡处理 \(s/P\) 个 token,但 attention 需要所有 token 的 K、V——Ring Attention(Liu 等 2023)让 K、V 块在卡之间环形传递,每张卡对每个到达的 K、V 块做一次局部 attention 并用 online softmax 合并。它引入了新的通信项(每层传一遍全部 K、V),是长上下文训练与超长请求推理的标准手段。
最后一个跨章节的提醒:位置编码的选择会限制以上所有手段,三处要在推理引擎里实现对:
- 滑窗与 sink 依赖”cache 内相对位置”的重新编号(第三章第 3 节)。
- YaRN 的温度要乘进 cos/sin 表。
- Llama 3.1 的分段缩放要在 kernel 之前的 inv_freq 计算里实现。
推理引擎里 rope_scaling 字段解析错误是长上下文精度问题的常见根源之一——数学上只差一个分段规则,效果上是 32K 之后 perplexity 是否发散。
六、实践:llm_cost.py 上下文长度扫描
在前几篇 llm_cost.py 的骨架上新增 context_scan(cfg, gpu, ctxs),输出”上下文长度 → KV cache、prefill FLOPs、attention 占比”:
from dataclasses import dataclass
from typing import Optional

@dataclass
class ModelConfig:
    name: str
    hidden: int
    layers: int
    n_heads: int
    n_kv_heads: int
    head_dim: int
    d_ff: int
    vocab: int
    tie_embeddings: bool = False
    mla_rank: Optional[int] = None   # MLA 的 d_c;None 表示 MHA/GQA
    rope_dim: Optional[int] = None   # MLA 解耦 RoPE 的 d_h^R

LLAMA3_8B = ModelConfig("Llama-3-8B", 4096, 32, 32, 8, 128, 14336, 128256)
LLAMA3_70B = ModelConfig("Llama-3-70B", 8192, 80, 64, 8, 128, 28672, 128256)

@dataclass
class GPU:
    name: str
    hbm_bytes: float
    bandwidth: float   # bytes/s
    bf16_flops: float  # FLOP/s

H100 = GPU("H100 SXM", 80e9, 3.35e12, 989e12)
A100 = GPU("A100 80GB", 80e9, 2.0e12, 312e12)

GiB = 2 ** 30

def param_count(cfg: ModelConfig) -> dict:
    """dense 模型参数量(《从 GPT-2 到 Llama》的公式,重给以便独立运行)。"""
    d, dh = cfg.hidden, cfg.head_dim
    attn = d * cfg.n_heads * dh + 2 * d * cfg.n_kv_heads * dh + cfg.n_heads * dh * d
    ffn = 3 * d * cfg.d_ff
    per_layer = attn + ffn + 2 * d
    emb = cfg.vocab * d
    head = 0 if cfg.tie_embeddings else cfg.vocab * d
    total = cfg.layers * per_layer + d + emb + head
    return {"per_layer": per_layer, "embedding": emb, "lm_head": head, "total": total}

def kv_bytes_per_token(cfg: ModelConfig, dtype_bytes: int = 2) -> int:
    """每 token 的 KV cache 字节数(《Attention 变体与 KV cache》),支持 MLA。"""
    if cfg.mla_rank is not None:
        return cfg.layers * (cfg.mla_rank + cfg.rope_dim) * dtype_bytes
    return 2 * cfg.layers * cfg.n_kv_heads * cfg.head_dim * dtype_bytes

def weight_flops_per_token(cfg: ModelConfig) -> float:
    """权重 GEMM 部分:每参数每 token 2 FLOPs,embedding 查表不计。"""
    p = param_count(cfg)
    return 2.0 * (p["total"] - p["embedding"])

def attn_flops_per_token(cfg: ModelConfig, ctx: int) -> float:
    """对上下文 ctx 做一次 attention(QK^T 与 PV):每层 4·d·ctx。"""
    return 4.0 * cfg.n_heads * cfg.head_dim * ctx * cfg.layers

def forward_flops_per_token(cfg: ModelConfig, ctx: int) -> float:
    """decode 一个 token、上下文 ctx 时的前向 FLOPs(《前向的算量与访存量》)。"""
    return weight_flops_per_token(cfg) + attn_flops_per_token(cfg, ctx)

def prefill_flops(cfg: ModelConfig, ctx: int, causal: bool = True) -> tuple:
    """一次 ctx 长度 prefill 的总 FLOPs,返回 (权重项, attention 项)。"""
    w = weight_flops_per_token(cfg) * ctx
    a = attn_flops_per_token(cfg, ctx) * ctx
    if causal:
        a /= 2
    return w, a

def context_scan(cfg: ModelConfig, gpu: GPU, ctxs, mfu: float = 0.6) -> None:
    """上下文长度 → KV cache、prefill FLOPs、attention 占比。"""
    kv = kv_bytes_per_token(cfg)
    w_tok = weight_flops_per_token(cfg)
    print(f"{cfg.name}: KV {kv/1024:.1f} KiB/token, weights {w_tok/1e9:.1f} GFLOPs/token")
    print(f"{'ctx':>8} {'KV cache':>10} {'prefill':>12} {'prefill@'+str(int(mfu*100))+'%':>12} "
          f"{'attn/token':>12} {'attn share':>10}")
    for s in ctxs:
        w, a = prefill_flops(cfg, s)
        t = (w + a) / (gpu.bf16_flops * mfu)
        a_tok = attn_flops_per_token(cfg, s)
        share = a_tok / (w_tok + a_tok)
        print(f"{s:>8d} {kv*s/GiB:>8.1f} G {(w+a)/1e15:>9.2f} PF {t:>10.2f} s "
              f"{a_tok/1e9:>9.1f} GF {share*100:>9.1f}%")

if __name__ == "__main__":
    for cfg in (LLAMA3_8B, LLAMA3_70B):
        context_scan(cfg, H100, [8192, 32768, 131072])
        print()
输出:
Llama-3-8B: KV 128.0 KiB/token, weights 15.0 GFLOPs/token
     ctx   KV cache      prefill  prefill@60%   attn/token attn share
    8192      1.0 G      0.14 PF       0.24 s       4.3 GF      22.2%
   32768      4.0 G      0.77 PF       1.30 s      17.2 GF      53.4%
  131072     16.0 G      6.47 PF      10.90 s      68.7 GF      82.1%

Llama-3-70B: KV 320.0 KiB/token, weights 139.0 GFLOPs/token
     ctx   KV cache      prefill  prefill@60%   attn/token attn share
    8192      2.5 G      1.23 PF       2.07 s      21.5 GF      13.4%
   32768     10.0 G      5.96 PF      10.05 s      85.9 GF      38.2%
  131072     40.0 G     40.74 PF      68.65 s     343.6 GF      71.2%
8B 的三列与第二章一致:128K 时 16 GiB、6.5 PFLOP、11 s、attention 占 82%。70B 的权重项脚本给出 139 GFLOPs(\(2 \times (70.55 - 1.05)\)B),正文沿用总纲取整的 141,差异 1.5%,不影响任何结论;70B 的 prefill 时间是”单卡等效”,实际至少要 2 张 H100 才放得下权重。要加 DeepSeek-V3,传入 mla_rank=512, rope_dim=64 即可得到 68.6 KiB/token 与 128K 的 8.6 GiB;它的权重 FLOPs 项需要 MoE 的字段(激活 37B → 74 GFLOPs,见《MoE 的路由、激活参数量与通信形态》的「DeepSeek-V3 的激活参数」一节),attention 项按 128 头、q/k 192 维、v 128 维手算是每层 \(2 \times 128 \times (192 + 128) \cdot s = 81920\,s\),61 层约 \(5.0 \times 10^6 \cdot s\)(未吸收的朴素形式)。
七、本文小结
上下文长度是对 Infra 成本最敏感的维度。本篇的结论:
- 长上下文的成本有一个线性项(KV cache)、一个二次项(prefill 的 attention)和一个不能物化的中间量(\(s \times s\) logits)。Llama-3-70B 128K 每 token attention 344 GFLOPs 超过权重 141 GFLOPs;Llama-3-8B 128K prefill 6.5 PFLOP、60% MFU 约 11 s。滑窗让单序列 KV 与每步 decode attention 限于 \(O(W)\),整段 prefill attention 则由 \(O(s^2)\) 变成 \(O(sW)\) 但丢信息;全局/局部交错把系数变成 \(1/k\);sink + 滑窗让 full attention 模型能流式运行;MLA 减 KV 的系数不改阶。
- 线性 attention 与 SSM 把历史压入固定大小的递归状态;混合架构用周期性的 full-attention 层保留直接访问路径。同一个线性 attention 有递归、并行、分块三种等价算法:decode 用递归,训练与 prefill 用分块,块内是 \(C \times C\) 的矩阵乘,块间只传一个状态,128K 的 prompt 在 \(C = 64\) 时串行 2,048 步而不是 131,072 步。按 Qwen3-Next 配置估算,BF16 下 128K 的 full KV 对照为 12 GiB,混合结构的 full KV 加矩阵状态约 3.04 GiB;1M 行是超出配置最大位置后的外推,不代表原生支持。
- 对 Infra:KV cache 决定并发数,prefill 二次项决定 TTFT 下界,chunked prefill 是为了不让一个 128K 请求独占 GPU 11 s,序列并行是为了把单请求的 KV、激活与 TTFT 分到多卡。
本篇算出的数字汇总(theoretical,BF16,H100 60% MFU):
| 指标 | 上下文 | Llama-3-8B | Llama-3-70B | DeepSeek-V3 |
|---|---|---|---|---|
| 权重 FLOPs/token | 15.0 GFLOPs | 141 GFLOPs | 74 GFLOPs | |
| KV bytes/token | 128 KiB | 320 KiB | 68.6 KiB | |
| KV cache | 8K / 32K / 128K | 1.0 / 4.0 / 16 GiB | 2.5 / 10 / 40 GiB | 0.54 / 2.1 / 8.6 GiB |
| attention FLOPs/token | 8K | 4.3 GFLOPs | 21.5 GFLOPs | 41 GFLOPs |
| 32K | 17.2 GFLOPs | 85.9 GFLOPs | 164 GFLOPs | |
| 128K | 68.7 GFLOPs | 344 GFLOPs | 655 GFLOPs | |
| attention 占比 | 8K / 32K / 128K | 22% / 53% / 82% | 13% / 38% / 71% | 36% / 69% / 90% |
| prefill FLOPs | 8K / 32K / 128K | 0.14 / 0.77 / 6.5 PF | 1.24 / 6.0 / 41 PF | — |
| prefill 时间(单卡等效) | 128K | 约 11 s | 约 69 s | — |
| attention = 权重 的交叉点 | 约 28.6K | 约 53.8K | — |
DeepSeek-V3 的 attention FLOPs 按未吸收的朴素形式(128 头、q/k 192 维、v 128 维)计算,吸收后的形式访存更少但 FLOPs 更高,《Attention 变体与 KV cache》的「吸收后的算量与访存」一节有讨论;它的 prefill 总量需要《MoE 的路由、激活参数量与通信形态》的激活参数量才能完整给出。
配套代码:transformer-and-llm/llm_cost_04_long_context.py;RoPE 的 NumPy 实现与三种缩放的波长表在 rope_numpy.py。
八、自测
-
Llama-3-8B、128K 上下文:每 token 的 attention FLOPs 与权重 FLOPs 各多少?attention = 权重的交叉点在哪?
答案
attention 68.7 GFLOPs、权重 15.0 GFLOPs(82% 是 attention);交叉点约 28.6K token。
-
一个 128K 的请求在单卡 H100 上 prefill 要多久?这个数字对推理系统意味着什么?
答案
6.5 PFLOP / (989 T × 60% MFU) ≈ 11 s(峰值下 6.6 s 才是物理下界,60% 是经验效率);且这 11 秒里 GPU 被一个请求独占——chunked prefill 与序列并行就是为它设计的。
-
按 Qwen3-Next 配置,128K 时 full-attention KV 与混合结构(full KV + 线性矩阵状态)各约多少?1M 数字意味着模型原生支持 1M 吗?
答案
全层 attention 对照约 12 GiB;混合结构 12 层 KV 约 3 GiB,加 36 层递归矩阵状态 36 MiB,合计约 3.04 GiB。1M 是按 KV 公式外推,配置的
max_position_embeddings为 262144,不能据此说原生支持 1M。 -
Mistral 7B 的滑窗 \(W = 4096\),KV 用环形缓冲区存。位置 10000 的 token 写到哪个槽?它覆盖的是哪个位置的 K、V?
答案
槽 \(10000 \bmod 4096 = 1808\);这个槽上一次写的是位置 \(10000 - 4096 = 5904\),正好是刚滑出窗口的那个 token。见第三章第 1 节。
-
Gemma-3-27B 一个 128K 请求,KV cache 约多少?若 62 层全用 full attention 又是多少?大头在哪里?
答案
交错后约 10.4 GiB(10 层 full attention 10 GiB + 52 层窗口 1024 的局部层 416 MiB);全 full attention 是 62 GiB。大头几乎全在 10 层 full attention 层,局部层与上下文长度无关。见第三章第 2 节。
-
第四章的手算例里,把 token 3 的 \(q_3\) 从 (0, 1) 改成 (1, 0),分块形式(\(C = 2\))下 \(o_3\) 的块间项、块内项各是多少?一个 131,072 token 的 prompt 取 \(C = 64\),串行步数是多少?
答案
块间项 \(q_3^\top S_2 = (1, 0) \cdot (2, 3) = 2\),块内项 \((q_3^\top k_3)\,v_3 = 1 \times 1 = 1\),\(o_3 = 3\)(与递归形式的 \(q_3^\top S_3 = (1, 0) \cdot (3, 4) = 3\) 相同)。串行步数是 \(131072 / 64 = 2048\),递归形式是 131,072。见第四章第 3 节。
-
贵在三处:KV cache 随 \(s\) 线性增长(Llama-3-8B 128K 一个请求 16 GiB,与权重一样大),决定并发数;prefill 的 attention 随 \(s^2\) 增长(8B 128K 约 6.5 PFLOP,单卡 60% MFU 约 11 s,attention 占 70%),决定 TTFT;\(s \times s\) 的 logits 128K 时单头 32 GiB,只能靠 FlashAttention 不物化。详见第二章。 ↩
-
滑窗把单序列 KV 与每步 decode attention 从 \(O(s)\) 改成 \(O(W)\),整段 prefill attention 从 \(O(s^2)\) 改成 \(O(sW)\),但窗口外的信息只能逐层间接传递;全局/局部交错不改阶,只把系数变成全局层占比 \(1/k\);sink + 滑窗让 full attention 训练的模型能稳定处理流式输入,代价同滑窗;块稀疏减算量但一般不减 KV,并引入不规则访存。MLA 改的是 KV 的系数而非阶,可与上面叠加。详见第三章。 ↩
-
不用。线性 attention 有三种结果相同的算法:递归(一步一个 token,串行 \(T\) 步,只存一个状态)、并行(\(\operatorname{tril}(QK^\top)V\) 一次矩阵乘,中间量 \(T \times T\))、分块(块内用并行、块间用递归,串行 \(T / C\) 步)。decode 用递归;训练与 prefill 用分块,131,072 token 取 \(C = 64\) 时串行 2,048 步,块内全是矩阵乘。delta rule 的分块在块内多算一个 \(KK^\top\) 下三角、多解一次 \(C \times C\) 三角方程组,结构不变。详见第四章。 ↩
系列 《现代 LLM 结构:从 GPT-2 到今天的演进》 第 5 / 11 篇 进阶
系列总览 — 为什么这样组织、读它需要什么、读完能做什么 · 幻灯片 — 整个系列的精华,一份可分享的 deck
学习地图 — AI-Infra 工程师学习地图 第 5 / 14 个系列 · AI 算法工程师学习地图 第 6 / 12 个系列
上一篇:Attention 变体与 KV cache下一篇:MoE 的路由、激活参数量与通信形态
下一个系列:GPU Kernel 工程:从 CUDA 执行模型到 FlashAttention 深入 · 12 篇,约 5.0 小时
本文由 arganzheng 创作,采用 CC BY 4.0 许可协议。在保留原文作者、署名以及完整原文链接(https://arganzheng.life/long-context-cost-and-structural-remedies.html)的前提下,欢迎各种形式的转载、翻译或商业引用。
COMMENTS
评论存放在 GitHub Discussions, 用 GitHub 账号登录即可发表,支持 Markdown。 想针对正文某句话说?选中那段文字,点浮出的「评论」即可划线评论;觉得哪里写错了,发表时勾上「同时提交 Issue」。 有人回复你时 GitHub 会按你的通知设置发邮件,不用守在这里。