系列 《大规模训练工程:从并行策略到容错恢复》 第 5 / 12 篇 深入
系列总览 — 为什么这样组织、读它需要什么、读完能做什么 · 幻灯片 — 整个系列的精华,一份可分享的 deck
学习地图 — AI-Infra 工程师学习地图 第 8 / 14 个系列
- 训练任务的状态解剖——显存账与 MFU
- 并行策略全景——每种并行切的是哪种状态
- Megatron-LM——按模型结构切的架构与源码导读
- DeepSpeed——从优化器状态切起的架构与源码导读
- torchtitan——用 PyTorch 原生原语组合并行的架构与源码导读
- 三个框架对比——Megatron-LM、DeepSpeed 与 torchtitan
- 千卡配置实战——并行搭配、micro-batch、激活重计算与 MFU 调优
- 分布式 checkpoint——格式、异步保存与重分片恢复
- 容错与弹性——故障率数学、straggler、SDC 与弹性训练
- 训练稳定性与数据管线——loss spike、梯度范数、数据混合与流式加载
- 长时训练的可观测与运维——从指标到 hang 排查
- 系列总结与通关自测
上一篇:DeepSpeed——从优化器状态切起的架构与源码导读下一篇:三个框架对比——Megatron-LM、DeepSpeed 与 torchtitan
说明
本文按 torchtitan v0.3.0 的源码路径讲解;该版 release 验证 PyTorch 2.14.0,本文的 CPU/gloo 玩具在 PyTorch 2.14.1 上运行。
上一篇(02《并行策略全景》)给出每参数 16 字节与各并行维度的通信账。本篇沿同一条 bf16 参数的生命线读 torchtitan v0.3.0:常驻的是 fp32 Shard(0) DTensor 分片,bf16 只在每层计算期间临时出现。参数通信由 FSDP hook 与 DTensor placement 驱动。三个框架并排的对照在 06《三个框架对比》,本篇只读 torchtitan。
一个 bf16 参数在 torchtitan 里存在哪里、什么时候被 all-gather、什么时候被释放、它的 fp32 主副本在哪张卡上?1
一、总览
先看 train-ledger 的 8 卡配置:FSDP 4 × TP 2,开启 sequence parallel(SP),不启用 PP。FSDP 的 dp_shard 组沿四张卡切分,TP 组两张卡配对。F1 画出这张网格,以及某一层 unshard 之后的参数形态。
同一列的两张卡组成 TP 组。开了 SP 之后,TP 组内的通信是激活的 all-gather 与 reduce-scatter:colwise_config() 让输出按最后一维切,rowwise_config(output_sp=True) 把 Partial 输出 reduce-scatter 成序列维分片(不开 SP 才是 all-reduce)。同一行的四张卡组成 dp_shard 组,负责参数 all-gather 与梯度 reduce-scatter。每张 rank 常驻该 TP 矩阵切片在四个 dp_shard rank 中的一份 fp32 DTensor 参数、fp32 梯度以及 Adam 的 \(m,v\)。norm 参数在 TP 维复制,不再按 TP 切;16 层各两个 norm 加最终 norm 共 67,584 个参数,只占 tied 总量 \(N\) 的约 0.0055%。
一个 step 可以按五步读:
Trainer.__init__在 meta 设备构造模型;parallelize_llama()把 TP 与 FSDP 的分片信息放进 DTensor,此时仍没有参数存储;to_empty()才按本 rank 的分片形状分配内存,随后初始化。- 前向到某层时,FSDP hook 沿
dp_shardall-gather 参数分片,并把完整参数从 fp32 转成 bf16;TP 维仍只保留本 rank 的矩阵半片。 - Linear 用临时 bf16 参数计算;前向结束后
reshard()释放完整参数,回到 fp32 分片。 - 反向前再 unshard 一次;梯度按 fp32 reduce-scatter 回各 rank 的分片,完整 bf16 参数与梯度释放。
- AdamW 在本地 fp32 分片上更新。更新结果已经是参数分片,不需要再做一次 all-gather;下个 step 前向时按需取回。
先定义字节账里的符号:\(N\) 是 tied 后的模型参数总数,\(N_d=4\) 是 FSDP dp_shard 度数,\(N_t=2\) 是 TP 度数。Llama 3.2 1B 的 _1b() 显式设置 enable_weight_tying=True,所以 embedding 与 lm_head 共用权重。按实际形状求和后 \(N=1,235,814,400\);03、04 使用未绑定 embedding/head 的 \(1,498,482,688\),差值正是词表矩阵 \(128256\times2048\)。set_decoder_sharding_config() 把 tok_embeddings 与 lm_head 的 weight 都声明为 TP S(0),这块共享词表矩阵计入下面的 TP 切分部分。
每个由 TP 切开的参数元素,在每张卡上对应 fp32 参数 4 字节、fp32 梯度 4 字节、Adam 的 \(m,v\) 共 8 字节。01《状态解剖》的混合精度字节账推导了 16 字节这个系数。因此 TP 切开的主要参数,每卡常驻:
- fp32 参数分片:\(4(N-N_r)/(N_dN_t)\) 字节。
- fp32 梯度分片:\(4(N-N_r)/(N_dN_t)\) 字节。
- Adam 的 \(m,v\):\(8(N-N_r)/(N_dN_t)\) 字节。
- TP 复制、只沿
dp_shard切分的 norm 状态:\(16N_r/N_d\) 字节。
这里 \(N_r=67,584\) 是 TP 复制的 norm 参数数。总量为 \(16(N-N_r)/(N_dN_t)+16N_r/N_d\),约 2.472 GB(2.303 GiB)/卡;若把 norm 也近似当成 TP 切分,误差约 0.135 MB/卡。
一个 Transformer 层有 60,821,504 个参数,其中 attention / FFN 矩阵经 TP 切半,norm 在 TP 间复制。某 rank 在该层 unshard 后临时持有约 30.41M 个 bf16 参数,约 60.8 MB;这是完整 dp_shard 维、仍为 TP 半片的参数。prefetch 还可能让下一层的参数提前进入显存。
二、来龙去脉
这条路线从张量如何描述分布开始,后来才有 FSDP2 和把原语组合起来的训练框架。表中的时间按论文、官方发布文章与 release 页面核对。
| 年 / 版本 | 谁 | 当时的问题 | 怎么解决 | 效果 | 引入或遗留的问题 |
|---|---|---|---|---|---|
| 2022-08 | PyTorch 分布式团队 | Tensor Parallel、FSDP 等各自描述张量分布,组合起来难以表达 | DTensor RFC提出 SPMD 张量、Shard / Replicate 等布局原语 | 张量操作可以携带分布语义 | 当时仍是实验 API,API 与算子覆盖持续演进 |
| 2023-03 | PyTorch | 需要在框架里试验张量分片与复制的组合 | PyTorch 2.0以 prototype 形式发布 DTensor 与基于 DTensor 的 TP | DTensor 进入 PyTorch 正式版本线 | DeviceMesh 尚未成为统一的进程组入口 |
| 2023-04 | Meta / PyTorch FSDP 团队 | 单卡复制完整模型状态限制模型规模,传统并行方案组合复杂 | FSDP 经验论文总结按数据并行 worker 分片的 FSDP1 | 论文展示大模型训练的扩展性与性能 | FSDP1 把参数拍平为 FlatParameter,和 TP、优化器状态及 checkpoint 的组合需要额外适配 |
| 2024-01(PyTorch 2.2) | PyTorch | 手工维护多组 ProcessGroup,维度与 rank 编号容易错位 | PyTorch 2.2加入 beta torch.distributed.device_mesh,用 n 维数组表示设备拓扑与进程组 |
同一个 mesh 可按轴取 TP、DP 等子组 | mesh 的轴顺序仍需由调用方正确指定 |
| 2024-07(PyTorch 2.4) | PyTorch | FlatParameter 难组合;通用 PP 也缺少可复用 API | PyTorch 2.4以 prototype 发布 FSDP2 的 fully_shard 与 torch.distributed.pipelining |
每参数 DTensor 分片、FSDP 与 TP / PP 更容易组合 | 当时仍属 prototype,版本兼容与 API 细节会变化 |
| 2024-10 | PyTorch / Meta | 并行库、训练 recipe 与工程组件分散,组合和维护成本高 | TorchTitan 论文介绍 PyTorch 原生的模块化训练系统 | 以单仓库 recipe 组合多维并行、日志、checkpoint 与调试工具 | 它是参考实现和实验平台,不替代 PyTorch 底层并行原语 |
| 2025-06(v0.1.0) | TorchTitan 团队 | 需要有版本号的首个可安装发布 | v0.1.0 release发布第一个预发布包 | 开始以 release train 管理依赖与功能 | 仍为 pre-release,依赖 nightly PyTorch |
| 2025-10(v0.2.0) | TorchTitan 团队 | 新模型与 recipe 继续增长,需要扩展发布内容 | v0.2.0 release扩展支持并更新依赖 | release 页面给出明确 PyTorch / torchao 版本 | 模型、后端与配置仍快速演进 |
| 2026-09(v0.3.0) | TorchTitan 团队 | 并行配置需要可组合、可校验;模型支持继续扩展 | v0.3.0 release将 spmd_types 设为默认后端,引入声明式 ShardingConfig 路径并扩展模型与 recipe |
默认路径描述参数与 activation 的 sharding contract,可选类型检查 | 需要理解其 SPMD layout 与 backend 的适用边界 |
这几步是底层抽象逐渐统一的过程:DTensor 描述张量怎么分,DeviceMesh 描述 rank 怎么排,fully_shard 管参数生命周期,TorchTitan 把它们接进训练器。
三、核心抽象
torchtitan 的调用链从用户配置向下进入模型并行化、FSDP 与张量布局。F2 的箭头从上层指向下层,表示「上层调用 / 依赖下层」。
- 配置函数返回
Trainer.Config,由第四章的运行配置选中。 Trainer负责装配组件、训练 step 与 checkpoint,见第六章第 1、7 节。parallelize_llama()、ShardingConfig、pipeline_llm()描述模型级 TP / SP / CP / PP,见第六章第 3、5 节。fully_shard()、FSDPState、FSDPParamGroup与PipelineStage管理参数和 stage,见第六章第 4、5、6 节。DTensor与 placement 表示张量分布,redistribute()根据布局变化触发通信,见下方 F3。DeviceMesh把 mesh 轴映射到 rank 与进程组,见第五章。ProcessGroup执行 all-gather、reduce-scatter、all-reduce 等 collective。
可以把 DTensor 想成「带着座位图的 Tensor」:Tensor 记录数值,DeviceMesh 记录 rank 网格,placement 记录每一维是切片、复制还是部分和。F3 用 4×4 编号张量展示三种布局;箭头表示 redistribute() 触发的通信。
玩具输出中,Shard(0) 把 W 的四行分给两个 rank,各持两行;Replicate 让每个 rank 都看到完整 W;Partial 的每 rank 本地张量只含自己的部分和,合并后恢复 W。Shard(0) → Replicate 对应 all-gather,Partial → Replicate 对应 all-reduce,Partial → Shard(0) 对应 reduce-scatter。toy 的最后一步就是 partial.redistribute(placements=[Shard(0)]):两个 rank 的部分和经 reduce-scatter 后,各自拿回与 Shard(0) 分片一致的 2×4 本地块。
四、最小任务:runs/titan
train-ledger 里的练手配置是 FSDP 4 × TP 2,模型取 Llama 3.2 1B 的形状(16 层、\(h=2048\)、32 个 attention 头 / 8 个 K/V 头、FFN 8192、词表 128256、序列长 \(s=8192\))。06 的 train-ledger 对账里 Megatron、DeepSpeed 两份按未绑定 embedding/head 的参数数计,torchtitan 行与本篇一样按 v0.3.0 _1b() 的 tied 配置计数。以下保留配置函数,键名来自 torchtitan v0.3.0:
"""train-ledger / runs/titan/ledger_llama3_1b.py -- Llama 3.2 1B shape, 8 GPUs: FSDP 4 x TP 2.

Run from the torchtitan repo root:
    NGPU=8 MODULE=runs.titan.ledger_llama3_1b CONFIG=llama3_1b_fsdp4_tp2 ./run_train.sh
"""
from torchtitan.components.loss import ChunkedLossWrapper, CrossEntropyLoss
from torchtitan.components.metrics import MetricsProcessor
from torchtitan.components.optimizer import default_adamw, LRSchedulersContainer
from torchtitan.config import ParallelismConfig, TrainingConfig
from torchtitan.distributed.activation_checkpoint import SelectiveAC
from torchtitan.hf_datasets.text_datasets import HuggingFaceTextDataLoader
from torchtitan.models.common.config_utils import decoder_vocab_size
from torchtitan.models.llama3 import model_registry
from torchtitan.tools.profiler import Profiler
from torchtitan.trainer import Trainer


def llama3_1b_fsdp4_tp2() -> Trainer.Config:
    model_spec = model_registry("1B")            # 16 layers, dim 2048, 32/8 heads, ffn 8192, vocab 128256
    return Trainer.Config(
        model_spec=model_spec,
        loss=ChunkedLossWrapper.Config(
            loss_fn=CrossEntropyLoss.Config(global_vocab_size=decoder_vocab_size(model_spec)),
        ),
        hf_assets_path="./tests/assets/tokenizer",
        optimizer=default_adamw(lr=3e-4, weight_decay=0.1),
        lr_scheduler=LRSchedulersContainer.Config(warmup_steps=10, decay_type="cosine", min_lr_factor=0.1),
        training=TrainingConfig(
            local_batch_size=2,                  # x FSDP 4 = global batch 8 sequences of 8192 tokens
            seq_len=8192,
            steps=50,
            dtype="float32",                     # sharded params stay fp32 = master copy
            mixed_precision_param="bfloat16",    # all-gather / compute in bf16
            mixed_precision_reduce="float32",    # reduce-scatter in fp32
        ),
        parallelism=ParallelismConfig(
            data_parallel_shard_degree=4,
            tensor_parallel_degree=2,
            enable_sequence_parallel=True,
            fsdp_reshard_after_forward="default",   # no PP -> reshard after forward -> 3N
        ),
        dataloader=HuggingFaceTextDataLoader.Config(dataset="c4_test"),
        activation_checkpoint=SelectiveAC.Config(),
        metrics=MetricsProcessor.Config(log_freq=1, enable_tensorboard=True, save_tb_folder="tb/titan"),
        profiler=Profiler.Config(enable_profiling=True, profile_freq=20, profiler_warmup=1, profiler_active=2),
    )
字段按用途分组读:
- 并行度:
data_parallel_shard_degree=4与tensor_parallel_degree=2用满 8 卡;SP 开启;没有 PP;不指定 PP 时fsdp_reshard_after_forward="default"解析为前向后 reshard。 - 精度:分片参数与主参数保持 fp32;前向 all-gather 后按
mixed_precision_param转 bf16;梯度归约使用 fp32。 - 批次:每个 DP 副本的
local_batch_size=2,序列长 8192;四路 FSDP 对应每步 8 条序列,训练 50 步。 - 优化与数据:AdamW 学习率 3e-4、weight decay 0.1;warmup 10 步后 cosine decay;数据集
c4_test。 - 记录:每步写 TensorBoard;第 20 步附近采 profiler trace。
MetricsProcessor.log()同时调用DeviceMemoryMonitor.get_peak_stats(),记录max_active_gib、max_reserved_gib与num_alloc_retries。
五、进程组:ParallelDims 与 DeviceMesh
8 张卡时,先问「哪几张卡一起做 TP,哪几张卡一起做 FSDP all-gather?」ParallelDims.build_mesh() 把 1D world rank 展开为 4×2 网格,mesh 轴顺序是 ("dp_shard", "tp"),TP 在最内维。toy mesh 用 PyTorch API 创建同一张网格,打印每张卡坐标和进程组:
rank 0: dp_shard=0 tp=0       rank 1: dp_shard=0 tp=1
rank 2: dp_shard=1 tp=0       rank 3: dp_shard=1 tp=1
rank 4: dp_shard=2 tp=0       rank 5: dp_shard=2 tp=1
rank 6: dp_shard=3 tp=0       rank 7: dp_shard=3 tp=1

TP groups:        [0,1] [2,3] [4,5] [6,7]
dp_shard groups:  [0,2,4,6] [1,3,5,7]
同一行是 TP 组,同一列是 dp_shard 组。toy 的实际输出会先列出 rank 0 所在组,再按行列列出完整矩阵;上面把每组压成一行方便对照。
ParallelDims 是从 ParallelismConfig 构造的 dataclass。它保存 dp_replicate、dp_shard、cp、tp、pp、ep 与 world_size;当 data_parallel_shard_degree=-1 时,用 world size 除以其它并行度推导。_validate() 检查各维乘积等于 world size。
build_mesh() 先以 init_device_mesh(device_type, (world_size,), mesh_dim_names=("world",)) 建 1D world mesh,再用 DeviceMesh._unflatten() 按不同轴顺序生成多张视图。大小为 1 的轴可用 backend_override[name]="fake" 避免创建无用 communicator;_mesh_exist() 会保留 FSDP 需要的轴。
| Mesh 视图 | 轴与维度 | rank 语义 | 用途 |
|---|---|---|---|
dataloading_mesh |
("pp", "batch", "cp", "tp");batch=dp_replicate×dp_shard |
PP、batch、CP、TP 坐标决定各 rank 读到的数据 | 数据加载与 batch 分发 |
loss_mesh |
dataloading_mesh["batch", "cp"]._flatten() |
合并切数据的 batch 与 CP rank | loss 的全局 token 归约 |
dense_mesh |
("pp", "dp_replicate", "dp_shard", "cp", "tp") |
dense 参数按 dp_shard(与 CP)分片 |
fully_shard 与 dense 参数 |
sparse_mesh |
("pp", "dp_replicate", "efsdp", "ep");efsdp=dp_shard×cp×tp/ep |
专家并行与专家 FSDP | MoE 专家参数 |
不同视图共享底层 world rank,但轴顺序不同。
get_mesh("tp")、get_optional_mesh("pp")与get_mesh(["dp_replicate", "dp_shard"])按轴名取子网格,并行模块再用mesh.get_group()取得对应 ProcessGroup。
源码细节:ParallelDims 如何展开与 TP 最内维的 rank 顺序
build_mesh() 的 _unflatten() 维度顺序决定 rank 排布。TP 在最内维时,rank 0、1 配对,rank 2、3 配对;跨行取同列得到 [0,2,4,6] 与 [1,3,5,7]。与 Megatron 的 "tp-cp-ep-dp-pp" 相比,这里不需要全局 rank 枚举器:DeviceMesh 的轴索引描述进程组。
v0.3.0 新增 spmd_backend:"partial_dtensor" | "full_dtensor" | "spmd_types",默认 "spmd_types"。它决定 build_mesh() 要创建哪些视图,以及第六章第 3 节的 TP 路径。三种后端不改变进程组的 rank 排布。
六、源码导读:用原生原语组合
1. 目录地图
先看一次训练会经过哪些目录。之后每节只沿一个问题往下读。
torchtitan/
  train.py                             main():ConfigManager 解析 --module / --config → Trainer(config).train()
  trainer.py                           Trainer:__init__ 装配、train_step、train
  config/
    configs.py                         TrainingConfig、ParallelismConfig、CompileConfig、CommConfig、DebugConfig
    configurable.py / manager.py       Configurable 基类;Config.build() 构造组件;ConfigManager
  distributed/
    parallel_dims.py                   ParallelDims、MeshAxisName、SpmdLayout
    fsdp.py                            apply_fsdp_to_decoder、get_fsdp_reshard_after_forward_policy
    tensor_parallel.py                 NoParallel;主 TP 路径在 protocols/ 与 models/common/
    pipeline_parallel.py               pipeline_llm、_build_pipeline_schedule、_pipeline_module_split
    context_parallel/api.py            apply_cp_to_forward、prepare_context_parallel_input、cp_shard
    activation_checkpoint.py           FullAC、SelectiveAC
    compile.py / cudagraph.py          torch.compile 与 CUDA graph 包装
    full_dtensor.py                    resolve_fsdp_mesh、validate_config
    spmd_types.py                      spmd_types 后端的辅助函数
    utils.py                           init_distributed、set_determinism、clip_grad_norm_、dist_sum / dist_max、set_pg_timeouts
  protocols/
    module.py                          Module.parallelize()、_distribute_states()、输入输出 redistribute
    sharding.py                        ShardingConfig、LocalMapConfig、resolve_placements
    model.py / model_spec.py           BaseModel、ModelSpec、parallelize_fn、pipelining_fn、state_dict_adapter
  models/
    common/                            attention、moe、embedding、linear、decoder_sharding(TP/SP)、moe_sharding
    llama3/                            model_registry、model、parallelize、sharding、config_registry
  components/
    checkpoint.py + checkpointer/      CheckpointManager;DCP 与 torch.save 后端
    optimizer/                         OptimizersContainer、default_adamw、LRSchedulersContainer
    dataloader.py / hf_datasets/       BaseDataLoader、HuggingFaceTextDataLoader
    metrics.py                         MetricsProcessor、DeviceMemoryMonitor、TensorBoard / W&B logger
    loss.py                            CrossEntropyLoss、ChunkedLossWrapper
    validate.py                        Validator
  tools/profiler.py                    Profiler、MemoryProfiler
  experiments/                         torchft、autoparallel 等
v0.3.0 中没有 components/data/,相关代码分在三处:
- 数据加载器:
components/dataloader.py与hf_datasets/; - checkpoint:
components/checkpoint.py与components/checkpointer/; - metrics:
components/metrics.py,另有observability/目录。
2. Trainer.init:装配顺序就是架构
meta 构造的价值不在于「省几次分配」,而在于参数第一次获得真实存储时,已经知道自己属于哪张卡。F4 把这个时序与 toy 实测的每 rank 参数字节放在一起。
玩具模型只有 7,168 个逻辑参数。meta 与 fully_shard 之后都没有参数存储;to_empty() 后每 rank 有 14,336 B 的 fp32 参数分片。首次 AdamW step 后,toy 观测到 m、v 共 57,344 B;图里最后一格把参数与 m/v 合计为 71,680 B。真实 Llama 3.2 1B 的数字见总览,不能把 toy 的绝对字节数当成生产模型显存。
Trainer.__init__ 的执行顺序如下:
Trainer.__init__(config: Trainer.Config)
  init_distributed()                             dist_utils.init_distributed(config.comm) → ParallelDims.from_config(config.parallelism, world_size)
                                                 → parallel_dims.build_mesh()(第五章)
  set_determinism()
  model_config.build()  在 torch.device("meta") 下   模型只有形状,没有内存;dtype = training.dtype(默认 float32)
  metrics_processor = config.metrics.build()
  loss_fn = config.loss.build()
  gradient_accumulation_steps = global_batch_size / (local_batch_size × batch_degree)
  if pp_enabled:
    pp_schedule, model_parts, ... = model_spec.pipelining_fn(model, parallel_dims, ..., parallelize_fn=model_spec.parallelize_fn)
                                                 → pipeline_llm:切 module、每个 stage 建 PipelineStage、对每个 model part 调 parallelize_fn
  else:
    model = model_spec.parallelize_fn(model, parallel_dims, ...)      → parallelize_llama:TP/CP → AC → compile → FSDP
    model_parts = [model]
  for m in model_parts: m.to_empty(device); m.init_weights()          此时才分配显存、初始化——已经是分片后的形状
  optimizers = config.optimizer.build(model_parts)                    OptimizersContainer:每个 model part 一个 torch 优化器
  lr_schedulers = config.lr_scheduler.build(optimizers)
  tokenizer / dataloader = config.dataloader.build(dp_world_size=batch_degree, dp_rank=batch_rank, ...)
  checkpointer = config.checkpoint.build(dataloader, model_parts, optimizers, lr_schedulers, states={"train_state": self})
  train_context = dist_utils.get_spmd_context(parallel_dims)
有两个顺序上的结果。meta → 并行化 → to_empty → init_weights,避免先在单卡物化完整模型;405B 也可以先构造形状,再分配各 rank 的 shard。并行化在优化器之前,所以优化器拿到的已经是 DTensor 分片,AdamW 的逐元素更新在本地完成。
Trainer.Config 是配置树根。metrics、loss、optimizer、dataloader、checkpoint、profiler、activation_checkpoint、validator 都是有内嵌 Config dataclass 的 Configurable 组件;Config.build(...) 构造实例。torchtitan/config/configs.py 放无组件归属的 TrainingConfig、ParallelismConfig 等字段。一次运行就是一个返回 Trainer.Config 的 Python 函数,例如 models/llama3/config_registry.py 的 llama3_debugmodel();--module llama3 --config llama3_debugmodel 选中它。
3. TP:从 ParallelStyle 到 ShardingConfig
02 的列切、行切与 f/g 共轭图先画出矩阵和反向通信。torchtitan v0.3.0 默认的 spmd_types 与 full_dtensor 后端保留相同的并行语义,但把切分方案写进模型的 sharding 配置。
- 切什么:
torchtitan/protocols/sharding.py的ShardingConfig描述参数 / buffer placement、输入和输出的 source / destination placement,以及可选的local_map。SpmdLayout按 mesh 轴名描述布局,例如{DP: R, CP: R, TP: S(0)}。 - 方案在哪:
models/common/decoder_sharding.py的colwise_config()把权重按 0 维切、输出按最后一维切;rowwise_config(output_sp=...)把权重按 1 维切,输出从Partial转为Replicate(all-reduce)或Shard(1)(reduce-scatter,也就是 SP)。norm_config()、set_gqa_attention_sharding()、set_dense_ffn_sharding()与set_decoder_sharding_config()组合出 decoder 方案。Llama 3 的set_llama3_sharding_config()把这些配置挂到具体子模块。 - 谁执行:
protocols/module.py的Module.parallelize(parallel_dims)递归调用_distribute_states(),用distribute_tensor()把参数变为 DTensor,再包装 forward 的输入 / 输出 redistribute。通信由布局变化推导;SPMD 类型检查可在开发时验证 source / destination placement。
因此 TP 的实现不在 distributed/tensor_parallel.py(v0.3.0 只留 NoParallel 风格类),而在 protocols/ 与 models/common/。partial_dtensor 后端保留旧路径;默认 spmd_types 路径将模型并行方案与模型结构分开表达。
4. FSDP2:apply_fsdp_to_decoder
FSDP2 这一层要回答两个问题:参数什么时候从分片变完整,什么时候恢复为分片?apply_fsdp_to_decoder() 把 fully_shard() 装到 embedding、每个 Transformer block 与最后的 norm / lm_head 上。
mp_policy = MixedPrecisionPolicy(param_dtype=bf16, reduce_dtype=fp32, cast_forward_inputs=False)
                                                       training.mixed_precision_param / mixed_precision_reduce
reshard_after_forward = "default" → not pp_enabled     get_fsdp_reshard_after_forward_policy;PP 下默认不 reshard,避免每个 micro-batch 都 all-gather
fully_shard(tok_embeddings, mesh, mp_policy, reshard_after_forward)
for block in layers:  fully_shard(block, ...)          每个 Transformer 层一个 FSDP 单元
fully_shard([norm, lm_head], ..., reshard_after_forward=False)    最后几层前向后不释放:反向马上要用
parallelize_llama() 最后总会调用 apply_fsdp_to_decoder(),即使 dp_shard=1;源码注释说明仍需安装 MixedPrecisionPolicy。PyTorch FSDP2 的 fully_shard() 为 module 安装动态 FSDP 子类、FSDPState 与 FSDPParamGroup;组内每个参数对应一个 FSDPParam。_init_sharded_param() 沿 mesh 的数据并行 shard 维切分,dtype 保持 fp32。TP 已经把参数变成 DTensor 时,FSDP 在其布局上再增加 dp_shard 维。
前向 hook 调用 pre_forward() 与 unshard()。foreach_all_gather() 把分片复制进连续 buffer 并执行 all-gather;wait_for_unshard() 后 foreach_all_gather_copy_out() 将参数按 param_dtype 转为 bf16 并暂挂到 module。post_forward() 调用 reshard(),释放 bf16 并恢复 fp32 分片。反向前再次 unshard,_backward_prefetch() 可提前发通信;post_backward() 通过 foreach_reduce() 将梯度按 fp32 reduce-scatter,结果写入分片参数的 .grad。FSDPCommContext 管 all-gather、reduce-scatter、all-reduce stream。
%% 图:FSDP2 的对象关系:fully_shard 装上 FSDPState,FSDPParamGroup 驱动 unshard / reshard,三条专用 stream 做集合通信
flowchart TB
    FS["fully_shard(block, mesh, mp_policy)<br/>block 的类换成 FSDPTransformerBlock"]
    ST["<b>FSDPState</b><br/>注册 _pre_forward / _post_forward hook<br/>/ _pre_backward hook"]
    PG["<b>FSDPParamGroup</b><br/>unshard / reshard / post_backward"]
    PR["FSDPParam × k(w1 / w2 / w3 ...)<br/>每个持有一个 DTensor Shard(0) fp32<br/>unshard 后临时挂上完整 bf16"]
    AG["<b>all_gather_stream</b><br/>foreach_all_gather:分片转 bf16、<br/>拷进连续 buffer、一次 all-gather"]
    RS["<b>reduce_scatter_stream</b><br/>foreach_reduce:bf16 梯度拷进<br/>buffer、fp32 reduce-scatter"]
    AR["<b>all_reduce_stream</b><br/>仅 HSDP:dp_replicate 维 all-reduce"]
    FS --> ST --> PG --> PR
    PR ~~~ AG
    AG ~~~ RS
    PG <-- "pre_forward / pre_backward: unshard<br/>wait_for_unshard 后 to_unsharded" --> AG
    PG <-- "post_backward<br/>.grad 写回 Shard(0) fp32 分片" --> RS
    RS --> AR
    classDef stream fill:#fde68a,stroke:#b45309;
    classDef shard fill:#e0f2fe,stroke:#0369a1;
    class AG,RS,AR stream;
    class PR shard;
4-rank CPU/gloo toy 的 hook 在实际 Linear 调用时记录到完整 bf16 参数;hook 返回后参数回到 fp32 DTensor 分片。反向梯度仍是 fp32 DTensor;AdamW step 后主参数仍是同一 fp32 分片。
前向前常驻: DTensor 全局(16,16) 本地(4,16) dtype=torch.float32
层0.attn 前向中: Parameter 全局(16,16) 本地(16,16) dtype=torch.bfloat16
前向后常驻: DTensor 全局(16,16) 本地(4,16) dtype=torch.float32
反向后梯度: DTensor 全局(16,16) 本地(4,16) dtype=torch.float32
step 后参数: DTensor 全局(16,16) 本地(4,16) dtype=torch.float32
step 后参数 vs 单进程 fp32 参考: max|diff| = 2.00e-03
bf16 计算与 fp32 参考存在舍入差;toy 用 max|diff| 展示该误差规模,不将 fp32 与 bf16 数值要求为逐位相等。
5. PP 与 CP
PP(distributed/pipeline_parallel.py)。pipeline_llm() 是 ModelSpec.pipelining_fn:_get_pipeline_metadata() 计算 PP rank 到 stage 的映射,支持 looped / V 形分配;_generate_llm_fqn_per_model_part() 按 pipeline_parallel_layers_per_stage 或 module_fqns_per_model_part 划分 module,首末 stage 可少几层以平衡 embedding / lm_head。_pipeline_module_split() 对每个 stage 深拷贝模型、删去不属于它的 module,并创建 torch.distributed.pipelining.PipelineStage。随后每个 model part 执行 parallelize_fn,TP 与 FSDP 都在 stage 内部应用。
_build_pipeline_schedule() 用 get_schedule_class() 选择 "1F1B"、"Interleaved1F1B"、"ZBVZeroBubble" 等 schedule;n_microbatches=local_batch_size/pipeline_parallel_microbatch_size,scale_grads=False,梯度缩放由全局 token 数归一化。配置 pipeline_parallel_schedule_csv 时,_PipelineScheduleRuntime 可加载自定义动作表。训练时 Trainer.pp_forward_backward_step() 调用 pp_schedule.step(...)。
CP(distributed/context_parallel/api.py)。在 partial_dtensor 后端,apply_cp_to_forward() 把每层 inner_attention 替换为 PyTorch 实验 API _context_parallel 的 ring attention;prepare_context_parallel_input() 在 Trainer.post_dataloading_process() 里按 context_parallel_load_balancer(默认 "headtail")切序列。在默认后端,CP 由 decoder_sharding.py 的 set_gqa_inner_attention_local_map() 与 LocalMapConfig 描述。CP 不改变参数形状;cp 会并入 FSDP shard 维,梯度归约覆盖该维。
6. 一个 bf16 参数的一生:torchtitan
这条生命周期要分清两种存储:fp32 DTensor 分片常驻;完整 bf16 参数只在计算前取回。F5 按时间将计算、通信与参数状态对齐。
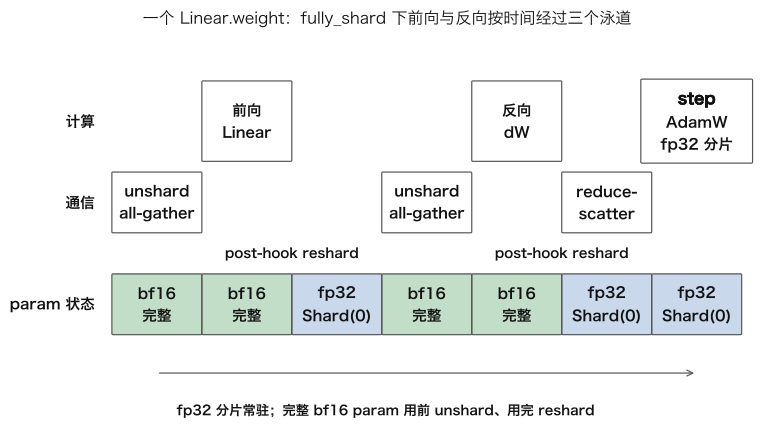
| 时刻 | 事件 | 参数状态 |
|---|---|---|
| meta 构造 | 完整逻辑形状,无存储 | meta fp32 |
| parallelize | TP 与 FSDP placement 就位 | DTensor fp32 分片,仍在 meta |
to_empty + init_weights |
按本地 shape 分配并初始化 | fp32 参数分片常驻 |
| optimizer 构造 | AdamW 创建状态槽 | fp32 参数分片 + m、v |
| 前向前 | pre_forward → unshard;分片参数转 bf16 后 all-gather |
完整 bf16 参数临时出现 |
| 前向计算 | Linear 读取 bf16 weight | 完整 bf16 参数 |
| 前向后 | post_forward → reshard |
恢复 fp32 分片 |
| 反向前 | 再次 unshard / all-gather;可由 _backward_prefetch() 提前发出 |
完整 bf16 参数 |
| 反向 | 计算 dW,foreach_reduce() fp32 reduce-scatter |
fp32 梯度分片;完整 bf16 weight 与 dW 释放 |
optimizer.step() |
AdamW 在 fp32 分片上本地更新 | 更新后的 fp32 参数分片 |
展开:一个 feed_forward.w1.weight 的源码逐时刻表
以一个 Transformer 层的 feed_forward.w1.weight 为例。下表采用本篇 4 × 2 配置;每个 TP rank 持该矩阵一半,FSDP 再沿 4 个 dp_shard rank 切分。
| 时刻 | 事件 | 在哪里 |
|---|---|---|
| meta 构造 | weight 是 fp32 meta 张量,完整逻辑形状,无存储 | Trainer.__init__ 的 torch.device("meta") |
| parallelize | TP sharding 后再 fully_shard(block);weight 是二维 mesh DTensor,本地 1/8 元素,fp32,仍为 meta |
models/llama3/parallelize.py、_fsdp_param.py |
to_empty + init |
本地分片分配显存并初始化 | trainer.py |
| optimizer 构造 | AdamW 的 param 是 fp32 分片;m、v 随优化器 step 初始化 | components/optimizer/ |
| step i,该层前向前 | _pre_forward → FSDPParamGroup.unshard();分片转 bf16、all-gather 沿 dp_shard |
_fsdp_state.py、_fsdp_param_group.py、_fsdp_collectives.py |
| 该层前向 | GEMM 读完整 bf16 的 TP 半片 weight | Linear / FFN |
| 该层前向后 | _post_forward → reshard() → to_sharded(),释放 bf16 参数 |
_fsdp_state.py、_fsdp_param.py |
| 该层反向前 | 再 unshard 一次;_backward_prefetch() 可提前发出 |
_backward_prefetch() |
| 该层反向 | dW 经 foreach_reduce() fp32 reduce-scatter;.grad 回到 DTensor 分片 |
_fsdp_collectives.py |
optimizer.step() |
AdamW 在 fp32 分片上更新参数,不通信 | torch.optim.AdamW |
常驻字节:主要 TP 切分参数的 fp32 参数、fp32 梯度、Adam m/v 合计 16 字节/参数,再除以 \(N_dN_t\);TP 复制的 norm 单独按 \(N_d\) 切。临时项:正在计算层的完整 dp_shard bf16 参数(TP 半片约 60.8 MB),以及可能预取的下一层。通信量:前向 all-gather、反向 all-gather、梯度 reduce-scatter 合计约 \(3N\);PP 下 reshard_after_forward=False 可复用前向参数,约 \(2N\)。通信量沿用 02 的定义,TP 复制 norm 对总数只作微小修正。
torchtitan 的一个取舍是 fp32 分片既是模型参数也是主参数,没有另一份独立 fp32 master copy。training.dtype="float32" 是默认值;代价是未并行化模型占 4 字节/参数,收益是少一次 bf16→fp32 主参数拷贝、少一份状态,checkpoint 保存这份 fp32 权重即可。
7. 训练循环:train_step
Trainer.train() 的循环短:加载 checkpoint,循环调用 train_step(data_iterator),保存 checkpoint,可选 validate,再推进 profiler。第一步后 set_pg_timeouts() 把进程组 timeout 从 comm.init_timeout_seconds(默认 300 秒,容忍初始化和编译)降到 comm.train_timeout_seconds(默认 100 秒),用于更快发现训练期 hang。
train_step() 可压缩为下面几步:
optimizers.zero_grad()
取 gradient_accumulation_steps × num_pipeline_parallel_microbatches 个 micro-batch,统计 local_valid_tokens
global_valid_tokens = dist_sum_tensor(local_valid_tokens, batch_mesh)          loss 按全局 token 数归一
for 每个梯度累积步:
  forward_backward_step()
    非 PP:with train_context(): pred = model(inputs); loss = loss_fn(pred, labels, global_valid_tokens); loss.backward()
    PP:  pp_schedule.step(arg_mbs, kwarg_mbs, target_mbs, losses, loss_kwargs)
grad_norm = dist_utils.clip_grad_norm_(all params, max_norm, pp_mesh=..., ep_enabled=...)   DTensor 感知:分片范数 + 跨 PP 归约
checkpointer.maybe_wait_for_staging()                                                       异步 checkpoint 完成后才能改参数
optimizers.step(); lr_schedulers.step()
metrics_processor.log(step, global_avg_loss, global_max_loss, grad_norm, ...)                loss_mesh 上 dist_sum / dist_max
每一步有明确目的:
- 全局 token 数用于正确归一 loss。
- 梯度累积重复 forward/backward。
- DTensor-aware clip 汇总分片范数。
- checkpoint staging 完成后才允许 optimizer 修改参数。
- 最后更新参数、学习率并记录全局指标。
与 Megatron 的 train_step() 对照:这里没有 zero_grad_buffer,梯度 buffer 由 FSDP 管;没有 no_sync,FSDP2 可用 set_requires_gradient_sync() 控制,但默认每个累积步都 reduce-scatter,梯度直接累积在分片上;没有显式 finalize_model_grads,TP 的部分和由 DTensor redistribute 完成。训练循环里可见的集合通信主要是 dist_sum_tensor 与范数归约;参数通信藏在 FSDP hook 和 DTensor placement 转换里。
七、1F1B:PyTorch 的动作表写法
同一个 1F1B 调度(《并行策略全景》的流水线并行一章),PyTorch 先写过程式,再把过程翻译成动作表。Megatron 的过程式时序见 03 的 F4;本篇不另画图。
torch/distributed/pipelining/schedules.py 的 Schedule1F1B._step_microbatches() 与 Megatron 的循环结构几乎逐行对应:warmup 用 get_fwd_recv_ops()、forward_one_chunk()、get_fwd_send_ops();稳态把上一轮 fwd_sends 与本轮 bwd_recvs 合并进一次 _batch_p2p()。注释称此段为「1B1F」——先反向再前向,与 Megatron 的「1F1B」是切入点不同。
通信操作由 PipelineStage(stage.py)生成 dist.P2POp 列表,调度器负责 batch 与 wait。接收 buffer 形状由 PipelineStage._prepare_forward_infra() 在首个 micro-batch 推断:_forward_metadata_inference() 与 _utils.py 的 InferenceMode 决定静态或动态推断。backward_one_chunk() 调用 _backward.py 的 stage_backward();拆开的 stage_backward_input() 与 stage_backward_weight() 是 zero-bubble 调度的基础。
Schedule1F1B._get_pipeline_order() 把过程翻译成按时间步排列的 _Action 表。_ComputationType 包含 FORWARD、FULL_BACKWARD、BACKWARD_INPUT、BACKWARD_WEIGHT、SEND_F / RECV_F / SEND_B / RECV_B、UNSHARD / RESHARD、REDUCE_GRAD。_PipelineScheduleRuntime 执行该表:_add_send_recv() 插入配对通信动作,_add_unshard_reshard() 插入 FSDP unshard / reshard,_merge_bw() 合并相邻的 input / weight backward。ScheduleInterleaved1F1B、ScheduleInterleavedZeroBubble、ScheduleZBVZeroBubble、ScheduleDualPipeV 通过重写 _calculate_single_rank_operations() 生成动作表;_load_csv() 也可加载手写 CSV,torchtitan 的 pipeline_parallel_schedule_csv 接在这里。
06 并排比较三种训练循环:Megatron、DeepSpeed 与 PyTorch pipeline。
八、本文小结
torchtitan 中,一个 bf16 参数的一生可以压成一句话:meta 上先建形状,TP 与 FSDP 决定 DTensor 分片,to_empty 才分配 fp32 参数;前向和反向前 unshard 得到临时 bf16 参数,反向梯度 reduce-scatter 回 fp32 分片,AdamW 在这份参数上本地更新。
主要 TP 切分状态的常驻账是 \(16(N-N_r)/(N_dN_t)\),TP 复制 norm 再加 \(16N_r/N_d\);通信约 \(3N\),PP 下不 reshard 可约为 \(2N\)。最重要的差异在表示方式:每个参数都是携带 mesh 和 placement 的 DTensor,DCP、TP、FSDP 与 clip_grad_norm_ 可组合使用。
本篇涉及的源码位置(torchtitan v0.3.0 与 PyTorch 2.14.1;torchtitan v0.3.0 release 验证 PyTorch 2.14.0):
| 路径 | 内容 |
|---|---|
torchtitan train.py、trainer.py |
main();Trainer(Config、__init__、init_distributed()、forward_backward_step()、_forward_backward_body()、pp_forward_backward_step()、train_step()、train()) |
torchtitan config/configs.py、README.md |
TrainingConfig(dtype、mixed_precision_param、mixed_precision_reduce、local_batch_size、global_batch_size、seq_len)、ParallelismConfig(data_parallel_replicate_degree、data_parallel_shard_degree、tensor_parallel_degree、enable_sequence_parallel、pipeline_parallel_degree、pipeline_parallel_schedule、pipeline_parallel_microbatch_size、context_parallel_degree、fsdp_reshard_after_forward、spmd_backend)、CommConfig、DebugConfig;配置函数 |
torchtitan distributed/parallel_dims.py、full_dtensor.py |
ParallelDims(from_config()、build_mesh()、get_mesh()、get_optional_mesh())、MeshAxisName、SpmdLayout;resolve_fsdp_mesh() |
torchtitan distributed/fsdp.py、pipeline_parallel.py、context_parallel/api.py、utils.py |
|
|
|
torchtitan components/{metrics,checkpoint,dataloader,loss}.py、components/optimizer/、tools/profiler.py |
|
PyTorch 2.14.1 torch/distributed/fsdp/_fully_shard/ |
|
PyTorch 2.14.1 torch/distributed/fsdp/_flat_param.py、_runtime_utils.py |
FSDP1:FlatParameter、FlatParamHandle(shard()、unshard()、_all_gather_flat_param()、_use_unsharded_flat_param()、_use_unsharded_views()、reshard());_pre_forward()、_pre_forward_unshard()、_post_forward_reshard()、_prefetch_handle() |
PyTorch 2.14.1 torch/distributed/pipelining/schedules.py、stage.py、_backward.py |
|
PyTorch 2.14.1 torch/distributed/device_mesh.py、tensor/_api.py、tensor/parallel/style.py |
|
train-ledger runs/titan/、probe_memory.py |
本篇练手配置与探针,见第四章 |
九、自测
-
FSDP1 的
FlatParameter与 FSDP2 的每参数 DTensor 通信次数相同,差别在哪?答案
FSDP1 把一层拍平成大 Tensor,用户看不到原始参数,优化器、checkpoint、TP 组合需要专门处理;FSDP2 每个参数仍是独立的
Shard(0)DTensor,可与 TP、DCP、torch.compile组合。通信量相近,可组合性不同。 -
torchtitan 里模型为什么先在 meta 设备上构造?
parallelize之后的to_empty做什么?答案
meta 设备只有形状,没有存储;并行化确定每个参数怎么切后,
to_empty才在真实设备上分配本 rank 的分片,再由init_weights写入数值。F4 的 toy 显示了这一分配顺序。 -
ShardingConfig与parallelize_module()+ColwiseParallel的差别是什么?答案
语义相同,都是描述列切、行切及 SP 的布局变化。
ColwiseParallel逐个 module 指定切法;ShardingConfig把参数、输入、输出 placement 声明成配置,由Module.parallelize()统一执行,布局差异推导出 redistribute。 -
F3 中为什么
Shard(0) → Replicate是 all-gather,而Partial → Replicate是 all-reduce?答案
前者需要把各 rank 上互不重叠的行拼成完整 W;后者让每个 rank 对同一逻辑张量贡献部分和,再逐元素相加得到完整结果。
-
F1 的 TP 与
dp_shard两组分别负责什么?答案
同一列 rank 组成 TP 组,协作处理矩阵的不同切片;同一行 rank 组成
dp_shard组,all-gather 参数、reduce-scatter 梯度。FSDP 与 TP 是两个轴,不是一组 8 卡 collective。
系列 《大规模训练工程:从并行策略到容错恢复》 第 5 / 12 篇 深入
系列总览 — 为什么这样组织、读它需要什么、读完能做什么 · 幻灯片 — 整个系列的精华,一份可分享的 deck
学习地图 — AI-Infra 工程师学习地图 第 8 / 14 个系列
- 训练任务的状态解剖——显存账与 MFU
- 并行策略全景——每种并行切的是哪种状态
- Megatron-LM——按模型结构切的架构与源码导读
- DeepSpeed——从优化器状态切起的架构与源码导读
- torchtitan——用 PyTorch 原生原语组合并行的架构与源码导读
- 三个框架对比——Megatron-LM、DeepSpeed 与 torchtitan
- 千卡配置实战——并行搭配、micro-batch、激活重计算与 MFU 调优
- 分布式 checkpoint——格式、异步保存与重分片恢复
- 容错与弹性——故障率数学、straggler、SDC 与弹性训练
- 训练稳定性与数据管线——loss spike、梯度范数、数据混合与流式加载
- 长时训练的可观测与运维——从指标到 hang 排查
- 系列总结与通关自测
上一篇:DeepSpeed——从优化器状态切起的架构与源码导读下一篇:三个框架对比——Megatron-LM、DeepSpeed 与 torchtitan
下一个系列:大模型推理系统揭秘:从 vLLM 看 LLM Serving Infra 核心技术 深入 · 15 篇,约 7.9 小时
本文由 arganzheng 创作,采用 CC BY 4.0 许可协议。在保留原文作者、署名以及完整原文链接(https://arganzheng.life/torchtitan-architecture-and-source-guide.html)的前提下,欢迎各种形式的转载、翻译或商业引用。
COMMENTS
评论存放在 GitHub Discussions, 用 GitHub 账号登录即可发表,支持 Markdown。 想针对正文某句话说?选中那段文字,点浮出的「评论」即可划线评论;觉得哪里写错了,发表时勾上「同时提交 Issue」。 有人回复你时 GitHub 会按你的通知设置发邮件,不用守在这里。