系列 《算法工程师的工具箱:从一个想法到一次能跑的实验》 第 2 / 7 篇
系列总览 — 为什么这样组织、读它需要什么、读完能做什么 · 幻灯片 — 整个系列的精华,一份可分享的 deck
- Python 使用层——读懂训练代码的语法、流式过一遍语料、把实验写成脚本
- 数据科学三剑客——NumPy 的形状直觉、Pandas 的错误分析、Matplotlib 的曲线
- PyTorch 使用层(上)——五个对象与二十行训练循环
- PyTorch 使用层(下)——混合精度、显存的账与多卡启用
- Hugging Face 生态——六个库与一次 LoRA SFT 的组装
- GPU 直觉与实验管理——两个上限、四块显存、能复现
- 系列总结与通关自测
上一篇:Python 使用层——读懂训练代码的语法、流式过一遍语料、把实验写成脚本下一篇:PyTorch 使用层(上)——五个对象与二十行训练循环
算法工作里的代码,十行里有八行在跟形状打交道:这个张量是 [batch, seq, hidden] 还是 [seq, batch, hidden](后者不是错的——RNN 时代与 nn.MultiheadAttention(batch_first=False) 的默认布局把序列维放在最前面,两种布局都在用,本系列统一用前者)、softmax 沿哪一维、mask 怎么加到 score 上、多头 attention 的 reshape 与 transpose 是什么顺序。PyTorch 的 Tensor 语义与 NumPy 的 ndarray 一致,所以形状直觉先在 NumPy 上建立——它没有 GPU、没有自动求导、没有任何干扰,只有形状。本篇用 NumPy 把 L0 讲过的 attention 从公式写成代码并与 PyTorch 对数值;然后讲另外两件天天要做的事:用 Pandas 分析评测结果,用 Matplotlib 看训练曲线。
全篇的核心问题是:
看到一个 attention 的公式,能不能写出对应的
einsum?1 拿到评测结果,能不能按类别算出错误率、找出退化的题?2 看到一条 loss 曲线,知道该看哪里?3
一、总览
1. 本文的组织方式
三个库按”在一次实验里被用到的顺序”排:先用 NumPy 把模型的数学写出来并验证(二到五章),跑完实验用 Pandas 分析结果(六章),训练过程中用 Matplotlib 看曲线(七章)。NumPy 占了一多半篇幅,因为形状直觉是后面 PyTorch 四篇的基础,而 Pandas 与 Matplotlib 只需要各会几个操作。第八章回答一个常被问到的问题:这三个库与 PyTorch 各管什么、边界在哪。
2. 三件事与章节安排
| 事 | 用到的 | 出口 | 章 |
|---|---|---|---|
| NumPy:建立形状直觉 | ndarray · 轴 · 广播三条规则 · reshape / transpose · einsum | 手写一个 causal attention,与 PyTorch 对到 \(10^{-7}\) | 二 ndarray 与轴 · 三 广播 · 四 reshape、transpose 与 einsum · 五 手写 causal attention |
| Pandas:分析评测结果 | DataFrame · groupby · merge · query | 评测结果按类别聚合、找 baseline 对而新模型错的题、带置信区间读表 | 六 |
| Matplotlib:看训练曲线 | 折线 · 多曲线 · 对数坐标 · 阴影带 | loss 曲线:对数 x 轴看早期,多 seed 画均值与标准差 | 七 |
| 三个库与 PyTorch 的边界 | — | 各管什么、什么时候互转 | 八 |
| 本文小结 / 自测 | 九 / 十 |
二、ndarray 与轴
1. 形状与 dtype
NumPy 的核心对象是 ndarray:一块连续内存加一个形状(shape)和一个元素类型(dtype)。L0 第一篇的标量 / 向量 / 矩阵 / 张量在这里就是 0 / 1 / 2 / 多维的 ndarray:
import numpy as np
x = np.zeros((32, 128, 4096), dtype=np.float32)   # 一批 32 句、每句 128 个 token、每个 token 是一个 4096 维的向量(Llama-3-8B 的 hidden size)
x.shape      # (32, 128, 4096)
x.ndim       # 3
x.dtype      # float32:每个元素 4 字节
x.nbytes     # 32 × 128 × 4096 × 4 = 67,108,864 字节 = 64 MiB
看到一个数组先看这三样。nbytes 是第四篇显存账的起点:同样的形状,float32 4 字节、bfloat16 2 字节、int8 1 字节。
2. 索引与切片
x[0]            # 第 0 句:(128, 4096)
x[:, -1]        # 每句的最后一个 token:(32, 4096)
x[:, :64, :]    # 每句的前 64 个 token:(32, 64, 4096)
x[..., :10]     # 只看每个 token 的前 10 维:(32, 128, 10)   ... 表示"前面所有维"
方括号里逐个位置对应一个维度,用逗号分开;每个位置可以写三种东西:
| 写法 | 含义 | 对这一维的影响 | Java 里 |
|---|---|---|---|
整数 i / -1 |
取第 i 个(负数从末尾数,-1 是最后一个) |
这一维消失 | a[i];没有负索引 |
切片 a:b / : / -1: / :64 |
|
这一维保留,长度变为切到的个数 | 没有切片语法,要 Arrays.copyOfRange |
... |
“前面(或后面)所有没写的维度都取全部” | 不变 | 没有 |
所以 x[:, -1] 与 x[:, -1:] 差一维:前者第二个位置是整数,seq 维消失,得 (32, 4096);后者是长度 1 的切片,seq 维保留为 1,得 (32, 1, 4096)。这个差别在广播时(下一章)经常成为 bug 的来源——一个 (32, 4096) 和一个 (32, 1, 4096) 相加,结果是 (32, 32, 4096)。
3. 轴:所有”沿哪个维度”是一个概念
沿轴操作都要指定沿哪个轴(axis)进行。规约类(求和、平均、最大)让那个轴在结果里消失;softmax、LayerNorm 也沿轴算,但不减轴——它们对那一维上的每个数各输出一个数,形状不变(下面表里 softmax、LayerNorm 两行的输出形状与输入相同,”loss 沿 token 维平均”那行才是规约):
x.sum(axis=-1)    # 沿最后一维求和:(32, 128)——每个 token 的 4096 个数加起来
x.mean(axis=0)    # 沿 batch 平均:(128, 4096)
x.max(axis=1)     # 沿 seq 取最大:(32, 4096)
x.sum(axis=-1, keepdims=True)   # (32, 128, 1)——保留那一维为 1,方便下一步广播
axis=-1 是”最后一维”,是最常用的写法,因为按 PyTorch 的约定最后一维是特征维。用 SQL 类比:x.sum(axis=0) 相当于把其余所有维度当 GROUP BY 的键、对 axis 0 上的元素做 SUM——被聚合的那一维在结果里消失,其余维度原样保留。把这一个概念对到模型里:
| 操作 | 张量 | 轴 | 含义 |
|---|---|---|---|
| softmax 沿词表维 | logits [B, T, V] |
axis=-1 |
每个位置的 V 个 logits 变成一个分布 |
| LayerNorm 沿 hidden 维 | x [B, T, d] |
axis=-1 |
每个 token 自己归一化 |
| loss 沿 token 维平均 | per_token_loss [B, T] |
全部平均 | 每 token 负对数似然的平均 |
| attention 沿 key 维 | score [B, h, T_q, T_k] |
axis=-1 |
每个 query 对所有 key 的分数归一化 |
写错轴的 softmax 不报错——沿 batch 维做 softmax 得到的仍是一个形状正确的数组,只是数值全错。这是形状 bug 的第一种:能跑、形状对、数值错。
三、广播
1. 三条规则
形状不同的两个数组做逐元素运算时,NumPy 按广播(broadcasting)规则把小的那个”复制”成大的形状。只有三条:
- 从最后一维往前对齐(右对齐);
- 每一维要么相等,要么其中一个是 1(或那一维不存在);
- 是 1 的那一维被复制到另一个的长度。
| 运算 | 右对齐、缺失的维补 1 | 逐维检查 | 结果与含义 |
|---|---|---|---|
(4, 3) + (3,) |
(4, 3) 与 (1, 3) |
3 = 3 ✓;4 vs 1 ✓ | (4, 3):长度 3 的 bias 加到每一行 |
(4, 3) + (4, 1) |
(4, 3) 与 (4, 1) |
3 vs 1 ✓;4 = 4 ✓ | (4, 3):每行加 / 乘自己的一个标量 |
(4, 3) + (4,) |
(4, 3) 与 (1, 4) |
3 ≠ 4 ✗ | ValueError:最后一维对不上,不能对齐 |
写法说明:(3,) 是 Python 表示”只有一个元素的元组”的写法——逗号是必需的,因为 (3) 就是数字 3。它读作”形状只有一维、这一维长 3”,缺的是前面的高维(行数),不是后面的。所以右对齐时它补成 (1, 3):一行三列,而不是三行一列。
实际运行:
(4,3) + (3,)  bias 加到每一行             -> (4, 3)
(4,3) + (4,1) 每行一个标量                 -> (4, 3)
(4,3) + (4,)  行数对不上最后一维            -> ValueError: operands could not be broadcast together with shapes (4,3) (4,)
2. 模型里的广播
| 运算 | 含义 |
|---|---|
X [B, T, d] + b [d] |
Linear 的偏置加到每个 token |
X [B, T, d] * s [B, T, 1] |
RMSNorm:每个 token 乘自己的缩放因子(keepdims=True 留下的那个 1) |
S [B, h, T, T] + mask [1, 1, T, T] |
causal mask 加到每个 batch、每个 head 的 score 上 |
logits [B, T, V] - max [B, T, 1] |
softmax 减最大值 |
最后一行是第二章 keepdims=True 的用处:x.max(axis=-1, keepdims=True) 得到 [B, T, 1],才能广播回 [B, T, V];不加 keepdims 得到 [B, T],与 [B, T, V] 右对齐时 V 对 T,报错或(更糟)当 \(T = V\) 时静默算错。
3. 能跑但错
广播最危险的地方是它太宽容:
a = np.arange(3)          # (3,)
b = np.arange(3)[:, None] # (3, 1)
(a + b).shape             # (3, 3)!
想做两个长度 3 的向量逐元素相加,因为一个是 (3,) 一个是 (3, 1),广播成了一张 \(3 \times 3\) 的外积表:
[[0 1 2]
 [1 2 3]
 [2 3 4]]
代码不报错,结果的形状看起来也”合理”,只有下游某个地方 loss 突然不对时才发现。防御的办法只有一个习惯:关键步骤 assert x.shape == (...),尤其是 loss 前的 logits 与 labels。
四、reshape、transpose 与 einsum
1. 多头 attention 的形状变换
L0 第一篇说多头 attention 把 \(d\) 拆成 \(h\) 个头,每个头用 \(d_h = d / h\) 维各算一份 attention。代码里是四行,用到四个操作,先把它们交代清楚:
| 操作 | 是什么 | 例子 |
|---|---|---|
A @ B |
矩阵乘法运算符(np.matmul)。二维就是普通矩阵乘;多于二维时只对最后两维做矩阵乘,前面的维度当作”有很多份”,逐份做 |
[B, T, d] @ [d, d] → [B, T, d];[B, h, T, d_h] @ [B, h, d_h, T] → [B, h, T, T] |
a // b |
整除,结果取整数(7 // 2 == 3)。d // h 是每个头的维度 \(d_h\);用 / 会得到浮点数 2.0,不能当形状 |
4096 // 32 == 128 |
x.reshape(...) |
换一种形状去读同一块内存,元素个数不变、顺序不变。不复制数据 | (B, T, d) → (B, T, h, d_h):把每行的 \(d\) 个数读成 \(h\) 组、每组 \(d_h\) 个 |
x.transpose(...) |
重新排列轴的顺序,参数是新顺序里每个位置放原来的第几个轴。也不复制数据,但改了读取顺序 | transpose(0, 2, 1, 3):新的第 1 维是原来的第 2 维(h),新的第 2 维是原来的第 1 维(T) |
Q = X @ W_Q                                  # ① [B, T, d]
Q = Q.reshape(B, T, h, d // h)               # ② [B, T, h, d_h]   把最后一维拆成 h 组
Q = Q.transpose(0, 2, 1, 3)                  # ③ [B, h, T, d_h]   把 head 维挪到前面,让每个头独立成一个 [T, d_h]
S = Q @ K.transpose(0, 1, 3, 2)              # ④ [B, h, T, d_h] × [B, h, d_h, T] → [B, h, T, T]
图 1 用 \(T = 3\)、\(d = 4\)、\(h = 2\) 画出这四步。两个改形状的操作性质不同:
reshape不移动数据,只改变”怎么读这块内存”。(B, T, d)与(B, T, h, d_h)是同一块内存的两种解释:图 1 的 ② 只是把 ① 每行的 4 个格子画成两组,一个字节都没动,所以零成本。transpose也不移动数据,但让内存不再连续。图 1 的 ③ 里 head 0 的三行在内存里分别来自 ① 的三行开头,中间隔着 head 1 的格子——按 ③ 的顺序读,地址不再是一个接一个的。在 NumPy 里这透明;在 PyTorch 里transpose之后再view会报错,要先.contiguous()(真的复制一份成连续的)或用reshape(自动判断要不要复制)。stride 与内存布局的细节属于 Infra 03 系列第二篇,这里知道”transpose 之后不连续”即可。
第 ④ 行是 @ 的多维用法:K.transpose(0, 1, 3, 2) 把 K 的最后两维交换成 [d_h, T],然后 [T, d_h] @ [d_h, T] 得到每个头的 [T, T] 分数表,前面的 B, h 两维是”有 \(B \times h\) 份”。
2. einsum:把公式翻译成代码
einsum(Einstein summation)用一个下标字符串描述矩阵乘法,是把论文公式翻译成代码的最短路径。先看最简单的二维例子——普通矩阵乘法 \(C_{ij} = \sum_k A_{ik} B_{kj}\):
C = np.einsum("ik,kj->ij", A, B) # 等价于 A @ B
字符串的读法只有一条规则:给每个输入的每一维取一个字母名字,箭头右边写输出要保留哪些字母;左边有、右边没有的字母,就是被求和掉的那一维。 这里 A 的两维叫 i k,B 的两维叫 k j,输出保留 i j,k 只在左边出现——所以沿 k 求和。写成循环就是:
for i in range(I):
    for j in range(J):
        C[i, j] = sum(A[i, k] * B[k, j] for k in range(K))   # k 被求和,i、j 留下
规则不变,维度加多就是 attention 里的样子:
S = np.einsum("bhqd,bhkd->bhqk", Q, K) # 带 batch 与 head 的 Q K^T
读法:Q 的四维叫 b h q d,K 的四维叫 b h k d;箭头右边是输出的维度 b h q k。只出现在左边、没出现在右边的字母被求和(这里是 d——内积就是沿 \(d\) 求和);两边都出现的字母被保留;右边的顺序就是输出形状。上面那行等价于 Q @ K.transpose(0, 1, 3, 2),但不用想 transpose 的参数顺序。
几个常见公式的 einsum:
| 公式 | einsum | 含义 |
|---|---|---|
| \(S = QK^T\) | "btd,bsd->bts" |
每个 query t 对每个 key s 的内积,沿 d 求和 |
| \(O = PV\) | "bts,bsd->btd" |
attention 权重 P 加权求和 V,沿 s 求和 |
| 逐元素乘再求和 | "ij,ij->" |
Frobenius 内积 |
| 矩阵乘法 | "ik,kj->ij" |
就是 A @ B |
| 转置 | "ij->ji" |
|
| 批量外积 | "bi,bj->bij" |
读论文里的张量公式时,先在脑子里写出 einsum 的下标,是检验自己是否真的看懂了形状的办法。
五、手写 causal attention
1. 30 行
把 L0 的公式 \(\text{Attention}(Q, K, V) = \text{softmax}(QK^T / \sqrt{d_k})\,V\) 加上 causal mask(每个位置只能看自己和前面的)写出来:
def softmax(x, axis=-1):
    x = x - x.max(axis=axis, keepdims=True)       # 减最大值:L0 第五篇的数值技巧;keepdims 让它能广播回去
    e = np.exp(x)
    return e / e.sum(axis=axis, keepdims=True)

def causal_attention_np(Q, K, V):                  # Q, K, V: [B, T, d]
    B, T, d = Q.shape
    S = np.einsum("btd,bsd->bts", Q, K) / np.sqrt(d)   # [B, T, T]:query t 对 key s 的分数;除 √d 见 L0 第四篇
    mask = np.triu(np.ones((T, T), dtype=bool), k=1)   # 上三角(不含对角线)为 True:s > t 是"未来"
    S = np.where(mask, -np.inf, S)                     # [T, T] 的 mask 广播到 [B, T, T];−∞ 过 softmax 变 0
    P = softmax(S, axis=-1)                            # 沿 key 维归一化:每个 query 的权重和为 1
    return np.einsum("bts,bsd->btd", P, V)             # 加权求和 V
每一行都在用前面三章的东西:keepdims 与广播、einsum、axis=-1、mask 的广播。
2. 与 PyTorch 对数值
out_np = causal_attention_np(Q, K, V)
out_pt = F.scaled_dot_product_attention(torch.tensor(Q), torch.tensor(K), torch.tensor(V), is_causal=True).numpy()
np.abs(out_np - out_pt).max()     # 2.65e-07
形状: Q (2, 8, 16) -> S (2, 8, 8) -> 输出 (2, 8, 16)
最大绝对误差: 2.65e-07   (float32 下 1e-6 量级即为一致)
第 0 个 batch 的 attention 权重(每行和为 1,上三角为 0):
[[1.   0.   0.   0.   0.   0.   0.   0.  ]
 [0.28 0.72 0.   0.   0.   0.   0.   0.  ]
 [0.92 0.05 0.03 0.   0.   0.   0.   0.  ]
 [0.33 0.08 0.5  0.09 0.   0.   0.   0.  ]
 [0.29 0.24 0.   0.3  0.18 0.   0.   0.  ]
 [0.22 0.15 0.12 0.11 0.05 0.35 0.   0.  ]
 [0.04 0.44 0.09 0.3  0.06 0.06 0.01 0.  ]
 [0.01 0.12 0.05 0.12 0.12 0.16 0.23 0.19]]
\(2.65 \times 10^{-7}\) 是 float32 的舍入误差量级——两个实现一致。权重矩阵读起来:第 0 行只能看自己(1.0),第 \(t\) 行只有前 \(t + 1\) 个非零,每行和为 1。“与参考实现对数值”是验证任何手写算子的标准方法,L3 系列的梯度检查、Infra 系列的 kernel 验证用的都是这一招;标准是误差在浮点精度量级(float32 约 \(10^{-6}\),float64 约 \(10^{-12}\)),不是”看起来差不多”。
这 30 行是 PyTorch 里 F.scaled_dot_product_attention 做的事的数学版;真实实现(FlashAttention)不会显式构造 \([T, T]\) 的 \(S\)——那是 Infra 05 系列的内容。
六、Pandas:评测的错误分析
1. DataFrame 不是 ndarray
Pandas 是 Python 里处理表格数据的标准库,核心对象 DataFrame:一张有列名、有行索引的二维表,可以把它当成内存里的一张 SQL 表或一页 Excel。它与 ndarray 的差别决定了各自的用途:
| ndarray | DataFrame | |
|---|---|---|
| 维度 | 任意维 | 只有二维(行 × 列) |
| 元素类型 | 整块同一个 dtype | 每列一个 dtype:一列字符串(类别)、一列 bool(对错)、一列浮点(分数)可以并存 |
| 怎么找元素 | 按位置:x[3, 2] |
按名字:df["category"]、df.loc[df.correct];行还有 index(题号) |
| 典型操作 | 数学:矩阵乘、沿轴规约、广播 | 表:筛行、选列、groupby 聚合、merge 对齐、排序 |
| 用在哪 | 模型的数学、张量的形状 | 实验结果、评测明细、日志——”每行一条记录”的数据 |
上图把两者的逻辑视图和内存布局并排画出来:ndarray 的 12 个数在内存里是一条连续的 float32,x[i, j] 只是算一个偏移;DataFrame 的三列是三条各自独立的一维数组(字符串、bool、浮点各一条),index 是第四条,所以它能一列一种类型,也所以”取一列”(df["score"])是零拷贝的、而”取一行”要从三条数组里各拿一个拼起来。
两者的”规约”看起来都在求和取平均,但沿什么规约不同:ndarray 沿一个位置轴(axis=0),要求所有元素同类型;DataFrame 沿一个标签列分组(groupby("category")),每组内再对另一列聚合——这正是 SQL 的 GROUP BY。第二章那句”axis 像 GROUP BY”反过来说也成立:groupby 就是带标签的 axis。DataFrame 的每一列底下其实就是一个一维 ndarray(df["acc"].to_numpy()),所以数学运算可以直接在列上做(下面的 ci95 一行就是)。
2. 场景
跑完评测得到一个文件,每题一行:题号、类别、模型答案、标准答案。要回答的问题不是”总分多少”,而是:哪类题好、哪类题差、相比 baseline 哪些题退化了。这是表格操作,DataFrame 就是为它设计的。
3. 三个操作
import pandas as pd
new = pd.DataFrame(rows)                              # 每行 {"id", "category", "correct"}
new.groupby("category")["correct"].agg(["mean", "count"])          # 各类别正确率与题数
merged = new.merge(base, on=["id", "category"], suffixes=("", "_base"))   # 与 baseline 按题号对齐
merged.query("not correct and correct_base")                       # 退化的题:baseline 对、新模型错
groupby:按某一列分组,对每组算统计量——”各类别正确率”;merge:两张表按键对齐——把新模型与 baseline 的结果放到同一行;query:用一个字符串表达式筛行——”退化的题”。
用一份合成数据(530 题、四个类别)跑出来:
               acc_new  count  acc_base  delta   ci95
category
algebra          0.770    200     0.695  0.075  0.058
combinatorics    0.525     80     0.475  0.050  0.109
geometry         0.627    150     0.580  0.047  0.077
number_theory    0.610    100     0.640 -0.030  0.096
总体: base 0.619 -> new 0.662
退化的题(base 对、new 错): 28;改善的题: 51
退化最多的类别: {'algebra': 12, 'geometry': 7, 'combinatorics': 5, 'number_theory': 4}
4. 带着置信区间读表
上面那张表里 algebra 提升了 7.5 个点、number_theory 退化了 3 个点。这两个数能不能信?L0 第八篇的答案是:一个用 \(n\) 道题测出来的正确率 \(\hat p\),本身有 \(\pm 1.96\sqrt{\hat p(1 - \hat p)/n}\) 的 95% 置信区间;两次测量的差小于这个区间,就分不出是方法的差别还是题目抽样的运气。
这一步在 Pandas 里是一行:summary 的每一列是一个 ndarray,四则运算与 np.sqrt 逐元素作用在整列上(第三章的广播),不用写循环:
summary = new.groupby("category")["correct"].agg(acc_new="mean", count="count")
summary["ci95"] = 1.96 * np.sqrt(summary["acc_new"] * (1 - summary["acc_new"]) / summary["count"])
回头读表:
| 类别 | 题数 | 提升 | ±ci95 | 结论 |
|---|---|---|---|---|
| algebra | 200 | +7.5 | 5.8 | 提升超过区间,可信 |
| combinatorics | 80 | +5.0 | 10.9 | 80 道题分辨不出 5 个点的差别 |
| geometry | 150 | +4.7 | 7.7 | 同上,不显著 |
| number_theory | 100 | −3.0 | 9.6 | 退化不一定是真的——但那 4 道”baseline 对、新模型错”的题值得一道道看 |
总体 +4.3 个点、530 题的区间约 ±4.0,勉强显著。总分 + 各类别 + 置信区间 + 退化题列表,这四样是 L5 评测系列里”能力分解与错误分析”的全部工具,代码就是上面那几行。
5. Polars:同一套操作的新实现
Polars 是 Pandas 的新一代替代品:Rust 实现、多线程、默认惰性执行(先记下要做什么、最后一起优化执行,与第一篇的生成器流水线是同一个思路),在千万行以上快一个数量级。它的接口不兼容 Pandas,但概念完全一样——筛行、选列、分组聚合、按键对齐。上面的三个操作用 Polars 写:
import polars as pl
new = pl.DataFrame(rows)
new.group_by("category").agg(pl.col("correct").mean().alias("acc_new"), pl.len().alias("count"))
merged = new.join(base, on=["id", "category"], suffix="_base")
merged.filter(~pl.col("correct") & pl.col("correct_base"))
差别在表面:groupby → group_by,merge → join,query("...") 字符串 → filter(pl.col(...)) 表达式。评测明细这种几千到几十万行的表,两者速度都不是问题,用哪个看团队;读别人的代码两个都会遇到。
七、Matplotlib:看曲线
1. 需要的很少
Matplotlib 是 Python 的基础绘图库(Seaborn 是它上面的一层封装,画统计图更省事)。训练是否正常,第一眼看的是曲线:loss、梯度范数、学习率随步数的变化。需要的绘图能力只有折线、多条曲线对比、对数坐标、子图、阴影带——下面这一张图用到了全部五样,用合成数据画的,两个”方法” A、B 各跑 5 个 seed:
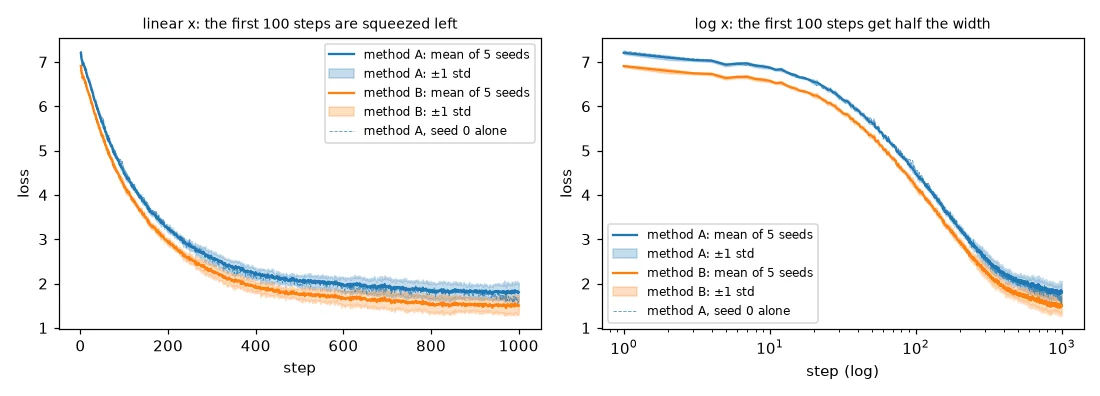
读它要建立两个习惯:1. 用对数 x 轴看训练早期(下一节);2. 多个 seed 画均值与阴影带再下判断(第 3 节)。
2. 对数 x 轴看早期
ax.set_xscale("log")
左右两张子图是同一组曲线,只有 x 轴刻度不同。训练的前 1% 步数决定了初始化与 warmup 是否对(L0 第五篇:第一步 loss 该是 \(\ln V\),这里 7.2 对应 \(V \approx 1300\);L3:warmup 期间 loss 先慢后快),但在左图的线性 x 轴上前 100 步被压成最左边一条竖线,什么也看不出。右图的对数 x 轴给前 100 步分了一半宽度:起点、warmup 期间那段平缓、随后加速下降都看得见。看训练早期一律用对数 x 轴。
3. 多 seed 画均值与阴影带
mean, std = curves.mean(0), curves.std(0)                          # curves: [n_seeds, n_steps]
ax.plot(steps, mean)
ax.fill_between(steps, mean - std, mean + std, alpha=0.3)
曲线形状 (5, 1000);method A step 10 / 100 / 1000 的均值 loss: 6.87 / 4.47 / 1.80,seed 间标准差 0.179
step 1000:A − B = 0.300,约 1.7 个标准差
图里那条虚线是 method A 的单个 seed:它自己一路抖动,与 B 的均值在几百步上还交叉过,只看这一条分不清 A、B 的差别是”方法”还是”运气”。5 个 seed 的均值加 ±1 标准差的阴影带就能下判断:A、B 两条带到后期不重叠(差 0.30,约 1.7 个标准差),B 确实更好;而在前 200 步两条带重叠,那时候说”B 收敛更快”是没有依据的。这是横切”实验方法论”的规则,工具就是 fill_between 一行。
4. 双对数
scaling law 的图横纵轴都是对数刻度(ax.set_xscale("log"); ax.set_yscale("log")),因为幂律在双对数下是直线(L0 第八篇)。看到这种图先读斜率。
八、三个库与 PyTorch 的边界
读到这里常有一个疑问:既然 PyTorch 的 Tensor 也能 sum(axis=-1)、也能画成表,为什么还要 NumPy、Pandas、Matplotlib?四者各管一段:
| 库 | 管什么 | 不管什么 | 典型场景 |
|---|---|---|---|
| NumPy | CPU 上的多维数组与数学;形状、广播、einsum 的”参考语义” | GPU、自动求导、模型 |
|
| PyTorch | 训练本体:Tensor 在 GPU 上、Autograd 记梯度、nn.Module 装参数 |
表格分析、画图 | 模型的前向与反向、训练循环、推理 |
| Pandas / Polars | “每行一条记录”的表:评测明细、实验日志、数据集的元信息 | 张量数学、进训练循环 | 跑完实验之后的分析;训练之前看数据分布 |
| Matplotlib | 把数组画成图 | 数据本身 | loss 曲线、attention 热图、任何”看一眼”的需求 |
边界上的两个事实:
- Tensor 与 ndarray 互转是零拷贝的(在 CPU 上):
t.numpy()与torch.from_numpy(x)共享内存,所以”用 NumPy 写参考实现、与 PyTorch 对数值”几乎不花钱;GPU 上的 Tensor 要先.cpu()。Pandas 的一列.to_numpy()也是 ndarray,Matplotlib 接受 ndarray(Tensor 要先.numpy())。 - 训练循环里不出现 NumPy 和 Pandas。循环里的一切都是 Tensor,因为要在 GPU 上、要记梯度;把 Tensor 转成 ndarray 会把它搬回 CPU 并切断梯度。NumPy 出现在循环之前(预处理、参考实现)和之后(分析结果),Pandas 只出现在之后。
九、本文小结
- ndarray = 内存 + 形状 + dtype;
nbytes是显存账的起点。整数索引消灭一维、切片保留一维。 - 轴:所有”沿哪个维度”是一个概念,那一维在结果里消失,
keepdims=True留下一个 1 供广播。softmax 沿词表维、LayerNorm 沿 hidden 维、attention 沿 key 维——写错轴不报错。 - 广播三条规则:右对齐、相等或为 1、为 1 的被复制。
(3,) + (3, 1)静默变成(3, 3)——形状 bug 的第一种是”能跑但错”,防御是assert形状。 - reshape 不移动数据;transpose 也不移动但让内存不连续(PyTorch 里
view前要contiguous)。多头 attention 是 reshape 拆 head、transpose 把 head 挪到前面。 - einsum 用下标字符串描述张量乘法:只在左边的字母被求和、两边都有的被保留、右边的顺序是输出形状。读公式先写 einsum。
- 30 行 NumPy 的 causal attention 与 PyTorch 对到 \(2.65 \times 10^{-7}\)——”与参考实现对数值到浮点精度”是验证手写算子的标准方法。
- Pandas 三个操作:
groupby看各类别、merge对齐 baseline、query找退化的题;ci95一行算出来,读表要带着置信区间。DataFrame是每列一个 dtype 的二维表、按标签分组,ndarray 是同质多维数组、按位置轴规约;Polars 是同一套操作的多线程惰性实现。 - Matplotlib 两个习惯:对数 x 轴看训练早期;多 seed 画均值与
fill_between阴影带。 - 边界:NumPy 是参考语义与预处理,PyTorch 是训练本体,Pandas 管结果表,Matplotlib 管看图;训练循环里只有 Tensor,CPU 上 Tensor ↔ ndarray 零拷贝。
配套代码:本文的数字与图由 algorithm-tooling/01_numpy_pandas_matplotlib.py 产生(合成数据、attention 对数值、评测表、多 seed 曲线);复现时去拉它,读本文不需要。
十、自测
-
x.shape == (32, 128, 4096):x[0, :, 0]、x[:, 0]、x[..., :1]各是什么形状?答案
(128,)、(32, 4096)、(32, 128, 1)。 -
(32, 128, 4096) + (128, 1)能广播吗?结果是什么形状?+ (128,)呢?答案
能,右对齐
4096对1、128对128,结果(32, 128, 4096)——每个 token 加自己的一个标量;(128,)对4096不相等且不是 1,报错。 -
写出
O = P V(P: [B, h, T, T],V: [B, h, T, d_h])的 einsum,输出形状是什么?答案
"bhts,bhsd->bhtd",[B, h, T, d_h]。 -
沿错误的轴做 softmax 为什么不报错?怎么防?
答案
结果形状与输入相同,NumPy 无法知道你的意图;关键处
assert形状、对一个小例子手算验证。 -
评测结果里新模型比 baseline 总分高 2 个点,但你想知道”是不是同样的题”:用哪两个 Pandas 操作?
答案
merge(按题号对齐)+query(筛 “correct and not correct_base” 与反过来)。
下一篇把形状直觉搬到 PyTorch 上:五个核心对象、二十行训练循环、Autograd 要知道的三件事,训一个字符级小 Transformer。
-
能。把公式里每个张量的下标写出来:只出现在左边的字母被求和、两边都有的被保留、右边的顺序就是输出形状——\(\text{softmax}(QK^T)V\) 是
"bhtd,bhsd->bhts"与"bhts,bhsd->bhtd"两行;30 行 NumPy 与 PyTorch 对到 \(10^{-7}\)。详见第四章、第五章。 ↩ -
能。
groupby按类别算准确率并带上ci95,merge按题号对齐 baseline,query筛出「baseline 对、新模型错」的题。详见第六章。 ↩ -
x 轴用对数看训练早期;多 seed 画均值与阴影带,一条曲线高出阴影带才算差别;看 train / val 是否分叉判断过拟合。详见第七章。 ↩
系列 《算法工程师的工具箱:从一个想法到一次能跑的实验》 第 2 / 7 篇
系列总览 — 为什么这样组织、读它需要什么、读完能做什么 · 幻灯片 — 整个系列的精华,一份可分享的 deck
- Python 使用层——读懂训练代码的语法、流式过一遍语料、把实验写成脚本
- 数据科学三剑客——NumPy 的形状直觉、Pandas 的错误分析、Matplotlib 的曲线
- PyTorch 使用层(上)——五个对象与二十行训练循环
- PyTorch 使用层(下)——混合精度、显存的账与多卡启用
- Hugging Face 生态——六个库与一次 LoRA SFT 的组装
- GPU 直觉与实验管理——两个上限、四块显存、能复现
- 系列总结与通关自测
上一篇:Python 使用层——读懂训练代码的语法、流式过一遍语料、把实验写成脚本下一篇:PyTorch 使用层(上)——五个对象与二十行训练循环
本文由 arganzheng 创作,采用 CC BY 4.0 许可协议。在保留原文作者、署名以及完整原文链接(https://arganzheng.life/numpy-pandas-matplotlib-for-algorithm-engineers.html)的前提下,欢迎各种形式的转载、翻译或商业引用。
COMMENTS
评论存放在 GitHub Discussions, 用 GitHub 账号登录即可发表,支持 Markdown。 想针对正文某句话说?选中那段文字,点浮出的「评论」即可划线评论;觉得哪里写错了,发表时勾上「同时提交 Issue」。 有人回复你时 GitHub 会按你的通知设置发邮件,不用守在这里。