这个系列的一句话主张
训练引擎围绕状态组织,先算再试。
一个训练任务的全部状态只有四样——参数、梯度、优化器状态、激活:
| 事 | 对状态做什么 | 篇 |
|---|---|---|
| 算账 | 它们各多少字节、多少 FLOP | 01 |
| 并行 | 决定它们放在哪张卡上 | 02、03、04 |
| checkpoint | 把其中三样写到持久存储 | 05 |
| 容错 | 一部分卡消失后重建它们 | 06 |
| 稳定性 | 保证它们的数值不跑飞 | 07 |
| 可观测 | 让它们的字节数与位置成为指标 | 08 |
代入 Llama 3 的 8B / 70B / 405B 与 1024 或 16K 张 H100;到 Megatron Core、DeepSpeed、torchtitan 源码里找同一个系数。
十一篇怎么连起来
%%{init: {"flowchart": {"wrappingWidth": 200}}}%%
flowchart TB
    L1["01 状态解剖"] --> L2["02 并行策略全景"]
    L2 --> L3["03 三个框架"]
    L2 & L3 --> L4["04 千卡配置实战"]
    L1 & L2 --> L5["05 分布式 checkpoint"]
    L5 --> L6["06 容错与弹性"]
    L1 --> L7["07 训练稳定性与数据管线"]
    L4 & L6 & L7 --> L8["08 可观测与运维"]
01 · 状态解剖:三种是 N 的线性函数,一种是 token 数的
每参数 16 字节——70B 常驻 1.13 TB,一张 80 GB 卡的 14 倍
三个数的包含关系,与 MFU / HFU
要点
- 千卡 dense ≥ 40% MFU 是好成绩
常见误区
- MFU 不含重计算、HFU 含;全量重计算 (\text{HFU}=\tfrac43\,\text{MFU})——「开重计算后 MFU 上去了」是误区
02 · 并行策略全景:每一个「切」对应一种通信
并行是状态的放置方案——TP 锁 NVLink、PP 放最远
TP:列切不通信、行切要 all-reduce
| 并行 | 切什么 | 每 step 通信 | 链路 |
|---|---|---|---|
| DP / ZeRO-1 / ZeRO-2 | 复制 / O / O + G | 2N | 可重叠,放最远 |
| ZeRO-3 / FSDP | P + G + O | 3N | 可重叠 |
| TP | 每层的矩阵 | 每层 2 + 2 次 all-reduce | 不可重叠,NVLink 内 |
| PP | 层 | 层间激活,最小 | 可重叠;气泡 (p−1)/m,交错后 (p−1)/(vm) |
PP:GPipe 与 1F1B;CP:ring attention
03 · Megatron-LM:bf16 参数常驻完整
bf16 参数拍进连续 buffer 从不释放;优化器状态按字节区间切到 DP
要点
- 每参数常驻 (2+4+12/N_d);通信 (\text{RS}+\text{AG}=2N),两处都与计算重叠
04 · DeepSpeed:参数是空壳,碎片是常态
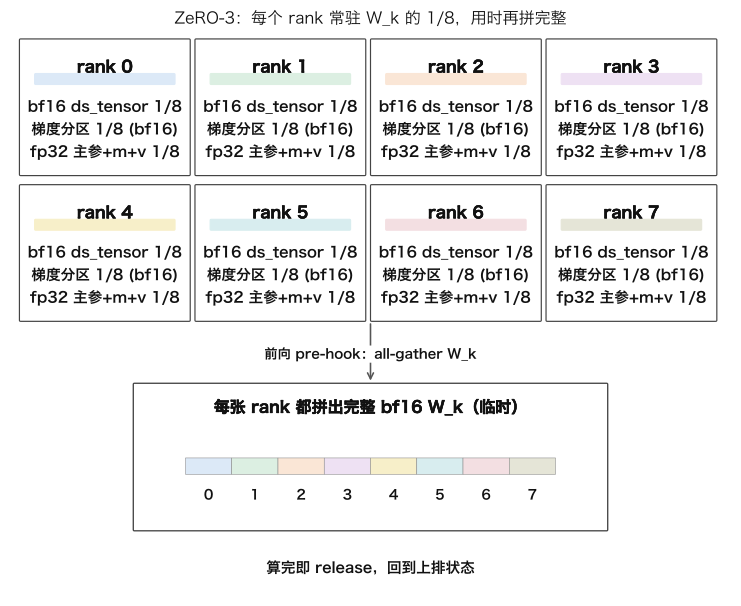
Stage 3:bf16 参数常驻 (1/N_d) 碎片,param.data 一个 step 换四次身份
要点
- 每参数常驻 ((16\text{ 或 }18)/N_d) + 临时层;通信 (3N);hook 外拿到空张量
05 · torchtitan:fp32 分片既是参数也是主参数
bf16 不常驻:参数是 Shard(0) fp32 DTensor,unshard 出临时 bf16
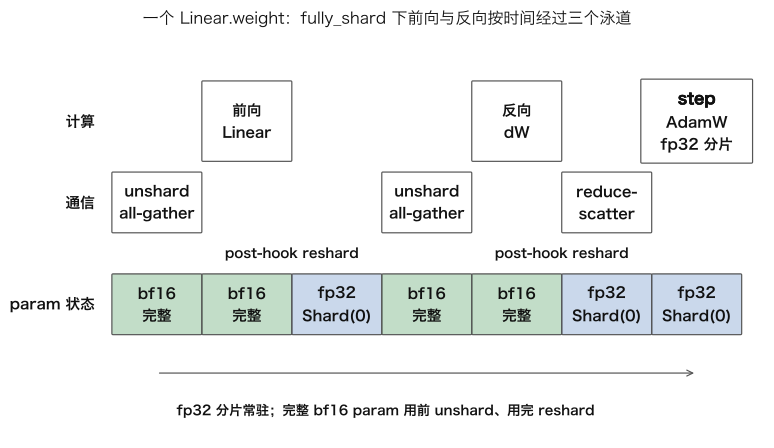
要点
- 每参数常驻 (16/N_d) + 临时 bf16;通信 (3N)(不 reshard 则 (2N))
06 · 三个框架对比:通信量相同,表示决定一切
通信量相同,差别在分片的表示——DTensor 自描述可组合
| 框架 | 每参数常驻 | 每 step 通信 | 进程组 |
|---|---|---|---|
| Megatron Core 0.18 | (2+4+12/N_d) | RS + AG = (2N) | RankGenerator(order="tp-cp-ep-dp-pp") |
| DeepSpeed 0.19 Stage 3 | ((16\text{ 或 }18)/N_d) + 临时层 | AG + AG + RS = (3N) | mpu 委托 |
| torchtitan v0.3(FSDP2) | (16/N_d) + 临时层 | (3N) | DeviceMesh + DTensor |
要点
- 选型:千卡 MFU → Megatron;零侵入放大 → DeepSpeed;新组合并行 → torchtitan
常见误区
- 「FSDP2 比 FSDP1 通信少所以快」——次数与量相同;差别是可组合性
07 · 千卡配置实战:70B、1024 张 H100,先算
每卡 token 少时选 PP + ZeRO-1 不选 FSDP
| 候选 A | 值 |
|---|---|
| 并行 | TP8 / PP4(v = 4 交错)/ DP32 |
| micro-batch | b = 1、m = 16;气泡 4.7% |
| 每卡显存 | 约 49 GB,不重计算 |
| 理论 step | 2.0 s;目标 42% MFU ≈ 4.75 s ≈ 88 万 token/s |
| 只有 32% 时缺的 10 个点 | 配置约 6、硬件约 2、结构约 0.5、管线约 0.5 |
要点
- 全量重计算 +33% FLOP 省 94% 激活;FP8 step 时间降 20–25%
常见误区
- 「PP 加深激活就少」——1F1B 第一个 stage 同时持有 p 个 micro-batch 的激活;减激活靠 micro-batch、SP、CP、重计算
08 · 分布式 checkpoint:磁盘上是「全局张量的一组分片」
与并行配置无关的唯一字节 → 零通信重分片;异步保存是必需不是优化
\[\tau_{opt} = \sqrt{2\,\delta\,M},\qquad \text{最小浪费} = \sqrt{2\delta / M}\]| M ≈ 3.1 h(16K 卡的 MTBF) | δ | 最小浪费 |
|---|---|---|
| 同步写单文件 | 10 min | 33% |
| 分片异步写 | 2 s | 1.9% |
常见误区
- 405B 5.7 TB:分片写每卡 350 MB 秒级;「大小随并行配置变」不成立——去掉 DP 复制的唯一字节不变
09 · 容错与弹性:故障是常态,有效时间是五项公式
缩短有效时间:先 δ(异步保存)、再检测与重启、间隔最后
\[G = \frac{1 - (T_d + T_r + T_l + \tau/2)/M}{1 + \delta/\tau}\]| Llama 3 405B | 数 |
|---|---|
| 中断成因 | 78% 硬件、58.7% GPU;M = \(M_{gpu}/N\),16K 卡 M ≈ 3.1 h |
| 16K 卡:同步 → 异步 → 压检测与重启 | 71% → 87% → 94% |
要点
- 间隔由 \(\sqrt{2\delta M}\) 决定:δ 不变缩间隔只是多付保存代价
常见误区
- 「straggler = 坏卡」——多数是序列长度 / stage 不均衡、每步换 rank
10 · 稳定性与数据管线:五种成因各有信号指纹
三种形态 × 五种成因,靠事前记录的原始值归因;处理 = 回退 + 跳过
| 成因 | 指纹 |
|---|---|
| 学习率 | 与调度拐点对齐;param norm 加速 |
| bf16 精度 | grad norm 平台后跳变 |
| attention logit | max logit 单调升过约 100 |
| 坏数据 | 换 seed / 跳 batch 后不复现 |
| 优化器状态 | 恢复 checkpoint 后仍在同一步附近 |
要点
- PaLM:回退约 100 步 + 跳过 200–500 batch,约 250–300 步 / 次
常见误区
- 「loss spike 就是脏数据」——五种里两种是模型内部数值问题
11 · 可观测与运维:「step 是否前进」是 hang 唯一可靠的信号
利用率 100% 照样可能在 hang——NCCL kernel 自旋
| 凌晨三点 step 12 s → 40 s,四个嫌疑 | 决定性指标 |
|---|---|
| straggler | Timers minmax(哪个 rank 最慢、是否每步换) |
| 数据 | data_loading(%) |
| 通信 | 通信等待 + IB 端口计数器 |
| 降频 | SM_CLOCK |
要点
- Flight Recorder 2.13.0 默认开(buffer 2000);把 dump 路径接好、缓冲加到 2 万
- 2.5 美元 / 卡时下 1 个 MFU 点 ≈ 30 天任务的 0.71 天 ≈ 4.4 万美元
四种状态在十一篇里
| 状态 | 01 多少 | 02–04 放哪 | 05 落盘 | 06 重建 | 07 数值 | 08 指标 |
|---|---|---|---|---|---|---|
| 参数 | 2N bf16 + 4N fp32 | TP / ZeRO-3 切 | 4 B(fp32 主) | 重分片加载 | param norm | 每 rank 显存 |
| 梯度 | 2N | DP 归约 | 不落 | — | grad norm、裁剪 | 通信等待 |
| 优化器状态 | 8N | ZeRO-1 切 | 8 B | 重分片 | 恢复后仍 spike → 是它 | — |
| 激活 | sbh(34 + 5as/h) | PP / CP / 重计算 | 不落 | — | max logit | 峰值显存 |
常见误区(一)
- 「bf16 训练每参数 2 字节」——16 字节,70B 1.13 TB
- 「开重计算后 MFU 上去了」——只计入 HFU
- 「TP 通信量最大所以最贵」——贵在不可重叠
- 「ZeRO-2 比 ZeRO-1 多通信」——都是 2N
- 「FSDP2 比 FSDP1 通信少」——差别是表示
- 「千卡上用 FSDP 代替 PP 更快」——每卡 4096 token 摊不薄参数通信
常见误区(二)
- 「PP 加深激活就少」——1F1B 持有 p 份
- 「checkpoint 大小随并行配置变」——唯一字节不变
- 「异步 checkpoint 是锦上添花」——同步最小浪费 ≥ 10%
- 「有效时间低先缩间隔」——先 (\delta)、再 (T_d)、再 (T_r)
- 「straggler = 坏卡」——多数每步换 rank
- 「GPU 利用率 100% 说明训练正常」——hang 时也 100%
十一个出口
| 篇 | 一个公式 / 一个数 |
|---|---|
| 01 | 16 B / 参数;\(sbh(34 + 5as/h)\);\(6N + 6Lsh\);HFU = 4/3 MFU |
| 02 | DP 2N / ZeRO-3 3N;TP ≤ 8;气泡 (p−1)/(vm);TP → CP → PP → DP |
| 03 | 常驻 2 + 4 + 12/N_d vs 16/N_d;RS + AG = 2N |
| 04 | TP8 / PP4 / DP32,b = 1、m = 16;42% ≈ 88 万 token/s |
| 05 | \(\tau_{opt} = \sqrt{2\delta M}\);33% → 1.9% |
| 06 | \(G = \frac{1 - (T_d + T_r + T_l + \tau/2)/M}{1 + \delta/\tau}\);419 次 / 54 天 |
| 07 | 3 形态 × 5 成因;max logit > 100;回退 100 + 跳 200–500 |
| 08 | step 是否前进;FR buffer 2 万;1 MFU 点 ≈ 4.4 万美元 |
下一步
- 往下:《通信与互联》——2N / 3N 的每一次通信走哪条链路;《PyTorch 深度实践》第 9 篇——DDP / FSDP 的源码
- 往旁:《AI 平台工程》——千卡怎么调度、故障怎么隔离;《RL 后训练 Infra》——训练引擎里再塞一个推理引擎
- 算法侧:《预训练》第 5 篇——配方与稳定性的算法视角
- 原文总纲:
/large-scale-training-from-parallelism-to-fault-tolerance.html;通关自测在系列总结