深度学习基础
从公式到数字,再到模型结构
十篇正文 · 一条连乘链 · 每个结论都能回到原文核对
这个系列回答一个问题
深网络训练中的现象,能否推到公式、代入数字,再用小实验复现?
- 前向方差逐层相乘,反向梯度是 Jacobian 的连乘;因子偏离 1,就会随深度放大或消失。
- 01–10:模型演进 → 损失与梯度 → 稳定训练 → 泛化 → CNN、Embedding 与 RNN。
- 正文 10 篇;第 11 篇是总结与自测。
全景:一条连乘链,十篇正文
%%{init: {"flowchart": {"wrappingWidth": 190}}}%%
flowchart LR
    A["01 演进史"] --> B["02 损失"] --> C["03 反向传播"] --> D["04 激活"] --> E["05 初始化"] --> F["06 优化器"] --> G["07 正则化"]
    E --> H["08–10(下图)"]
全景(下)
flowchart LR
    E["05 初始化"] --> H["08 CNN"] --> I["09 Embedding"] --> J["10 RNN"]
01 · 深度模型演进史:能表示,不等于能学会
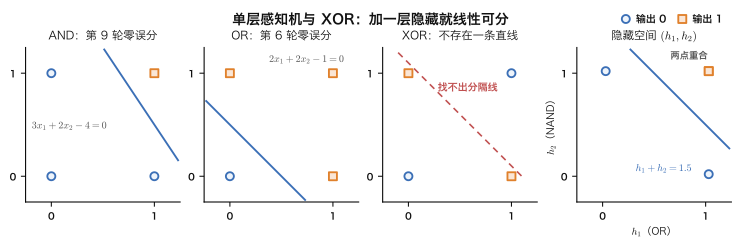
H=4 的 MLP 在 20 个种子上全部解出 XOR;H=2 只有 13/20。
从阈值单元到 Transformer
结构分支并行演进,不是所有深度学习都通向同一终点。
02 · 损失函数:把任务写成可求导的数
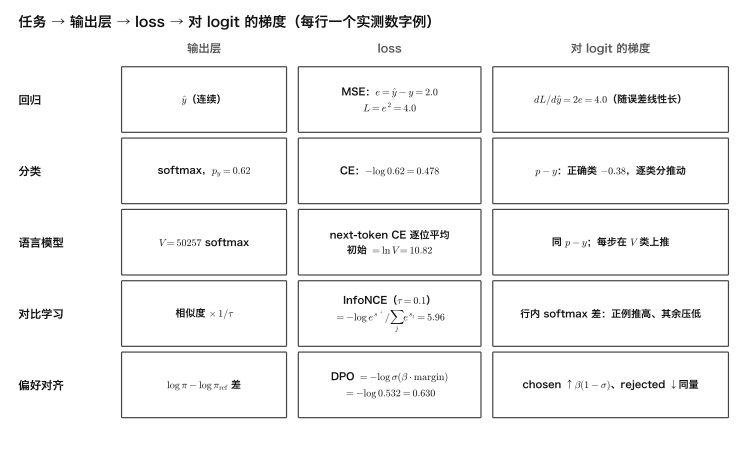
五种任务同一条推导:假设分布→最大似然→负对数(DPO 例:-log 0.532=0.630)
语言模型:下一个 token 的交叉熵
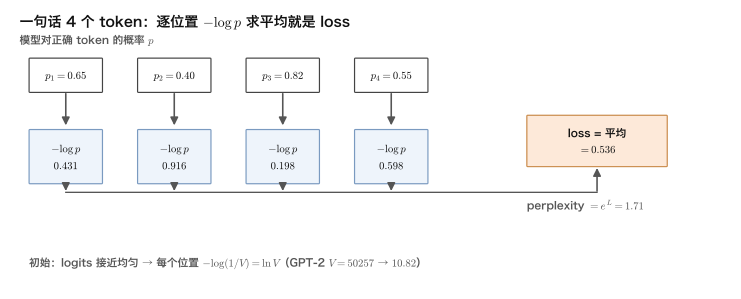
V=50,257 的均匀 logits 实测 CE=10.826,恰好等于 ln V=10.825
03 · 反向传播:逐算子计算 VJP
参数量为 N、训练 D 个 token,前向约 2ND、反向约 4ND,总计约 6ND FLOPs。
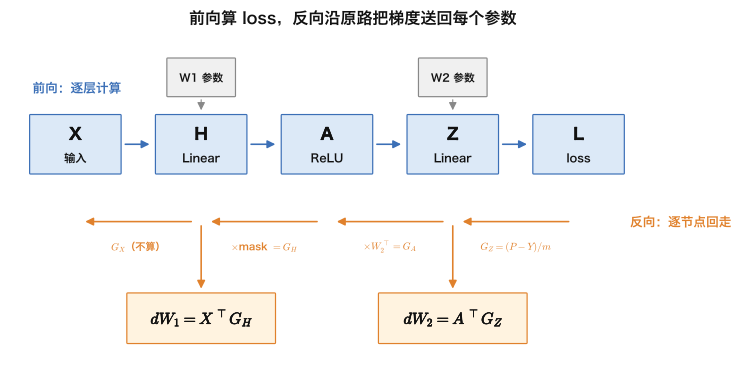
迷你网络:逐层手算每个梯度
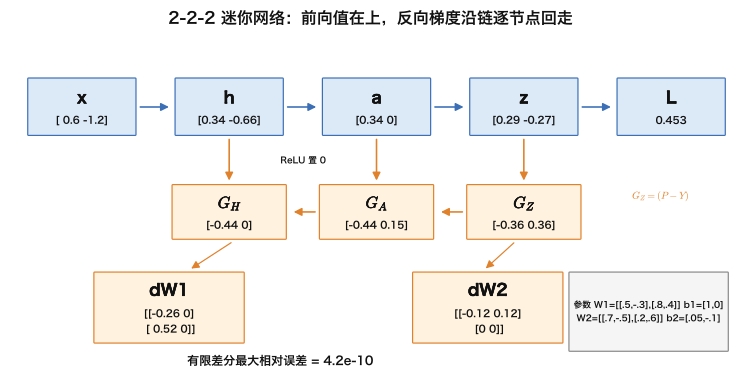
手算的 dW、dX、db 与中心差分核对,最大相对误差 4.157e-10
13 GB 的 Jacobian:只算 VJP
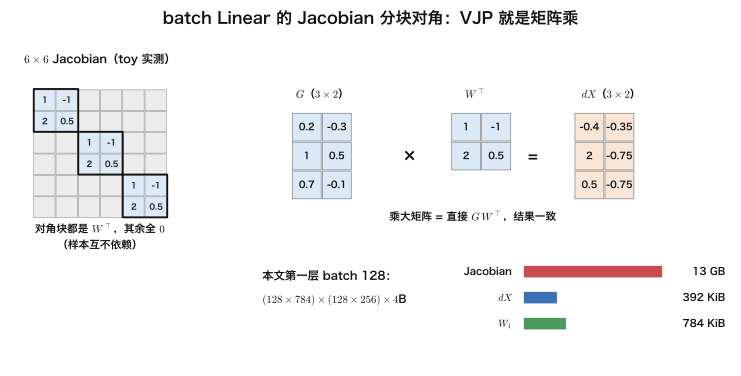
完整 Jacobian 13 GB(3.3×10⁹ 个 fp32),VJP 只需 392 KiB
激活保存与 checkpointing
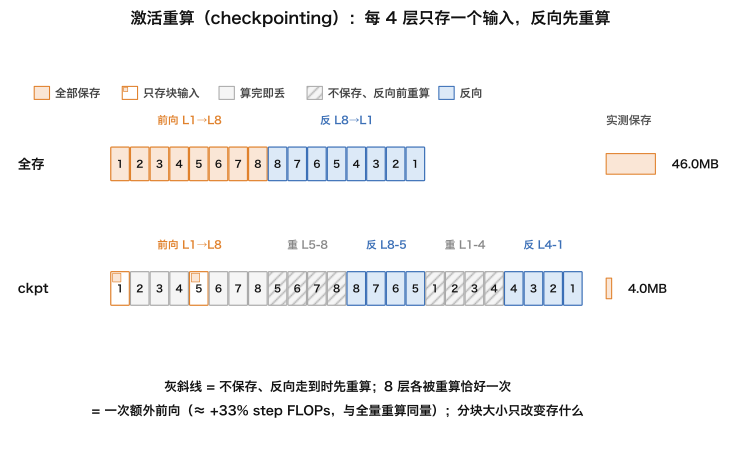
checkpointing 用额外前向计算换更少的保存激活。
04 · 激活函数:非线性也决定梯度能否通过
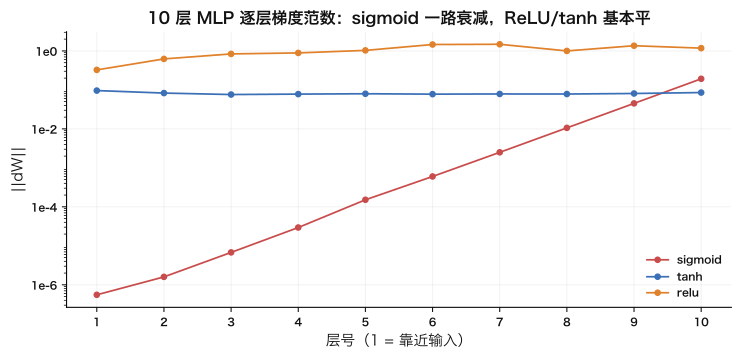
20 层 MLP 上,sigmoid 测试准确率 10.64%,tanh 为 90.48%。
ReLU 的局部导数
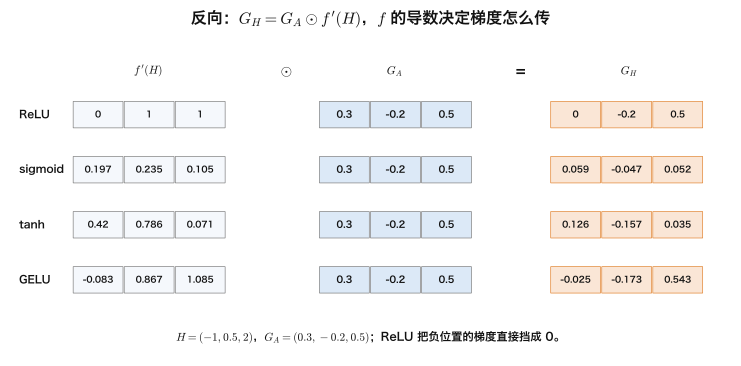
反向传播把上游梯度乘以局部导数;ReLU 正半轴导数为 1。
05 · 初始化、归一化与残差:稳定深层连乘
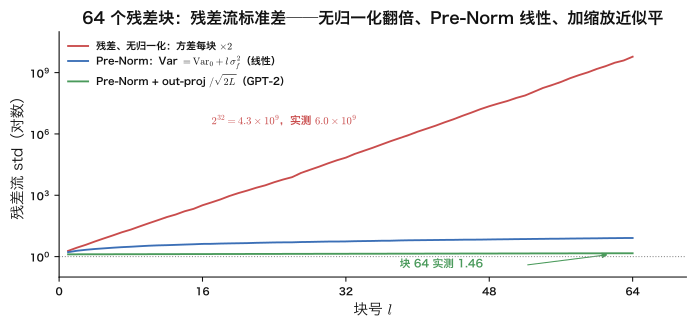
残差流标准差:无归一化第 64 块 6e9、Pre-Norm 8.1、GPT-2 缩放 1.46
残差给梯度一条恒等通路
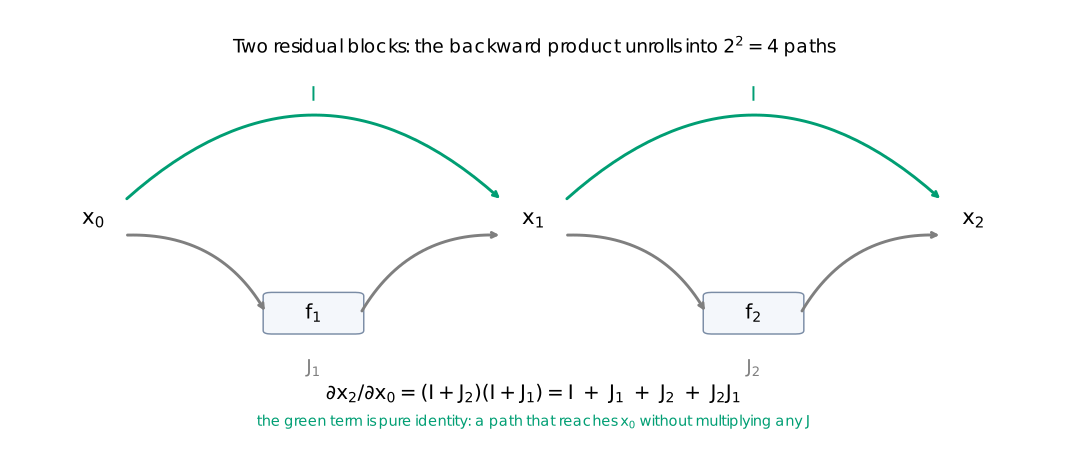
残差把 Jacobian 从 J 改为 I+J;归一化单独不能修复反向连乘。
06 · 优化器:第一步为什么需要 warmup
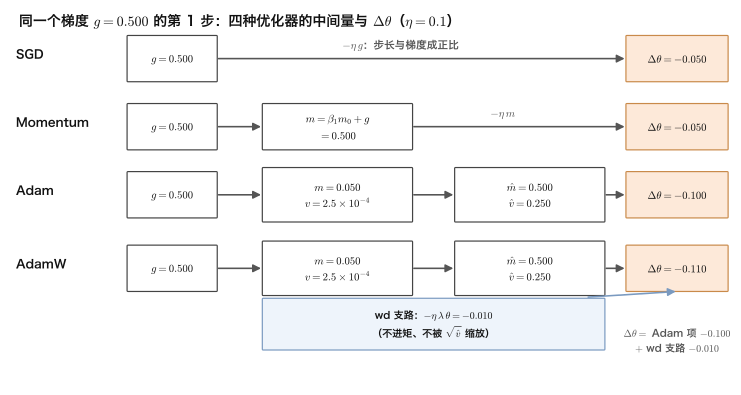
同一个 g=0.5 的第一步:SGD -0.05、Adam -0.10、AdamW -0.11
warmup 改变最初的 loss 轨迹
warmup 将第一次更新的风险从 loss 4.59 降到 1.26。
07 · 正则化与泛化:过参数化不等于必然过拟合
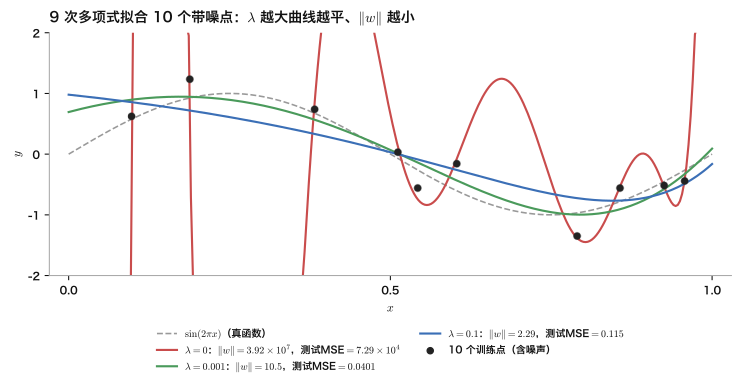
weight decay 将测试 loss 的上升从 0.55 压到 0.42;测试 loss 上升而准确率不变,是过度自信。
Double descent:插值阈值处的测试峰值
宽度 8–16 处测试 loss 从 2.07 冲到 5.48;参数是样本 407 倍时泛化最好。
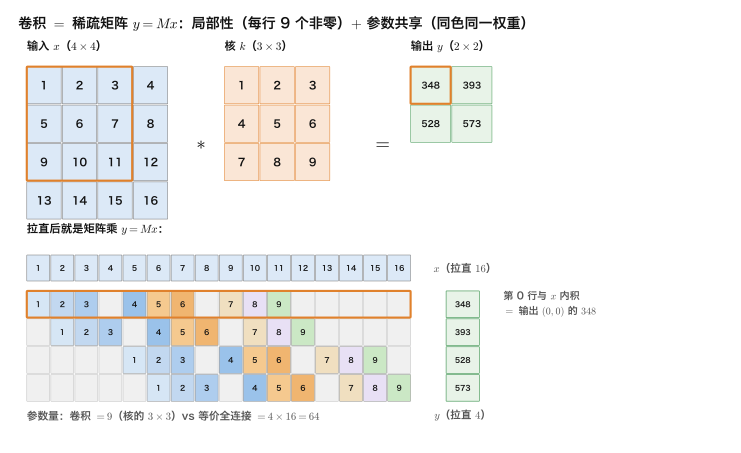
08 · CNN:局部连接与参数共享
6×6 输入上的 3×3 卷积,对应 16×36 矩阵:144 个非零元素、只有 9 个自由参数。
深度扩大感受野
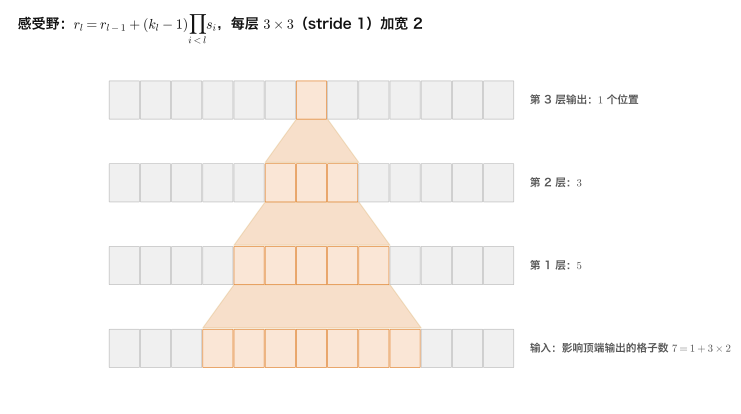
3×3 卷积每增加一层,stride=1 时感受野边长增加 2。
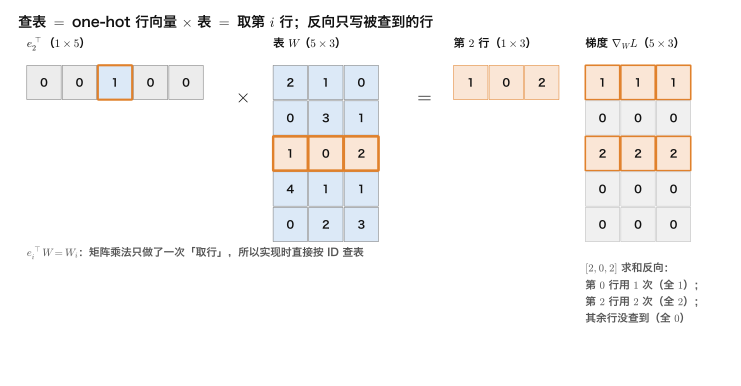
09 · Embedding:one-hot 乘法等价于查表
GPT-2 small 的输入 embedding 为 50,257×768,共 38,597,376 个参数,约占模型 31.0%。
表示由什么信号学到
Embedding 同时回答嵌入什么、用什么训练信号,以及是否依赖上下文。
10 · RNN:BPTT 衰减催生 attention
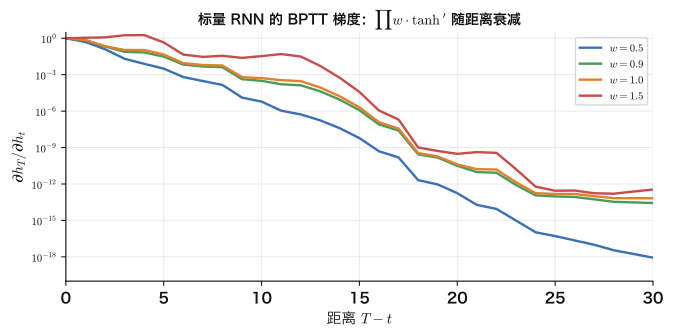
谱半径 0.9 的 16 维矩阵:20 步剩 4.56e-3;谱半径 1.5 时 30 步涨到 17.4
LSTM:沿细胞状态保留梯度
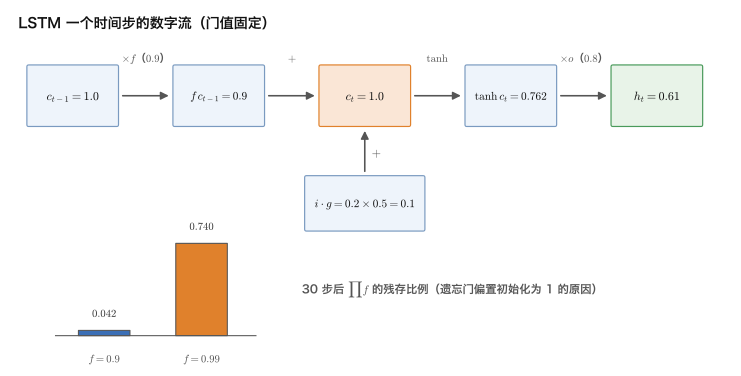
遗忘门偏置初始化为 1 后,20 步和 40 步任务从学不会变为 500 步内学会。
贯穿十篇的线索
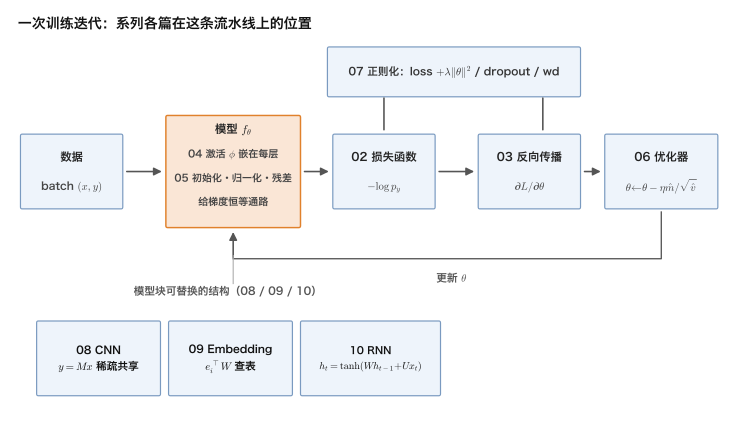
每个模块都要同时检查公式、形状、数值与训练信号。
常见误区
- 反向传播要显式构造 Jacobian——只算 VJP。
- 初始化正确就能保证深网络稳定——它只管训练起点。
- Adam + L₂ 等于 AdamW——前者的衰减会被自适应尺度改变。
- 参数比样本多就一定过拟合——过参数化区间还要看优化器挑出的解。
- Embedding 是 one-hot 的另一个名字——它是按 ID 查得的可学习向量。
- RNN 记不住远处是因为状态太小——关键瓶颈是训练信号传不到。