大模型推理系统揭秘
从动态请求到推理操作系统
十五篇正文 · 一条请求路径 · 一切围绕动态请求、KV 状态与 GPU 资源
这个系列回答一个问题
一个持续生成的请求,如何在 SLO、KV 显存与 GPU 算力之间被系统持续协调?
- KV Cache 是随生成增长的状态;调度的单位是 token。
- 01–15:定义问题、建立指标、逐层拆系统,再用源码和第二个引擎检验分析框架。
- 目标不是最大 batch,而是在 SLO 约束下选择合适的执行规模。
全景:从请求问题到第二套系统
%%{init: {"flowchart": {"wrappingWidth": 110}}}%%
flowchart LR
    A["01 为什么难"] --> B["02 衡量"] --> C["03 请求全景"] --> D["04 Scheduler"] --> E["05 KV Cache"] --> F["06 GPU 执行"] --> NX["07–15 扩展与适配<br/>(下图)"]
07–09:扩展
%%{init: {"flowchart": {"wrappingWidth": 140}}}%%
flowchart LR
    G["07 解码扩展"] --> H["08 Multi-GPU"] --> I["09 PD 分离"] --> J["10–15<br/>(下图)"]
10–15:从适配到形态
后半程回答「一个引擎怎么长成一个系统」——适配模型、变体负载、异构硬件,最后对照同类
%%{init: {"flowchart": {"wrappingWidth": 190}}}%%
flowchart TB
    J["10 模型适配"] --> K["11 multi-LoRA / 多模态"] --> L["12 硬件解耦"]
    L --> M["13 下一站"] --> N["14 源码中的一次请求"] --> O["15 对照 SGLang"]
01 · 为什么 LLM Serving 比传统推理难
Llama-3-70B、8×H100:每 token KV 320 KB、每请求约 734 MB
Prefill 与 Decode 争用不同资源
Prefill 偏计算密集,Decode 偏内存带宽;两者竞争同一组 GPU 资源。
02 · 如何衡量:吞吐、延迟与 Goodput
吞吐算系统做了多少,延迟算用户等多久,Goodput 算 SLO 内有效工作
03 · 鸟瞰 vLLM:4+1 视图落到一次请求
Executor 是引擎内对象:DP 定 EngineCoreProc 数、TP×PP 定 WorkerProc 数
4+1:部署视图
DP rank 各有一个 EngineCoreProc;每个执行 rank 对应一个 WorkerProc。
4+1:token 如何穿过 Serving 栈
跨进程传递的是请求元数据、token IDs 与调度结果,不是完整模型状态。
4+1:一个 token 的回程
主线程立即回到 schedule;序列化走输出线程,detokenize 与 stop 检查在进程 A。
4+1:开发视图与包依赖
包图沿实际 import 展开;csrc 经 CMake / setup.py 编译进 Python wheel。
04 · Scheduler:每轮按 token 推进请求
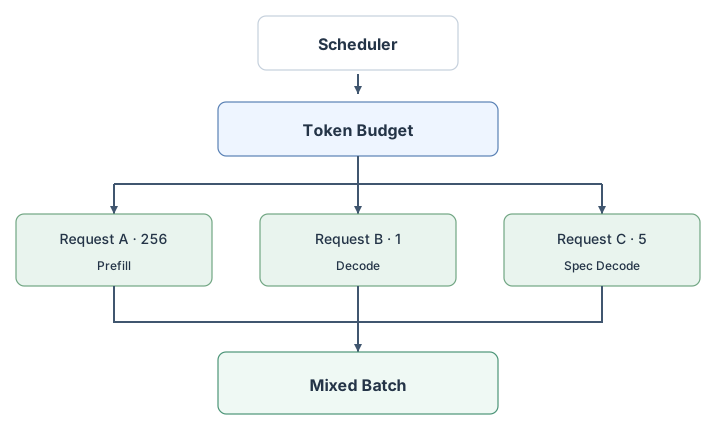
每轮结合 token budget、请求状态与 KV 空间,决定运行哪些请求、每个请求推进多少 token。
05 · KV Cache:管理增长中的状态
block_size=16;2,050 token 占 129 块,Prefix Cache 只复用满块
06 · GPU 执行:减少等待、搬运与轮次
Decode 权重读取下界约 5.3 ms、实测约 10 ms;decode 占总时 97%
07 · 解码扩展:不只改 Sampler
接受长度 2.5、batch 1 时约 2.1×;batch 128 时每步慢 1.9 倍
08 · Multi-GPU:按瓶颈切分模型与请求
TP/PP/EP/CP 解决装不下,DP 解决要更多吞吐且在最外层
09 · PD 分离:状态交接需要明确契约
匹配≠就绪、算完≠可回收;分离换来配置自由与交接成本
10 · 模型适配:变化落在哪一层
模型层管结构,运行时层管调度/Cache/并行,算子层管 Kernel
11 · 请求形态:multi-LoRA 与多模态
8 个 rank-16 槽位静态占 1.44 GB/卡,与实际加载数无关
多模态:图片 token 的 KV 成本
一张图 encoder 输出 9–22 MB,它占的 KV 184–438 MB,约 20 倍
12 · 硬件解耦:Platform 是边界,不是万能胶
核心依赖抽象能力而非具体芯片;OOT 靠主仓库的稳定契约
13 · Serving 的下一站:分布式智能操作系统
四转变:配置→自动计划、缓存→分布式状态、执行→多阶段、目标→Goodput
14 · 回到源码:一次请求的真实旅程
同一请求五笔账:734 MB KV、5 段 chunk、decode 3,000 ms
15 · vLLM 与 SGLang:同一请求,两种状态组织
| 维度 | vLLM v0.27.1 | SGLang v0.5.18 |
|---|---|---|
| 出发点 | PagedAttention:显存碎片 → 块 | RadixAttention:前缀复用 → 树 |
| 调度 | 一个调度器,token 预算,无阶段 | 每 rank 一份调度器,prefill 优先 |
| KV | block hash、block_table |
RadixCache、req_to_token |
| 进程 | SchedulerOutput 跨进程到 WorkerProc | Scheduler 与 ModelRunner 同进程 |
一句话:vLLM 是“一个调度器 + 块”,SGLang 是“N 个相同调度器 + 树”。
两条判断贯穿十五篇
- KV 是一切约束的源头:并发上限、抢占、前缀复用、Decode 带宽与 PD 交接。
- 调度单位是 token:budget、chunk、投机 lookahead 与 encoder 预算都围绕 token 推进。
常见误区
- “最大 batch 就是目标”——目标是在 SLO 下的 Goodput。
- “TTFT 等于 Prefill 时间”——TTFT 包含排队。
- “Prefix Cache 按 token 复用”——复用单位是完整块。
- “CUDA Graph 把 forward 融成超级 kernel”——它重放 kernel 序列,主要减少 launch 开销。
- “投机解码总能加速”——batch 与 draft 负载可能抵消验证收益。
- “图片贵在 encoder”——持续驻留的图片 KV 更大。
下一步
- 系列总结:第 16 篇 /deep-dive-into-vllm-series-recap-and-self-test.html
- 往下:《GPU Kernel 工程》与《通信与互联》——继续看 FlashAttention、PagedAttention、All-Reduce 与 KV 传输。
- 往旁:《扩散模型推理 Infra》与《RL 后训练 Infra》——比较另一种 Serving 工作负载及训练中的推理引擎。
- 回看总纲:/deep-dive-into-vllm.html